2026年的今天,AI绘图工具早已进化到了前所未有的精度。无论是Midjourney V7的超强审美,还是 Nano Banana Pro 的极致的语义理解能力,或是Tapnow AI这类聚合工作流的普及,都给了我们一种错觉:
好像只要扔给AI一张图,它就能完美复刻我的想象。
但现实往往是残酷的。你给了一张完美的构图参考,AI却吐出一张光影崩坏的怪胎;你想要复刻某种胶片质感,AI却连模特的脸都换了。
为什么?因为第一步就错了。
大部分人认为:我给模型一张图,它就应该生成这个结果。 但这其实是人的理解,并不是AI的工作方式。
在AI的视觉编码器眼里,参考图从来不是一张“成品”,而是一堆待解离的高维特征向量。
今天,我们将通过破解三个核心误区,带你深入2026年AI视觉生成的底层逻辑,让你真正掌握参考图的“降维打击”用法。
第一章:误区一——把“参考图”当成“成品目标”
1.1 认知的错位:你看到的VS AI看到的
这是最常见的认知错误。当你上传一张参考图时,你的潜意识在对AI说:“请画一张和这个一模一样的图。”
但在AI的潜空间里,它听到的指令却是:“请提取这张图片中的数学特征,并尝试将这些特征与当前的噪声混合。”
参考图的作用,并不是告诉模型“你要什么成品”,而是“减少它在某个维度上的自由”。
1.2 2026年的“特征拆解”技术原理
在如今的主流模型架构中,参考图在进入生成流程前,会被CLIP或T5等视觉编码器打散。
AI做的只是把图像拆解成可学习的特征:
低频特征: 主要是构图、大色块、光影分布。
高频特征: 主要是纹理、噪点、边缘细节。
语义特征: 比如“这是一个女孩”、“这是一只猫”。
当你直接扔一张图而不加控制时,AI会随机抓取这些特征。可能它抓取了参考图的“构图”(低频),却忽略了你想要的“材质”(高频);或者它抓取了“姿势”,却把背景搞得一团糟。
1.3 正确的工作流:维度锁定(Dimension Locking)
在2026年的工作流中,正确的做法是:先明确参考图负责的维度,让AI先输出特征,再把特征加入到提示词里。
实操演示: 假设你有一张Nike运动鞋的摄影图,你想要它的光影质感,但不需要它的鞋子款式。
错误做法: 直接垫图,Prompt写“一只红色的鞋子”。
结果: AI会困惑,生成的鞋子既不像红色的,也不像参考图里的,光影也乱了。
正确做法:
特征识别: 这是一个“侧逆光、强对比、金属质感”的特征。
Prompt补全: 在文本中明确描述物体结构,让参考图只负责“渲染层”,文本负责“建模层”。
核心金句:
参考图不是许愿池,它是原材料仓库。你必须告诉厨师(AI),你是要仓库里的面粉,还是要仓库里的盐。
第二章:误区二——“既要又要”导致的指令冲突
2.1 贪婪的代价
很多人想通过一张图来复现某种画面:既想要参考图的构图,又想要它的光线,同时提示词里还写得满满当当,详细描述了细节。
你以为这是“充分信息”,是为了帮AI更准确地理解。 但在AI的计算逻辑里,这叫“多模态指令冲突”。
2.2 通道阻塞效应
AI生成图像主要依赖两个通道:文本通道和图像通道。
文本通道: 负责逻辑定义、语义归纳。
图像通道: 负责像素特征、空间关系。
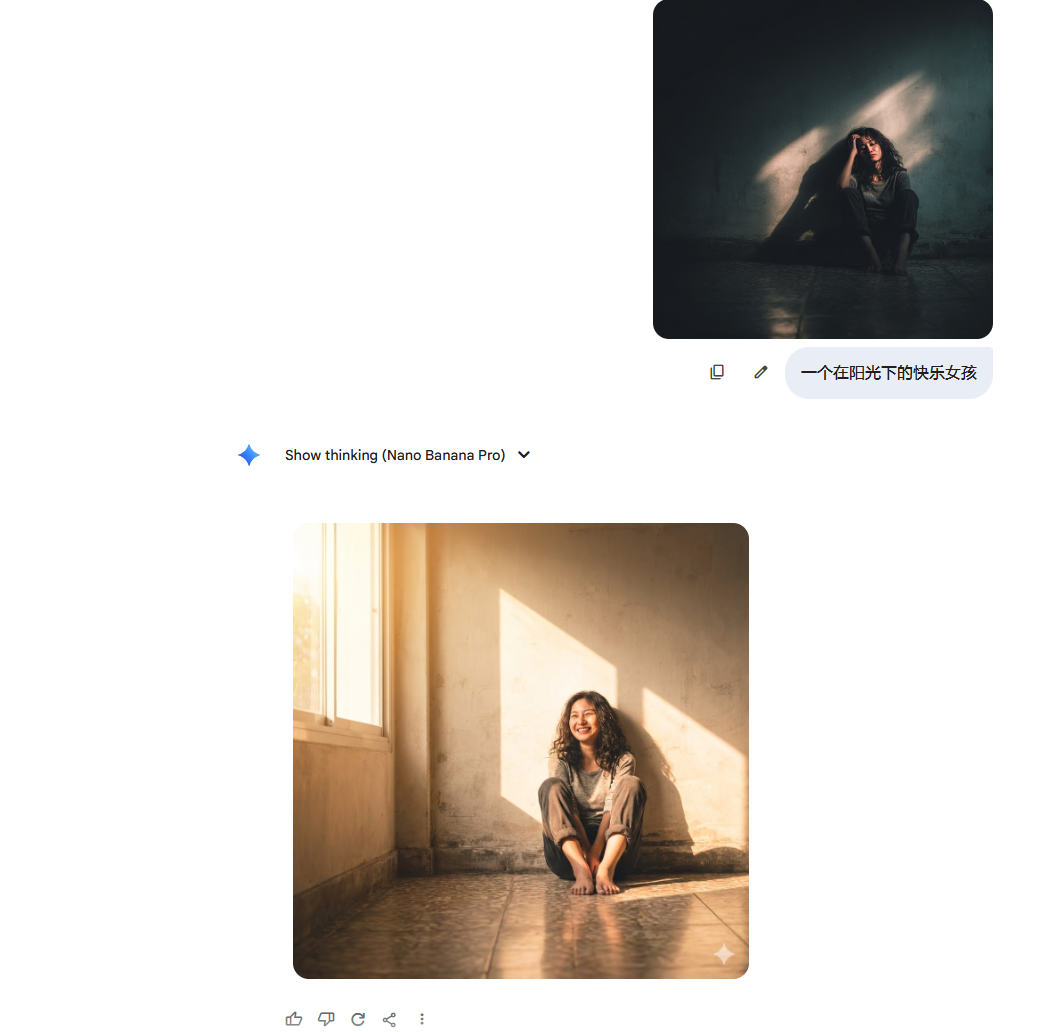
当文本说“一个在阳光下的快乐女孩”,而参考图里是一个“在阴影中的忧郁女孩”时,模型就会陷入“权重震荡”。
在早期的2024年模型中,这会导致画面崩坏;
而在Nano Banana Pro等高性能模型中,它会将俩者结合
2.3 信号噪声比(SNR)与干扰
如果在提示词中过度描述了参考图里已经存在的细节,实际上是在增加“噪声”。
例如,参考图里已经有很明显的“赛博朋克霓虹灯”,你还在Prompt里写了5行关于霓虹灯颜色的描述。这会导致AI过拟合(Overfitting),画面会出现奇怪的伪影、重影,或者色彩溢出。
2.4 正确方法:单点突破,文本留白
正确方法只有一个:明确每张参考图的维度,并在文本中尽量避免干预。
实操案例(针对电商海报生成): 你想要生成一张圣诞产品海报,参考图是一张构图完美的“俯拍餐桌”。
Prompt策略:
保留: 描述产品本身(“一支红色口红”)、描述参考图中没有的元素(“雪花飘落”)。
删除: 绝对不要在Prompt里写“俯拍”、“餐桌布局”、“盘子的位置”。
让文本和图片各司其职,互不干扰,才是高手之道。
第三章:误区三——用参考图弥补文本的无能
3.1 致命的流程倒置
这是新手最容易犯的错误,也是导致工作流效率低下的罪魁祸首。
很多人的流程是:
脑子里有个大概想法。
先去Pinterest或素材站找一大堆参考图。
用一个很模糊、很简单的Prompt(比如“酷炫的跑车”)配合参考图生成。
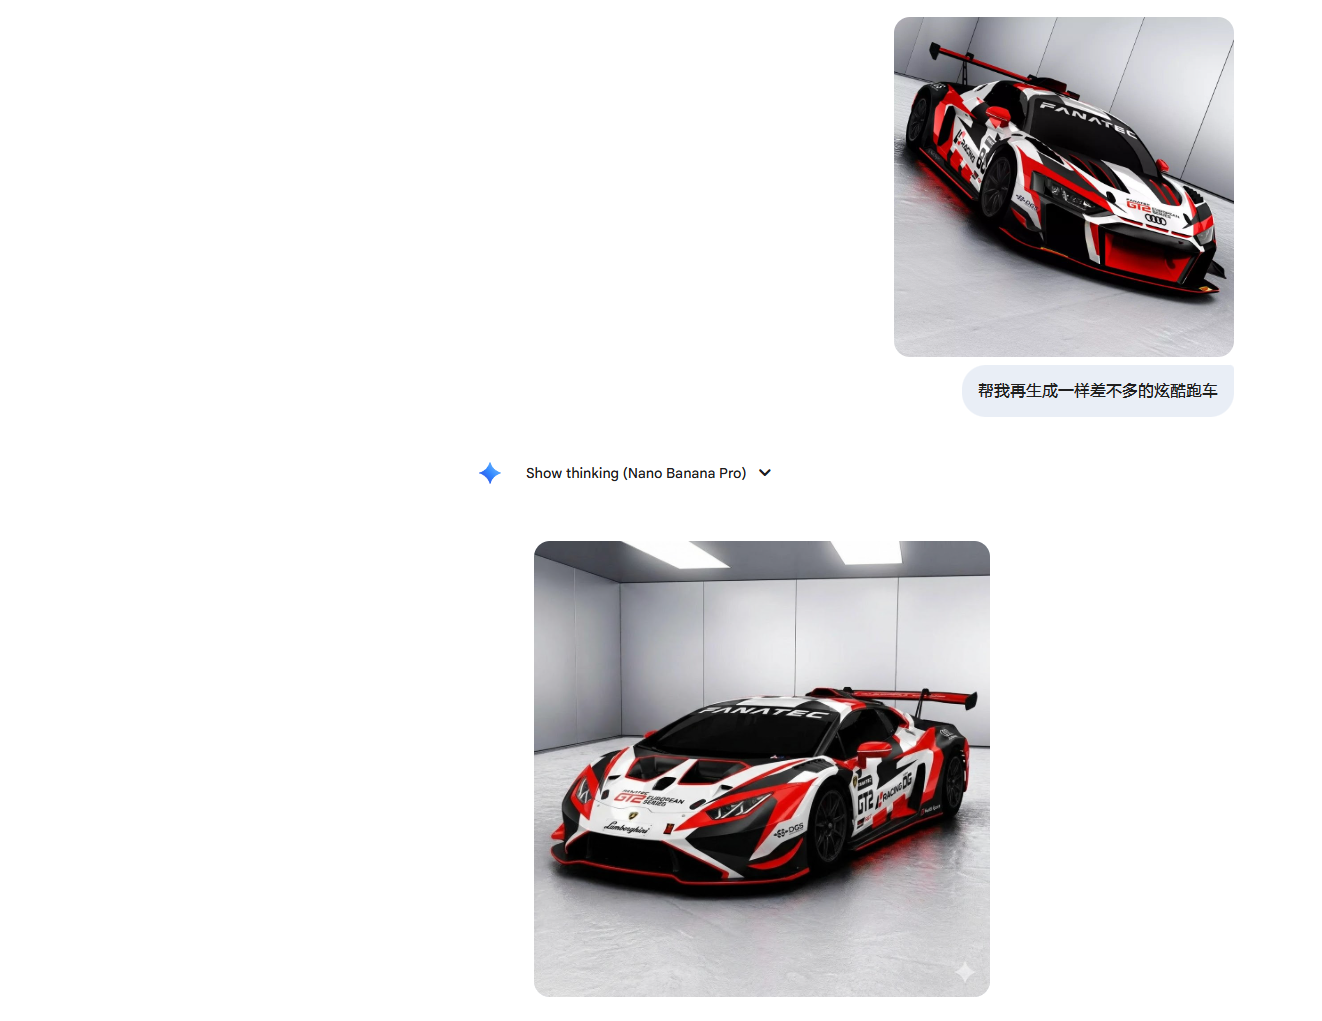
发现不像,换一张图,再生成。
还不像,再换图……
这本质上,是希望参考图替代文本,完成画面的“结构定义”。
3.2 为什么模型不买账?
模型的工作方式是:文本条件决定了生成的骨架,图像条件决定了生成的皮肉。
如果你的文本结构本身不稳定(比如Prompt逻辑混乱、关键词缺失),就像盖房子没有打地基。这时候你不断更换精美的装修图纸(参考图),房子依然是歪的。
更换参考图只会让画面更乱。 因为每次换图,引入的特征向量都在剧烈变化,AI需要重新计算由于文本缺失而带来的巨大随机性。
3.3 先文后图
正确流程只有一个:先用纯文本,把画面结构跑稳定。
Step 1: 盲跑(Blind Run) 不加任何参考图,仅打磨Prompt。
调整构图词(Composition)
调整光影词(Lighting)
调整主体描述(Subject) 直到 Nano Banana Pro 生成的画面在结构上已经有70%符合你的预期(哪怕风格不对,脸不好看,但东西的位置是对的)。
Step 2: 维度注入(Dimension Injection) 这时候,再引入参考图。
如果这时需要风格,就加参考图的风格。
如果需要构图,就加参考图的构图。
Step 3: 微调(Fine-tuning) 只优化一个具体维度。参考图不是用来“增加灵感”的,而是用来收束可能性的。
第四章:总结——深层空间的精准约束
最后,请记住一句话: 参考图的本质不是增加灵感,而是减少“自由度”。
在生成式AI的世界里,由于扩散模型的特性,可能产生的结果是近乎无限的。
Prompt 是第一层约束,筛掉了90%的不相关结果。
参考图 是第二层约束,它像一把手术刀,切掉了“光影”、“构图”或“色调”上的随机性。
真正高质量的结果,不是靠“运气”撞出来的,而是来自对深层空间的精准约束。不要让参考图成为你偷懒的工具,而要让它成为你控制AI的最强缰绳。
拒绝不断叠加参考信息的无效努力,从今天起,做一个懂得“做减法”的AI创作者。
提示词结构执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课的重点不是堆形容词,而是围绕「参考图的“降维”逻辑:如何彻底告别“盲目抽卡”?」把提示词写成能执行、能复用、能检查的结构。
按原文节奏走最稳:先吃透「第一章:误区一——把“参考图”当成“成品目标”」,再把「第二章:误区二——“既要又要”导致的指令冲突」定住,接着处理「第三章:误区三——用参考图弥补文本的无能」;最后用「第四章:总结——深层空间的精准约束」收口。
- 围绕「第一章:误区一——把“参考图”当成“成品目标”」只取局部结构,别整张照搬。
- 这一段别堆词,先把作用分清。
- 围绕「第三章:误区三——用参考图弥补文本的无能」只取局部结构,别整张照搬。
- 先把「第四章:总结——深层空间的精准约束」里的变量写全。
不要只堆形容词;提示词要写清主体、场景、镜头、光线、动作、限制条件和验收标准。
检查提示词是否有清晰主体;是否说明画面关系;是否有可执行动作;是否包含避免跑偏的限制条件。
请围绕「参考图的“降维”逻辑:如何彻底告别“盲目抽卡”?」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:提示词结构拆解、中文提示词、英文提示词、负面限制词、生成后修改建议和自检清单。要求每个词都有明确作用。