
这是2026年的春天,AI生成视频的门槛已经低到令人发指。你打开可灵或者即梦AI,输入一段看似完美的提示词,期待生成一段好莱坞级别的追逐戏。
然而,屏幕上出现的画面却是:主角的手脚像被看不见的线牵扯,走路像滑步,面部表情和肢体动作仿佛在两个不同的时空。
你可能会怪模型不行,怪参数没调好。但数据显示,90%的失败案例,源于你习惯把动作写成“清单”。
我们习惯用人类的线性逻辑去指挥AI:“他先站起来,然后跑两步,接着回头看,最后拔枪。”
但请记住这句话:在AI的眼里,动词并不是“进行时态”,而是一个个静态的“目标状态”。 当你把一堆动词一股脑塞进提示词框时,AI看到的不是剧情,而是互相打架的指令。
今天,结合最新的生成模型逻辑,我们拆解三个核心技巧,教你如何将“动作清单”重构为AI能完美理解的“状态流”。
第一章:拒绝动词堆叠,重塑“运动方式”
1.1 动词的陷阱
很多人写动作提示词时,喜欢像写剧本一样堆叠动词。
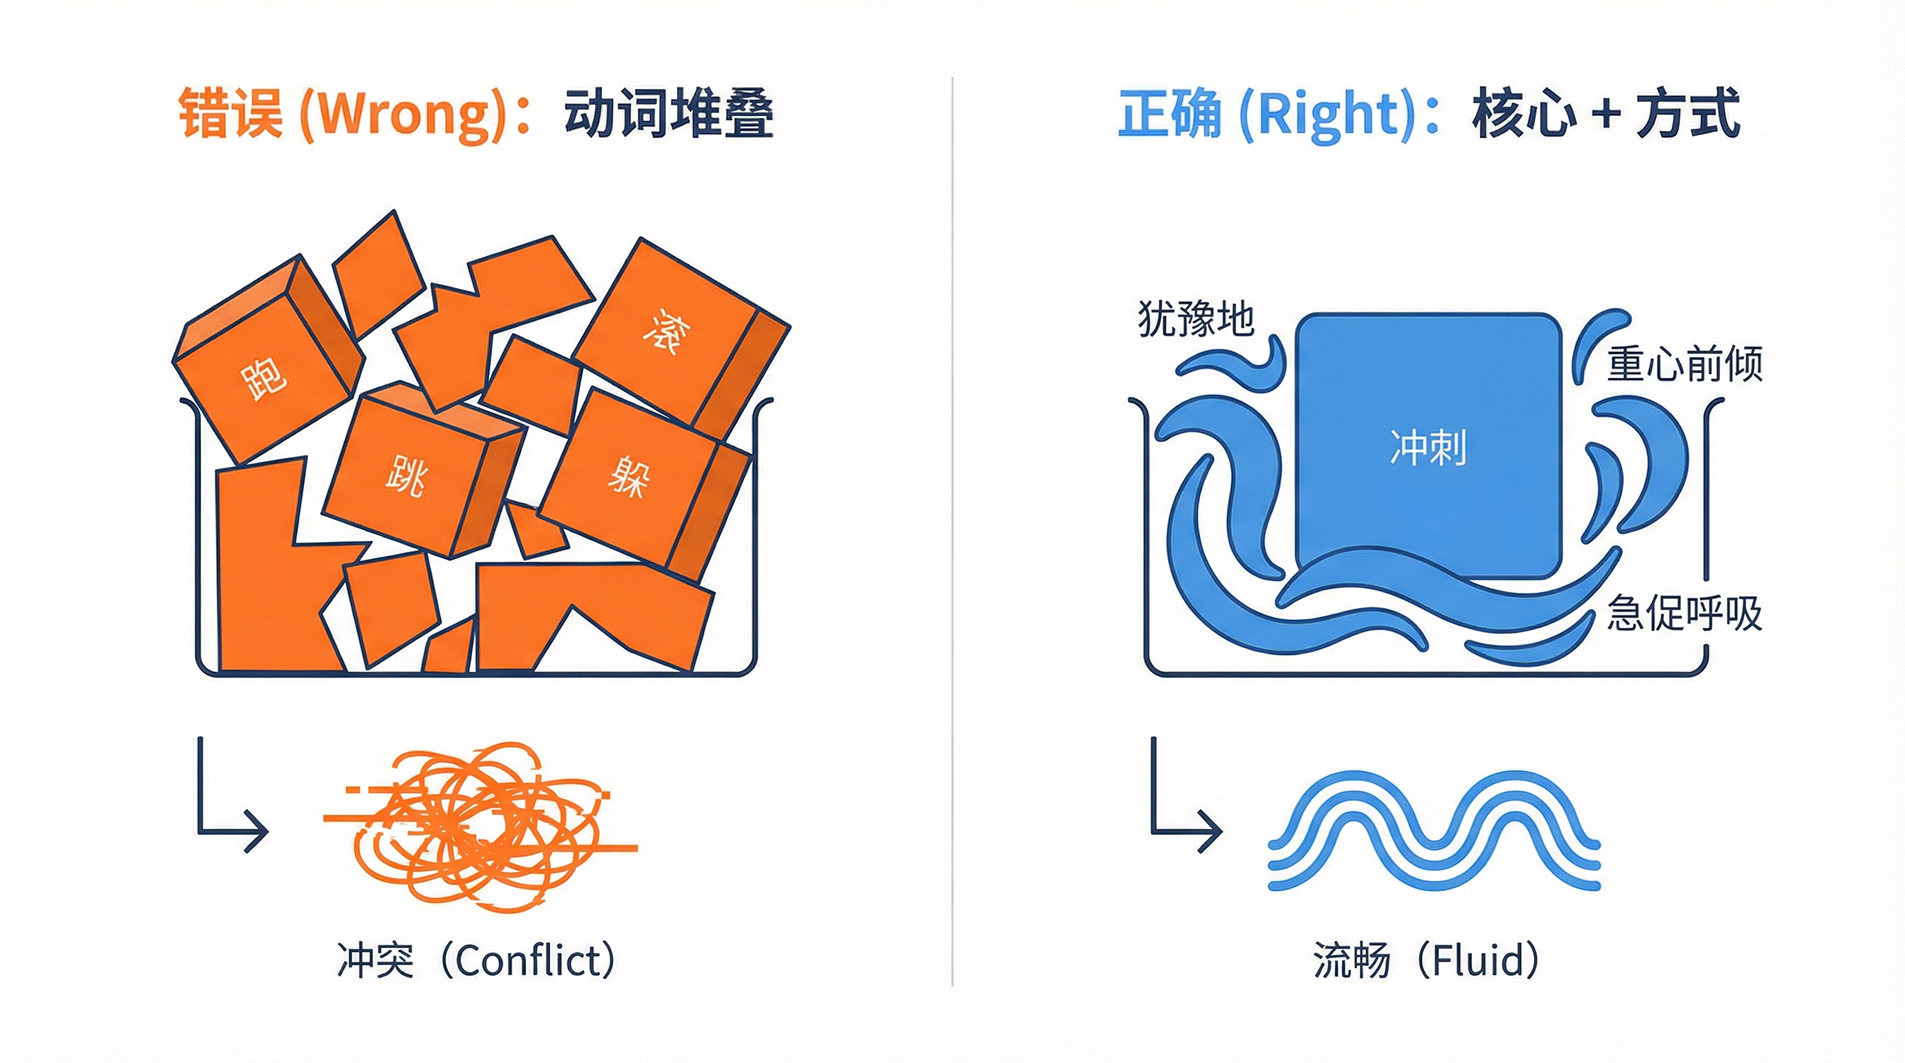
错误示范: "A man runs, jumps over a barrier, and rolls on the ground." (一个男人跑,跳过障碍,然后在地上打滚。)
在可灵或海螺这样的物理模型强劲的工具中,这行提示词会引发灾难。模型会试图在短时间内同时呈现“跑”、“跳”、“滚”的特征,导致人物在空中以一种扭曲的姿态滑行,四肢乱舞。
这是因为“动词”在提示词中往往代表着一种强烈的几何形变。堆叠动词,就是在制造指令冲突。
1.2 技巧一:减少动词,增加“方式词”
正确的做法是:做减法。与其堆叠三个动词,不如保留一个核心动词,然后用大量的方式词去限定它的节奏、重力和状态。
方式词(Manner) 是提示词工程中的黄金概念。它告诉AI“怎么动”,而不是“动什么”。
优化思路: 如果你想表现一个紧张的逃亡过程,不要写“跑、躲避、回头”。 核心动作: Sprinting (冲刺) 方式限定:
Hesitant steps (犹豫的步伐 - 增加节奏感)
Heavy breathing (沉重的呼吸 - 增加身体起伏)
Weight shifting (重心转移 - 增加物理真实感)
Unbalanced momentum (不平衡的动量 - 增加跌跌撞撞的真实感)
1.3 实战案例:Nano Banana Pro 演示
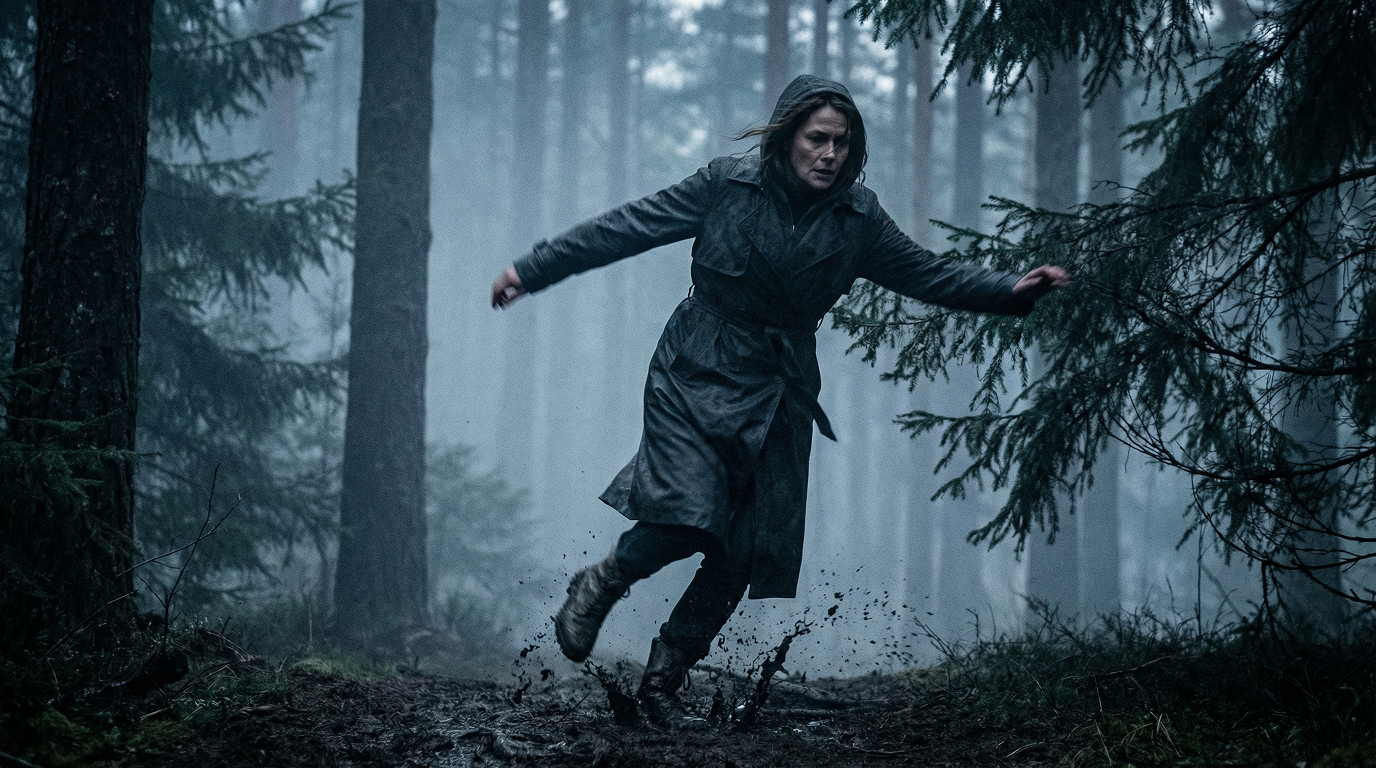
假设我们要生成一段悬疑电影感的森林逃亡视频,这种自然环境对光影和物理碰撞的要求比霓虹灯高得多。
图片提示词:
电影剧照,北欧黑色悬疑风格。一个穿着深色风衣的女人在黄昏时分穿过茂密、多雾的松树林,绝望地全速冲刺。她重心严重前倾(展示“前冲动量”),看起来失去了平衡,在不平坦的泥泞地面上有些踉跄。泥浆在她的靴子周围剧烈飞溅。她的手模糊不清,正在拨开挡路的松树枝。冷蓝色和低饱和度的灰色调。高对比度,厚重的大气雾霭,动态模糊。35mm胶片拍摄,颗粒质感。
视频:
失败提示词
A woman runs fast in the forest.
(一个女人在森林里跑得快。)
(问题:画面通常很稳,但往往像摆拍的游客照,人物是“浮”在背景上的,缺乏速度带来的压迫感。)
成功提示词:
Misty forest context. Explosive sprinting. Body leaning forward at 45 degrees, hair flying horizontally, mud splashing high from boots
解析: 我们只保留一个核心动词Sprinting,然后用物理状态(前倾角度、头发的风向、泥土的飞溅)来强化这个动作。 这就像给AI的物理引擎加了“重力参数”,生成的画面会比简单的“Runs fast”更具电影般的爆发力。
第二章:告别“机械感”,建立动作的主次层级
2.1 身体控制权的“内战”:为什么你的AI像木偶?
现在的视频模型已经很少出现肢体乱飞的低级错误了。但你是否发现,当你生成复杂动作时,人物往往带有一种诡异的机械感?
比如,你想要“一边跑步一边回头看”。 在AI生成的视频里,角色的腿在跑,头在转,但肩膀和躯干却像被焊死了一样僵硬。看起来就像是一个走路模型的上半身,被强行扭到了另一个角度。
这是因为在AI的计算逻辑中,如果你平铺直叙地输入动作,它会试图平均分配算力。它在全力执行“跑”,同时也在全力执行“回头”。
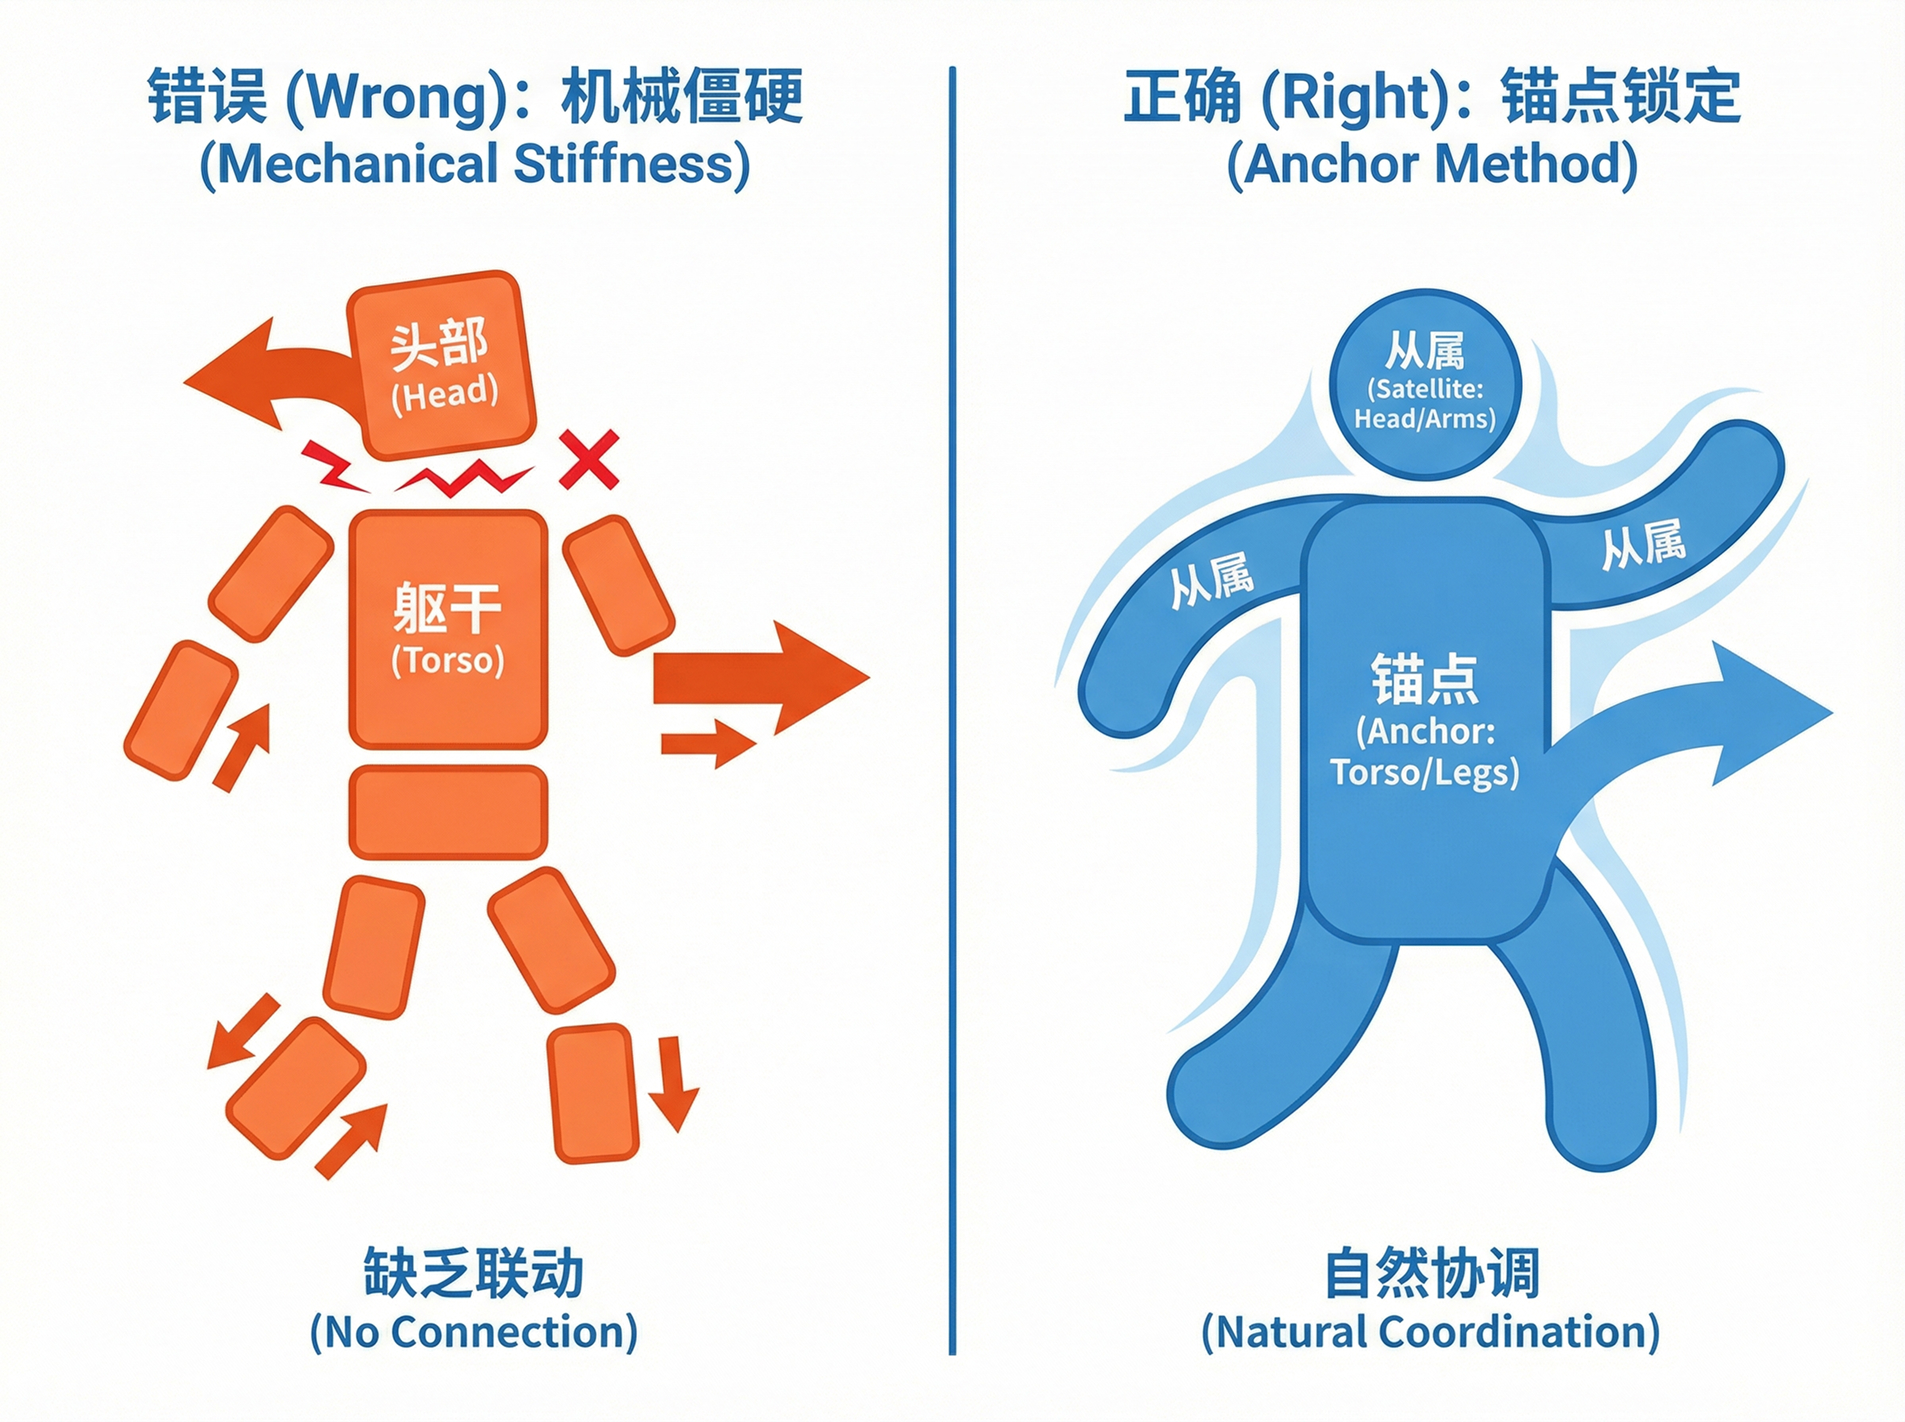
结果就是:身体各个部位“各玩各的”,失去了人类动作核心的整体协调性(Coordination)——这就像提线木偶,提腿的线和提头的线由两个人在拉,动作之间没有肌肉的联动。
2.2 技巧二:锚点锁定法 (The Anchor Method)
要解决“机械感”,必须让AI理解动作的主次关系。
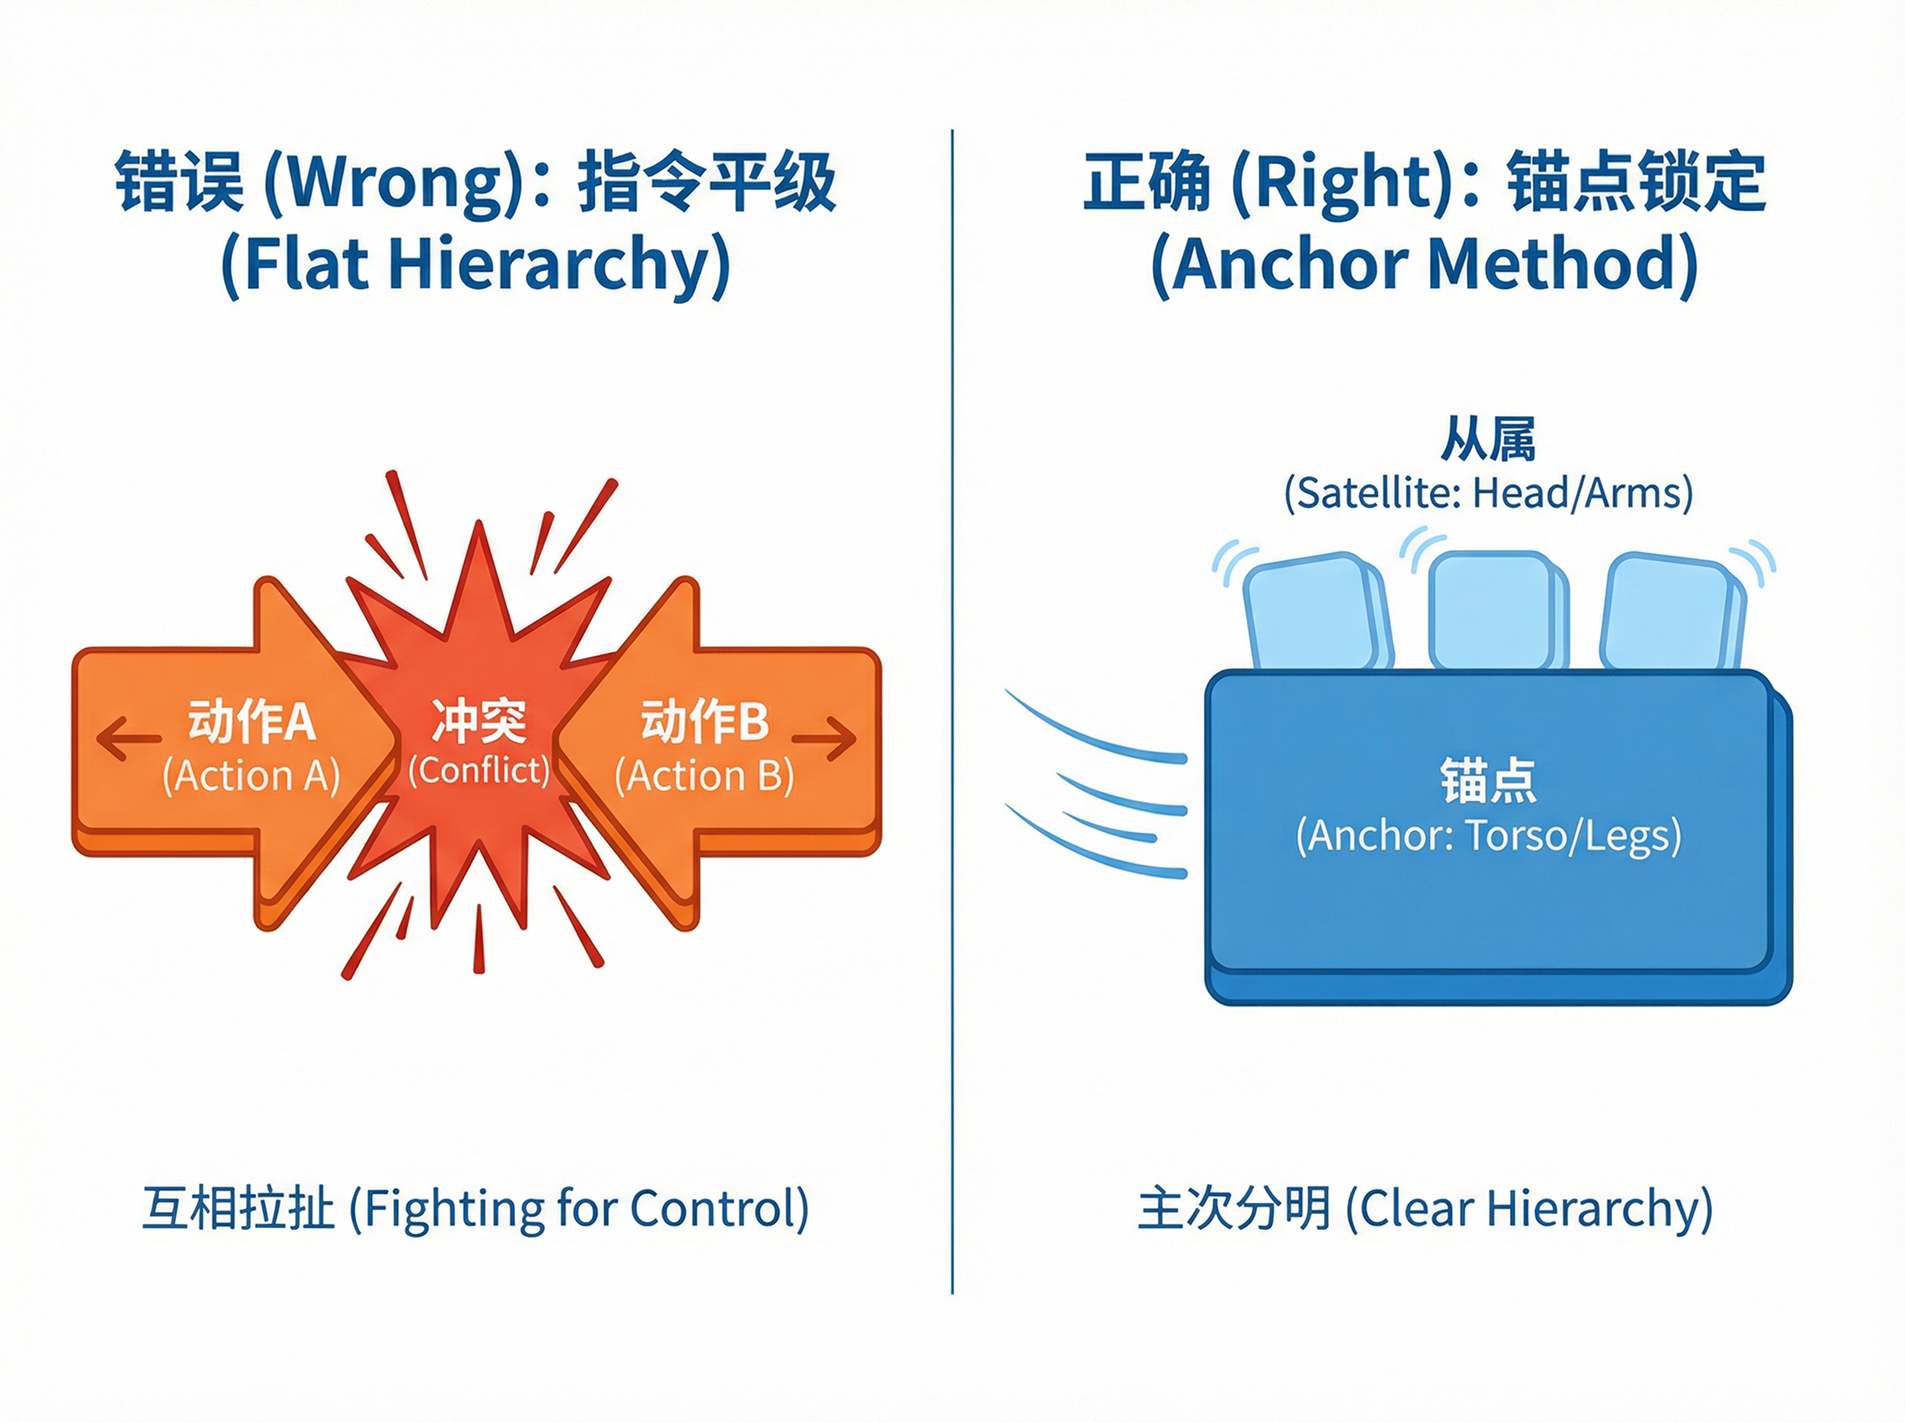
一个自然的动作提示词,必须包含两个层级:
锚点动作 (Anchor Action): 决定身体的物理惯性、重心和整体位移。通常是躯干和腿部的动作(如:Walking, Sitting, Sprinting)。
从属动作 (Satellite Action): 附着在锚点之上的微调。通常是头部、手臂或表情的动作(如:Looking back, Waving, Drinking)。
核心法则: 只有当从属动作顺应了锚点动作的节奏时,画面才会自然。
2.3 实战案例:
我们来做一个经典的电影镜头:“行进间的回眸”。
错误的“平级描述”写法:
A parkour athlete is jumping across rooftops. He is twisting his body sideways. He is tucking his legs up. He is throwing his arms backward. All actions happening at the same time. Sunset light.
AI的理解逻辑: AI收到四个平行的指令:1.跳,2.扭身体,3.收腿,4.甩手。 它会尝试把这四个动作生硬地拼凑在一起。结果很可能是一个身体僵硬地浮在空中,然后手脚摆出对应姿势的“摆拍”画面,缺乏那张目标图片中核心肌群发力带动的流畅感和张力。
正确的“锚点锁定”写法
An explosive, powerful leap forward driven by intense torso twist and core rotation. Satellite Actions Legs tightly tucked in reaction to the jump height; arms thrown back dynamically to counterbalance the rotation . Full body coordinated tension, suspended mid-air.
AI的理解逻辑: AI明白了:“哦,这个动作的老大是‘躯干扭转带来的爆发性跳跃’。为了完成这个老大交代的任务,腿必须收起来(不然撞墙),手必须往后甩(不然失去平衡)。” 这样生成出来的画面,每一块肌肉的走向都是合理的,完美重现了您想要的那张充满张力和协调感的电影级大片。
第三章:打破线性时间,将“顺序”翻译成“状态约束”
3.1 AI没有时间观念
这是初学者最难理解的一点。当你在提示词里写:
"The man eats the cake, then smiles, and finally stands up." (男人吃蛋糕,然后笑,最后站起来。)
你是在跟一个没有时间轴
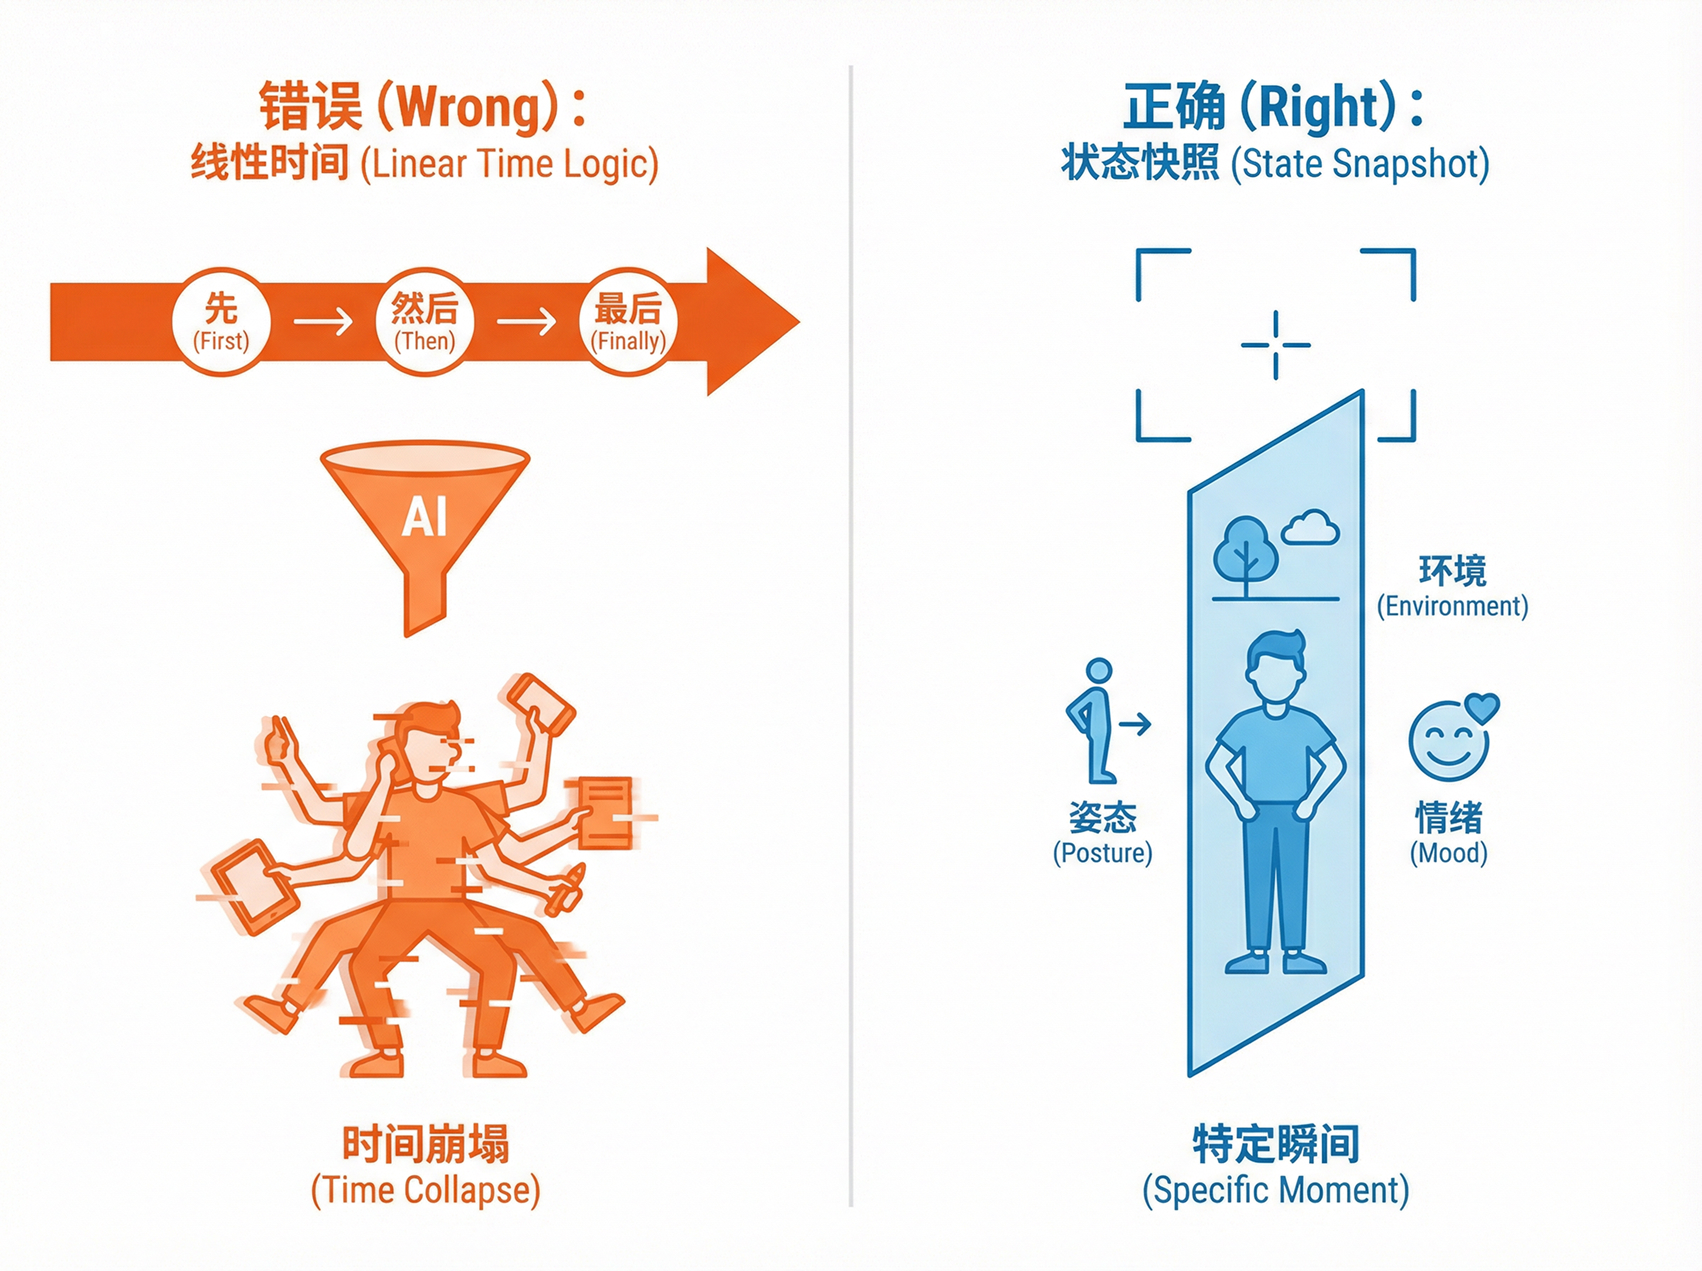
概念的模型谈逻辑。目前的扩散模型和DiT模型,本质上是在生成一段连续的噪声去噪过程,而不是在执行一段脚本代码。
当你用 "Then"(然后)、"After"(之后)这种词时,AI往往会把这三个状态同时融合进画面。结果就是:一个男人嘴里塞着蛋糕,脸上挂着诡异的笑,同时保持着半站半坐的姿态。
3.2 技巧三:状态快照法
与其描述时间的流逝顺序,不如描述动作发生时的特定状态。
AI擅长的是在特定条件下寻找最合理的姿态。我们需要把“剧情”翻译成“场景状态”。
3.3 实战案例:
假设剧本是:主角喝完最后一口酒,把杯子重重砸在桌上。
线性写法:
He finishes the drink, then slams the glass on the table angrily.
状态约束写法(翻译成正在发生的那一刻):
Scene State: The moment of impact. Action: Hand pressing an empty glass firmly against the wooden table. Details: Liquid droplets flying upwards, vibration visible, knuckles white from grip force.Facial State: Teeth clenched, furious eyes.
看出来了吗?我们没有写“喝完”这个动作,而是直接描述了“空杯子”被“按在桌上”这个状态。AI会自动脑补出前后的逻辑——既然杯子刚砸下去,液滴还在飞,那必然是刚喝完。
通过描述Mid-action State (动作中段状态),我们骗过了AI,让它生成了最具张力的瞬间,而大脑会自动帮观众补全前后的连贯性。
第四章:总结
做AI的导演,而不是打字员
当你停止给AI下达类似“先...再...”的僵硬剧情指令,开始像导演讲戏一样,描述角色的状态、情绪的张力、肌肉的紧绷感时,角色的动作才真正开始像“人”。
动作崩坏从来不是随机概率问题,它一定对应着一条写错了逻辑的提示词。
从今天起,检查你的提示词:
动词多吗? 删掉,换成方式词。
主次分吗? 找出一个主动作,其他的做修饰。
有时间词吗? 删掉“然后”,改成描述当下的状态。
掌握了这三点,你就掌握了AI视频生成的通关密码。
视频生成执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课不是先追求炫技成片,而是围绕「AI视频生成的“降维打击”:从动作清单到状态流」先把主体、动作、镜头和节奏稳住。
按原文节奏走最稳:先吃透「第一章:拒绝动词堆叠,重塑“运动方式”」,再把「第二章:告别“机械感”,建立动作的主次层级」定住,接着处理「第三章:打破线性时间,将“顺序”翻译成“状态约束”」;最后用「第四章:总结」收口。
- 先把「第一章:拒绝动词堆叠,重塑“运动方式”」里的主体和动作定死。
- 把「第二章:告别“机械感”,建立动作的主次层级」这一点先定准,再往下走。
- 做完「第三章:打破线性时间,将“顺序”翻译成“状态约束”」后,先查连贯性和穿帮。
- 先把「第四章:总结」里的主体和动作定死。
不要一上来就生成最终片;先拆镜头、定主体和运动,再逐段生成,否则容易跳轴、穿帮、节奏混乱。
检查主体是否稳定;镜头运动是否明确;前后画面是否连贯;节奏是否服务主题;是否有明显变形或穿帮。
请围绕「AI视频生成的“降维打击”:从动作清单到状态流」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:核心创意、分镜表、每个镜头的画面描述、视频生成提示词、剪辑顺序和成片自检清单。要求主体稳定、动作明确、镜头连贯。