虽然像 Nano Banana Pro、即梦等AI工具的语义理解能力已经非常强大,但“空间位置的精准控制”依然是许多创作者的痛点。很多专业教程会教你使用复杂的坐标轴系统或节点工具来规划人物的站位和动作,但这对于零基础或追求高效的创作者来说,学习成本实在太高。
本期教程,我们将回归最直观、最简单的“看图说话”逻辑。通过一种名为“视觉锚点标注法”的无门槛技巧,只需简单的画框和箭头,再配合基础提示词,就能让AI乖乖听话,指哪打哪。不仅能精准控制静态站位,还能完美规划视频中的运动轨迹。
第一章:为什么AI总是不听话?揭秘空间失控的底层逻辑
在解决问题之前,我们先讲一个核心原理:
为什么你写了详细的位置方位描述,AI却很难精确执行?
这其实是由目前主流AI的“扩散模型”底层机制决定的。扩散模型的工作原理,是从一堆无序的噪点中,根据你的提示词一点点“雕刻”出清晰的画面。在这个从无到有的过程中,AI的注意力主要集中在“元素的特征匹配”上(比如画面的质感、人物的脸型、衣服的材质),而不是“空间的绝对坐标”。
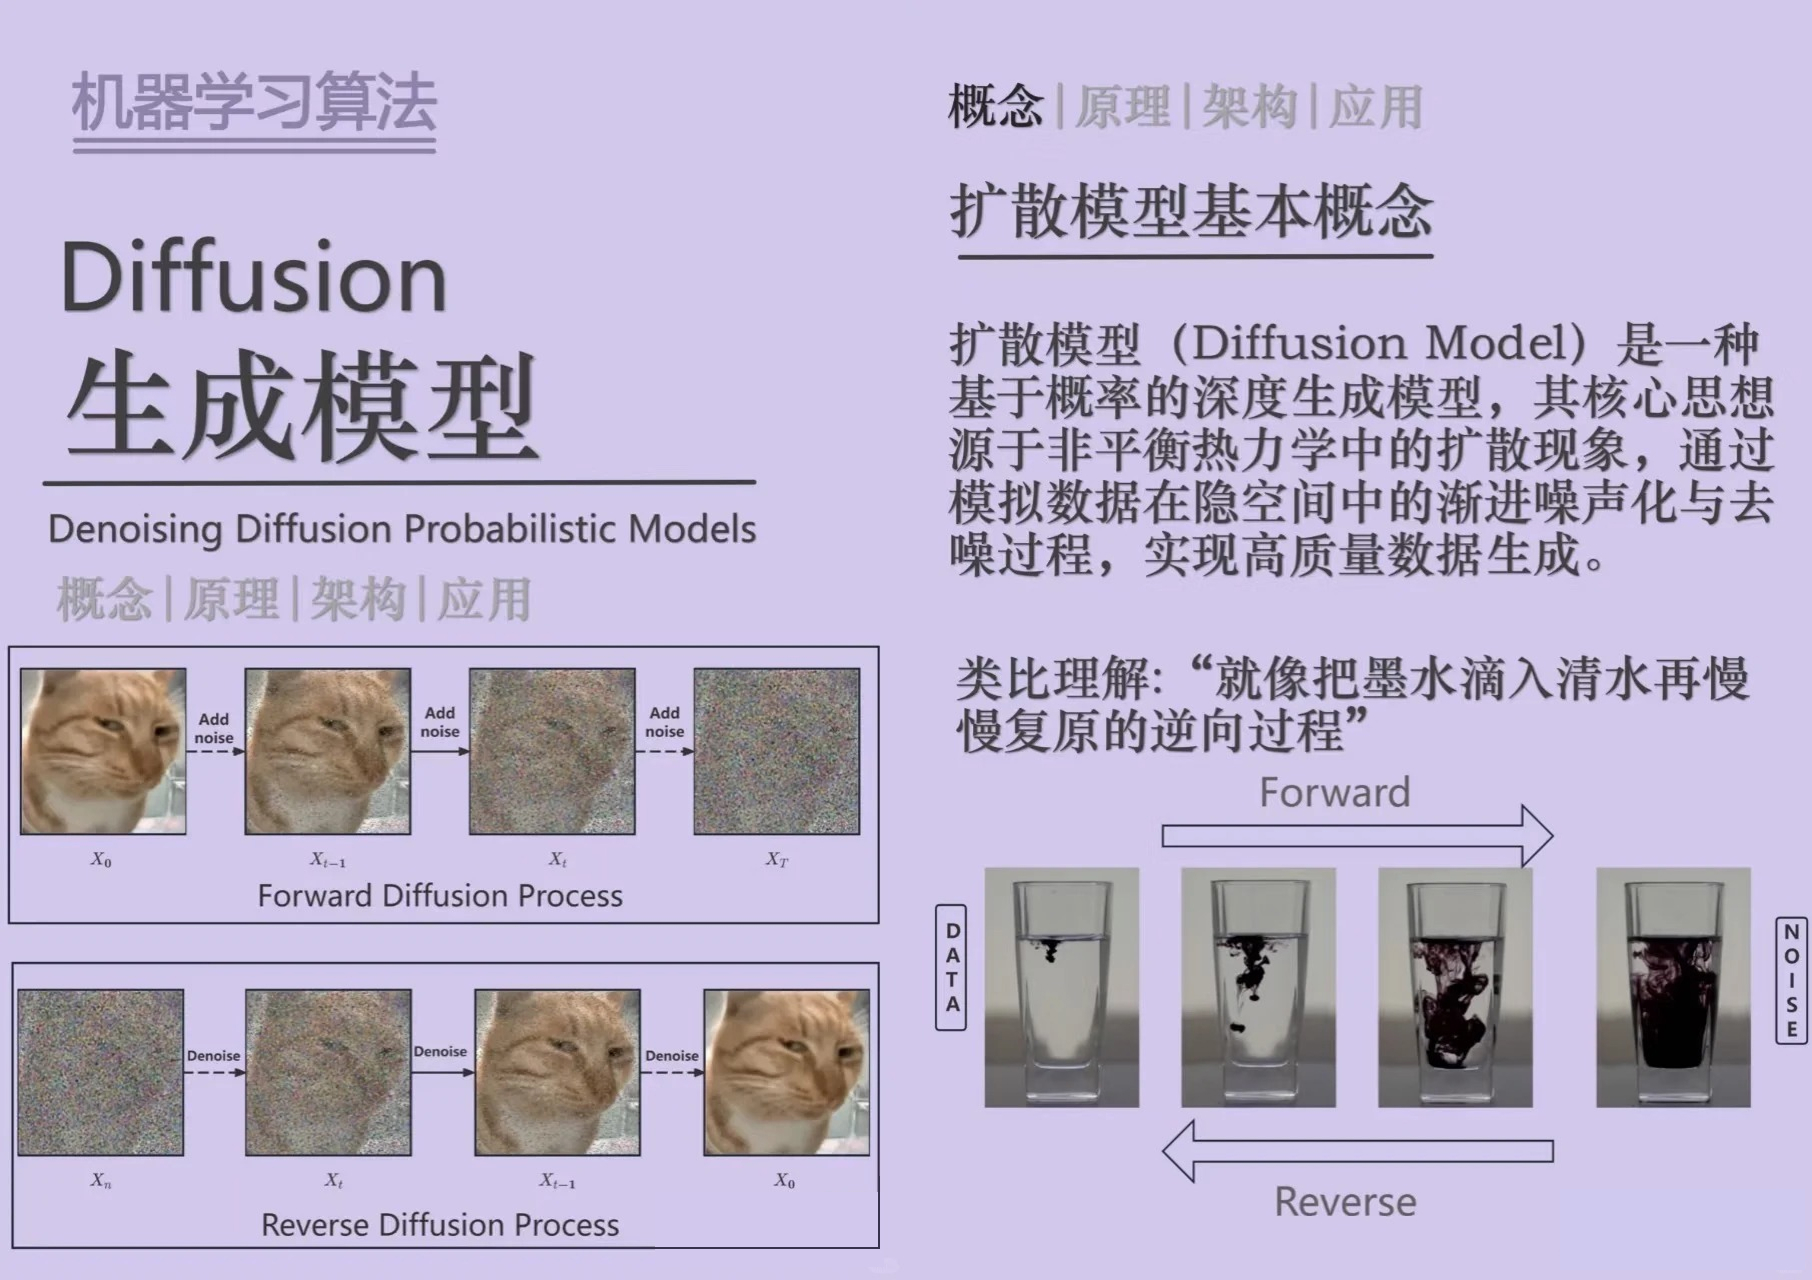
这就导致了一个现象:文本提示词在传递“空间位置”这一信息时,信号是非常微弱的。当你写下“从左向右跑”这种带有强烈空间属性的描述时,AI在降噪过程中很容易将其丢失,或者被其他权重更高的元素描述所覆盖。
因此,单靠写一堆复杂的提示词去约束位置,往往吃力不讨好。我们需要一种比文字更强烈的信号来引导AI
——那就是“图像本身”。
第二章:降维打击——“视觉锚点”控制法原理
既然AI对文字的“空间感知”较弱,我们就直接给它看图。这就是我们今天要掌握的核心方法——视觉锚点标注法。
整个操作流程可以简化为三个步骤,这套方法适用于目前市面上所有支持“图生图(垫图)”或“参考图”功能的AI工具:
1.先造空镜:首先,不加任何人物描述,单独生成一张纯粹的场景底图(空镜头)。
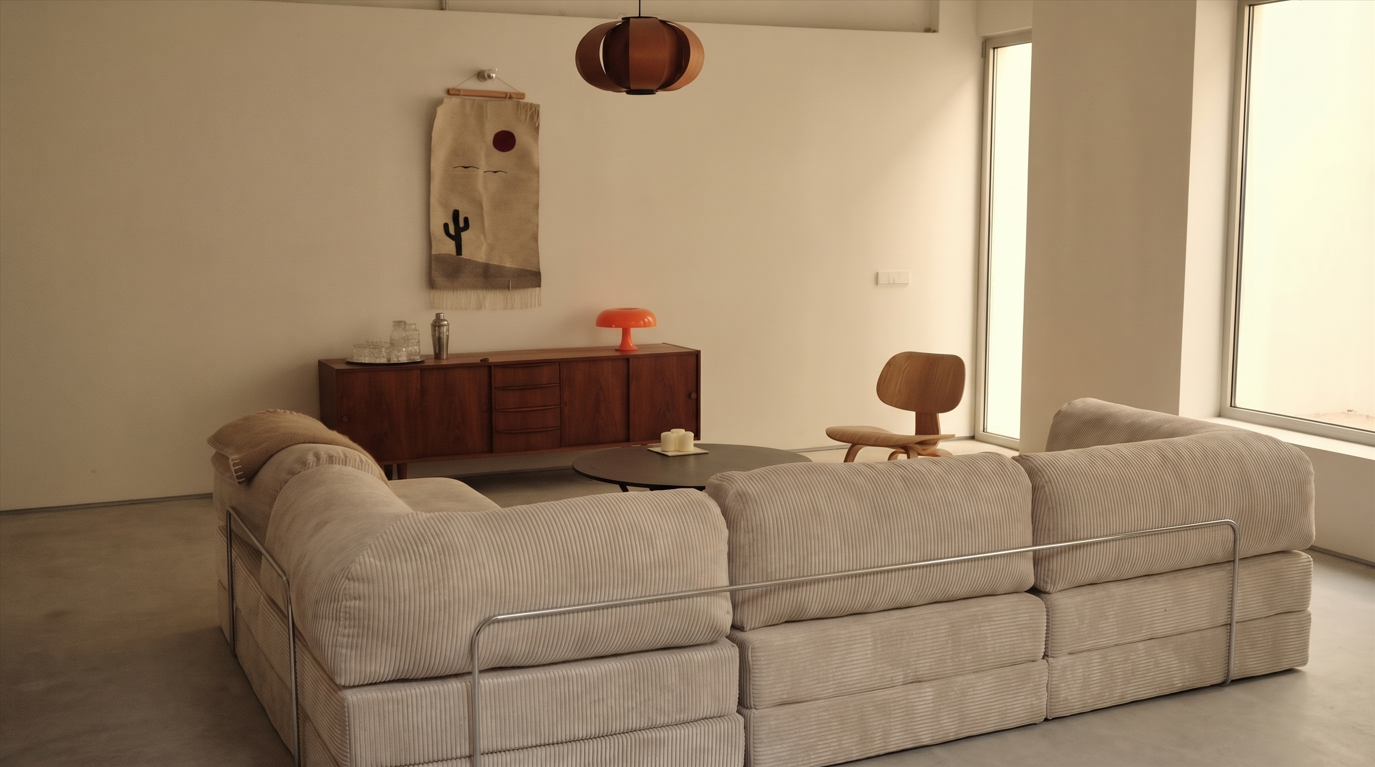
2.人工标记:在这张底图上,使用任何画图软件(哪怕是手机自带的截图编辑工具),用简单的箭头或者选框,粗暴地标出角色的站位或运动轨迹。
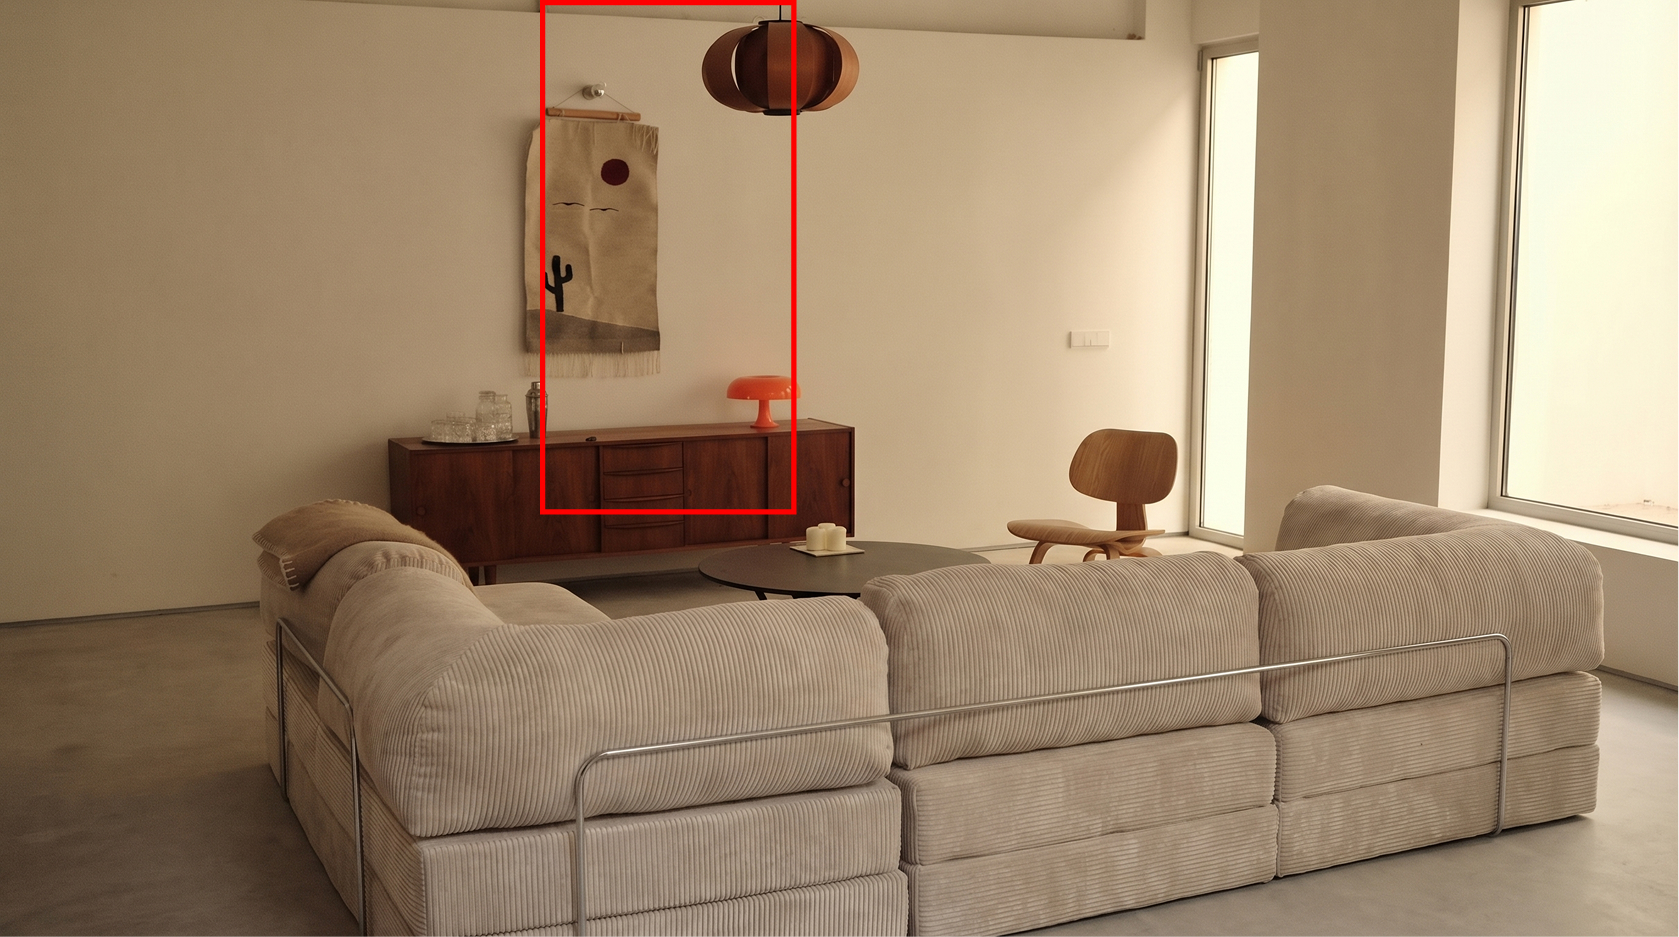
3.带图生成:把这张画了标记的图作为“参考图”还有你的人物形象喂给AI。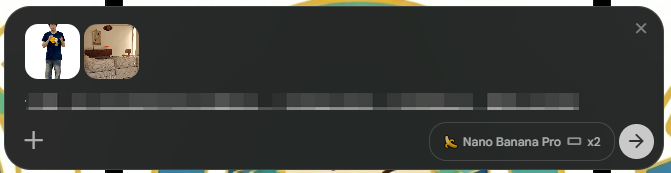
输入提示词:
让图一的人物在图二标注位置倒立 ,光影融合自然,与背景融合,随后去掉红框
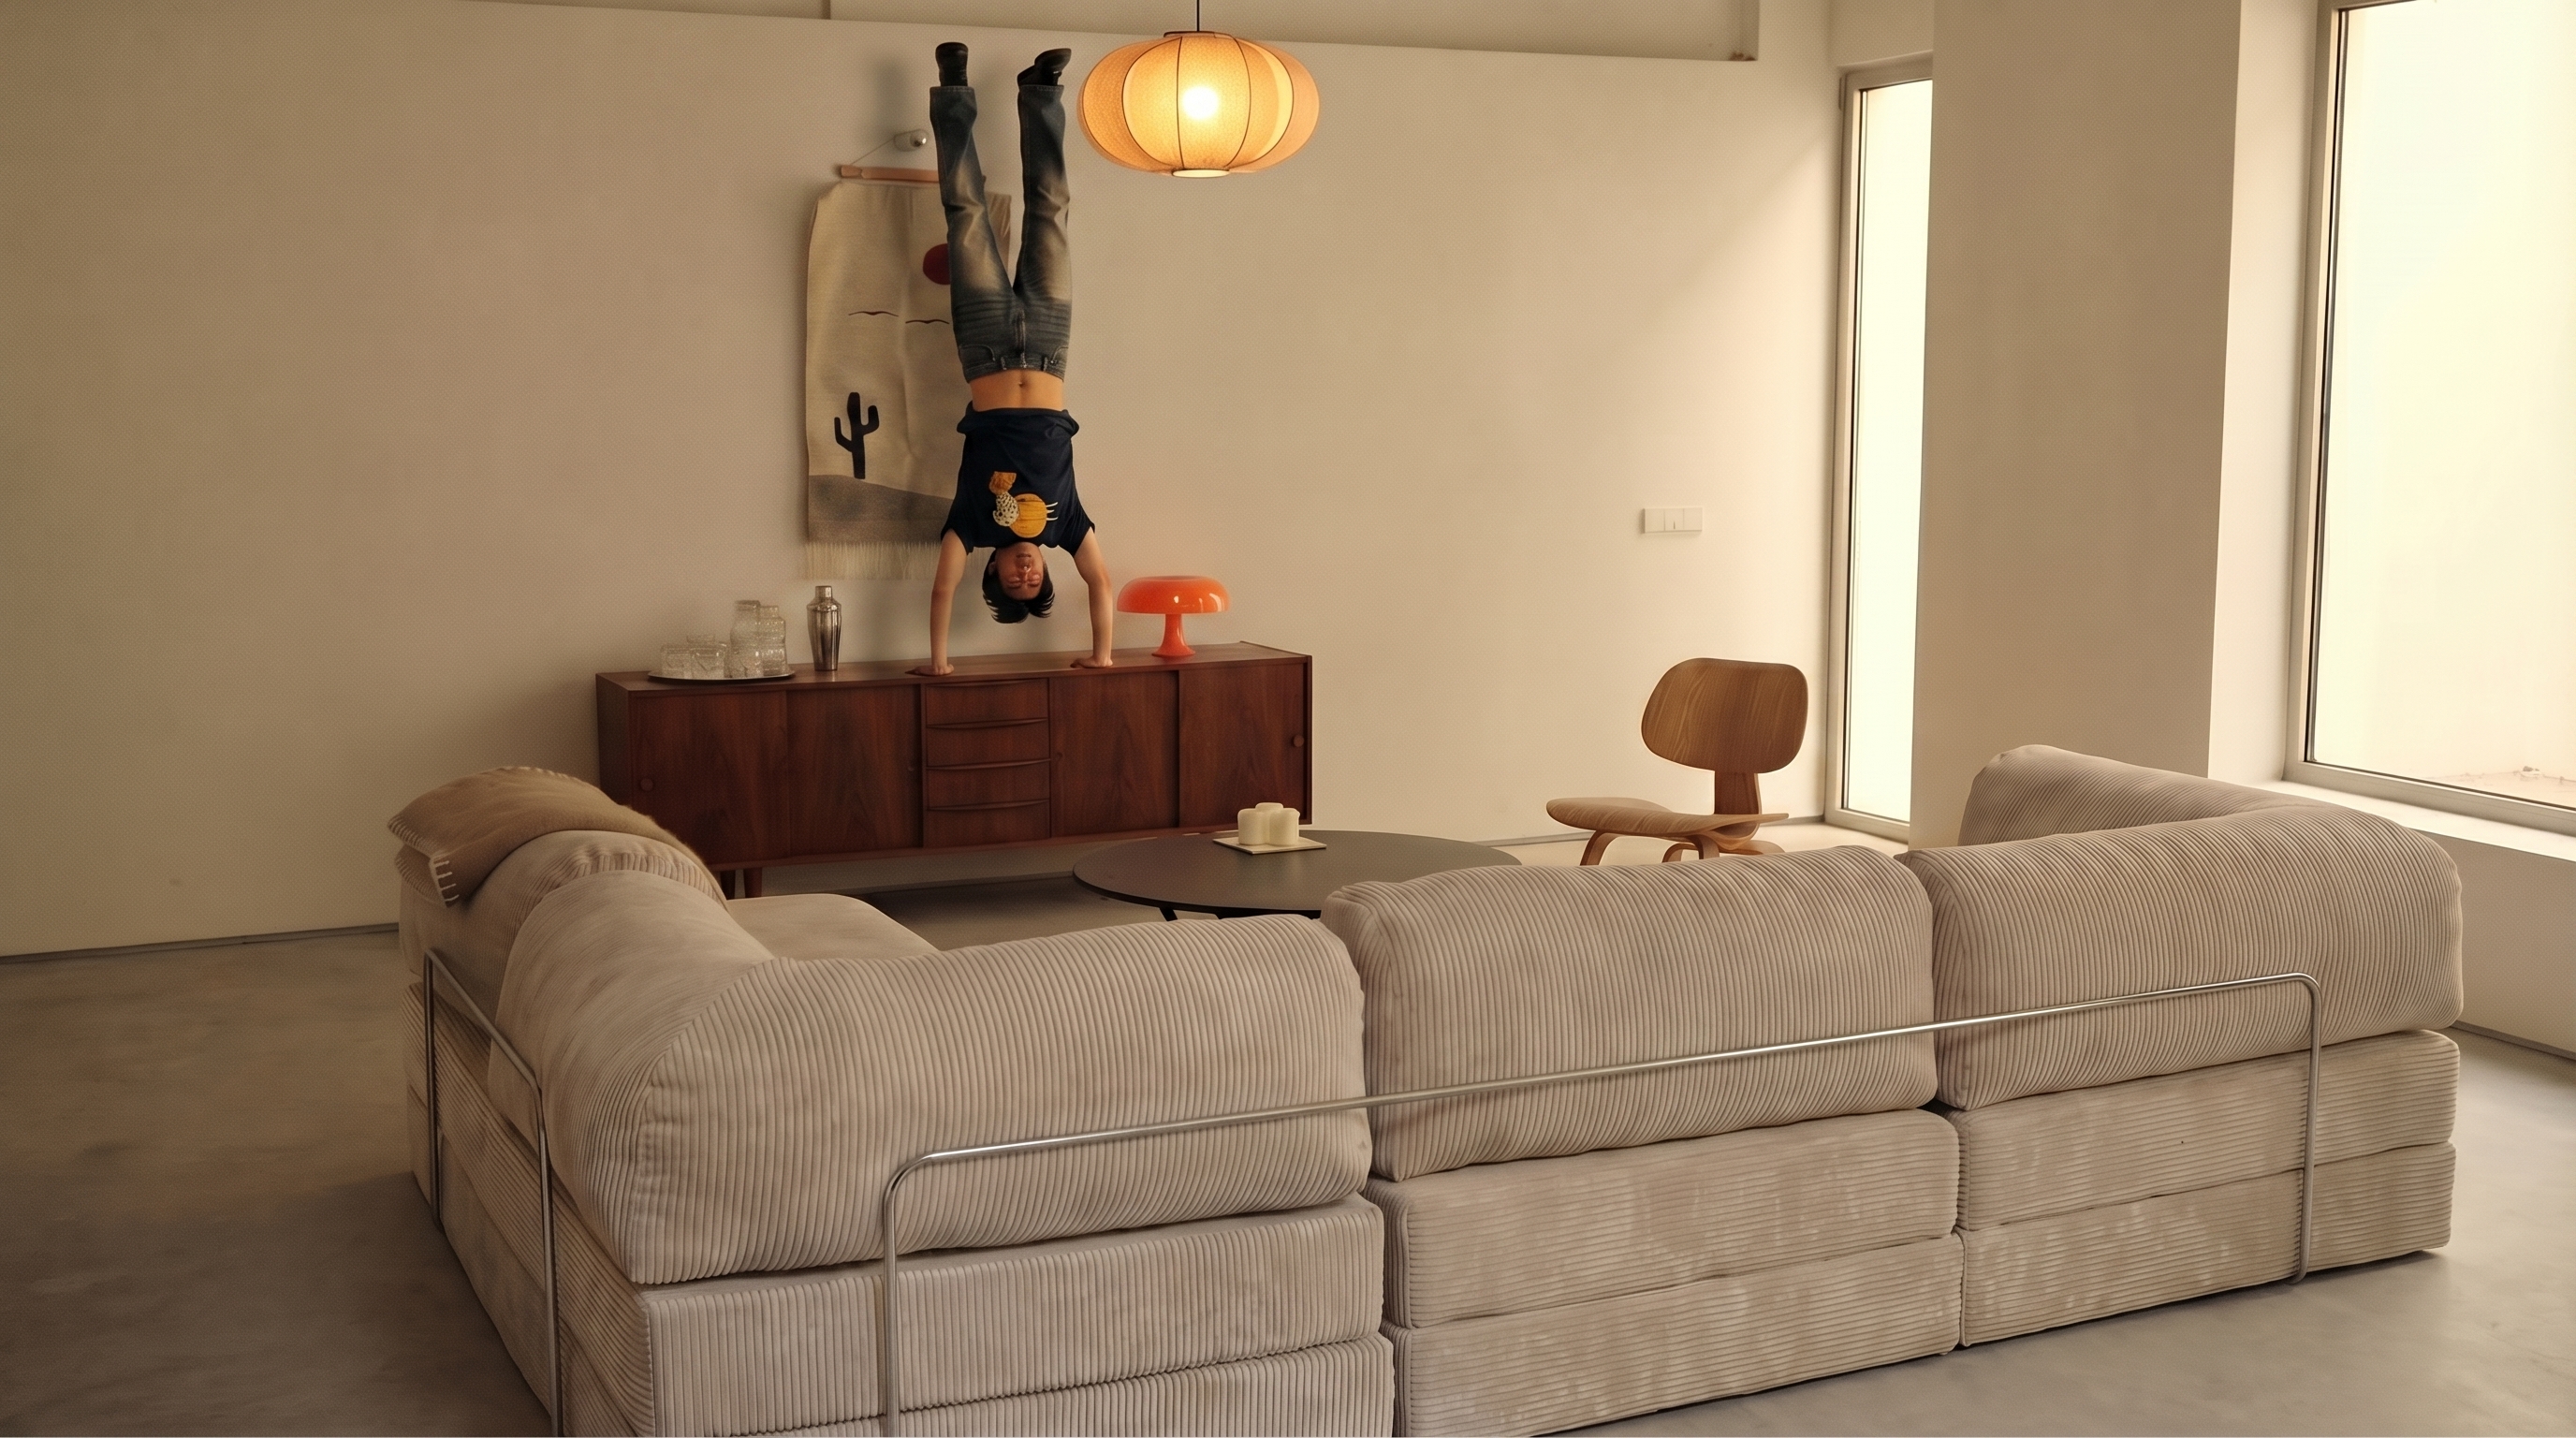
这种方式的降维打击在于:你用图像的物理像素,强行锁定了AI生成的兴趣区域。这比你写一万字的位置提示词都要精准得多。
多人复杂站位的精准控制
如果画面中需要出现两个或更多的人,且他们有不同的特征和站位,该怎么办?如果只是简单地画两个一样颜色的框,AI很可能会混淆
我们需要使用不同颜色的选框或色块。
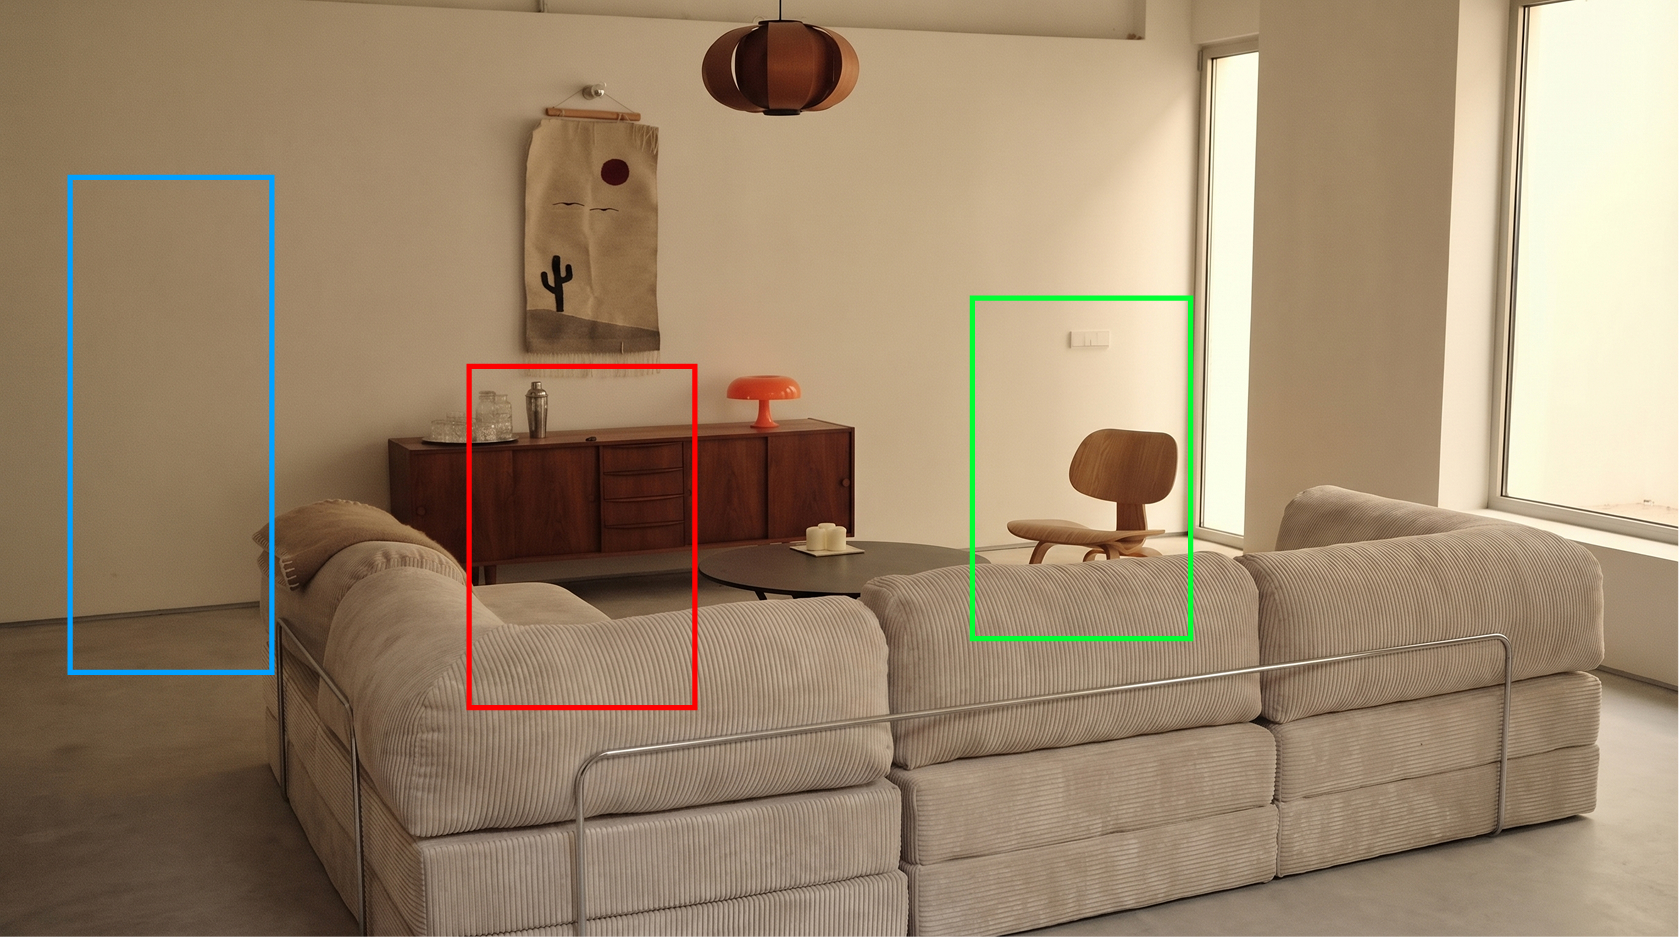
在输入提示词时,你需要明确告诉AI,哪个颜色代表谁:
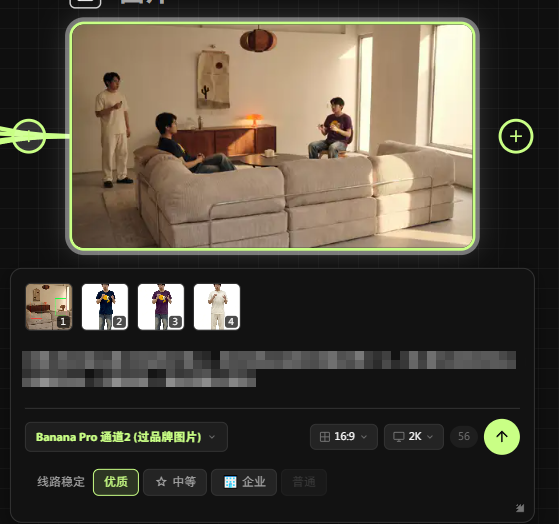
提示词:
将图2角色坐在图1红框的沙发上,图3角色坐在图1绿框的椅子上,图4角色自然的站在蓝框图1处,光影重构,最后需要去掉框
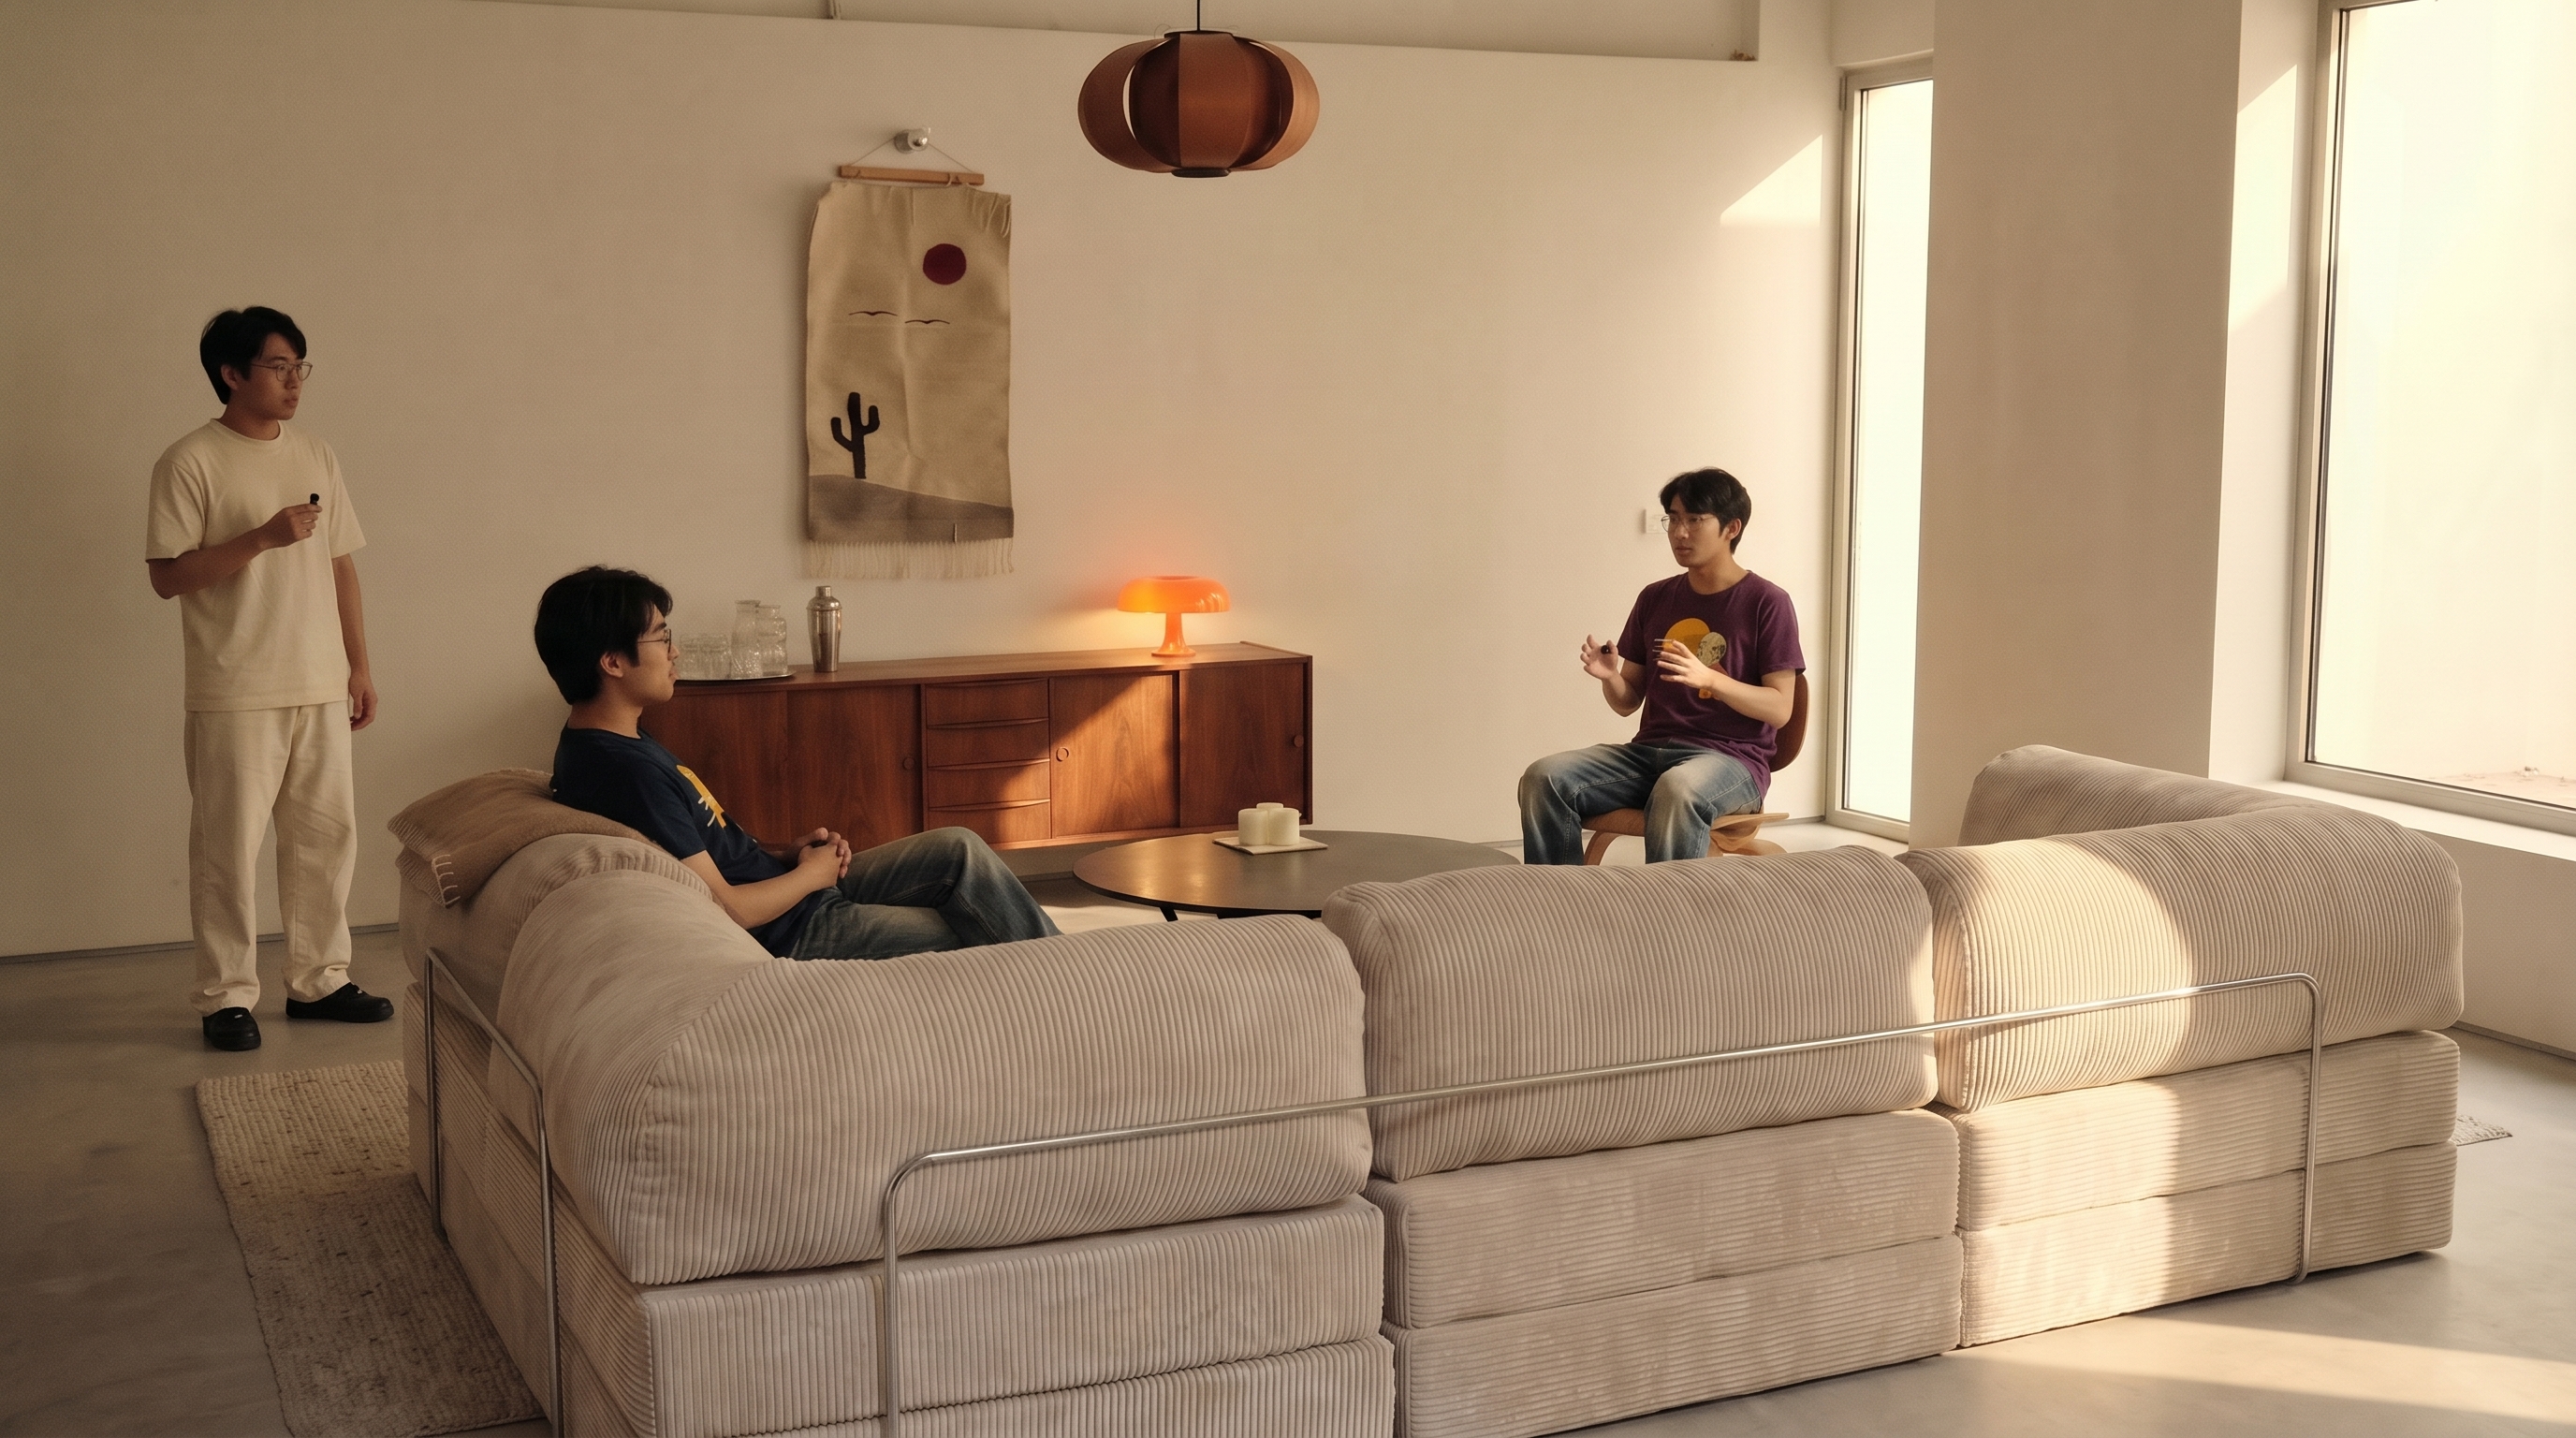
第三章:视频生成——让角色按轨迹运动
第一步:标出运动轨迹
在生成好的空镜底图上,直接在图上标出人物的运动轨迹。
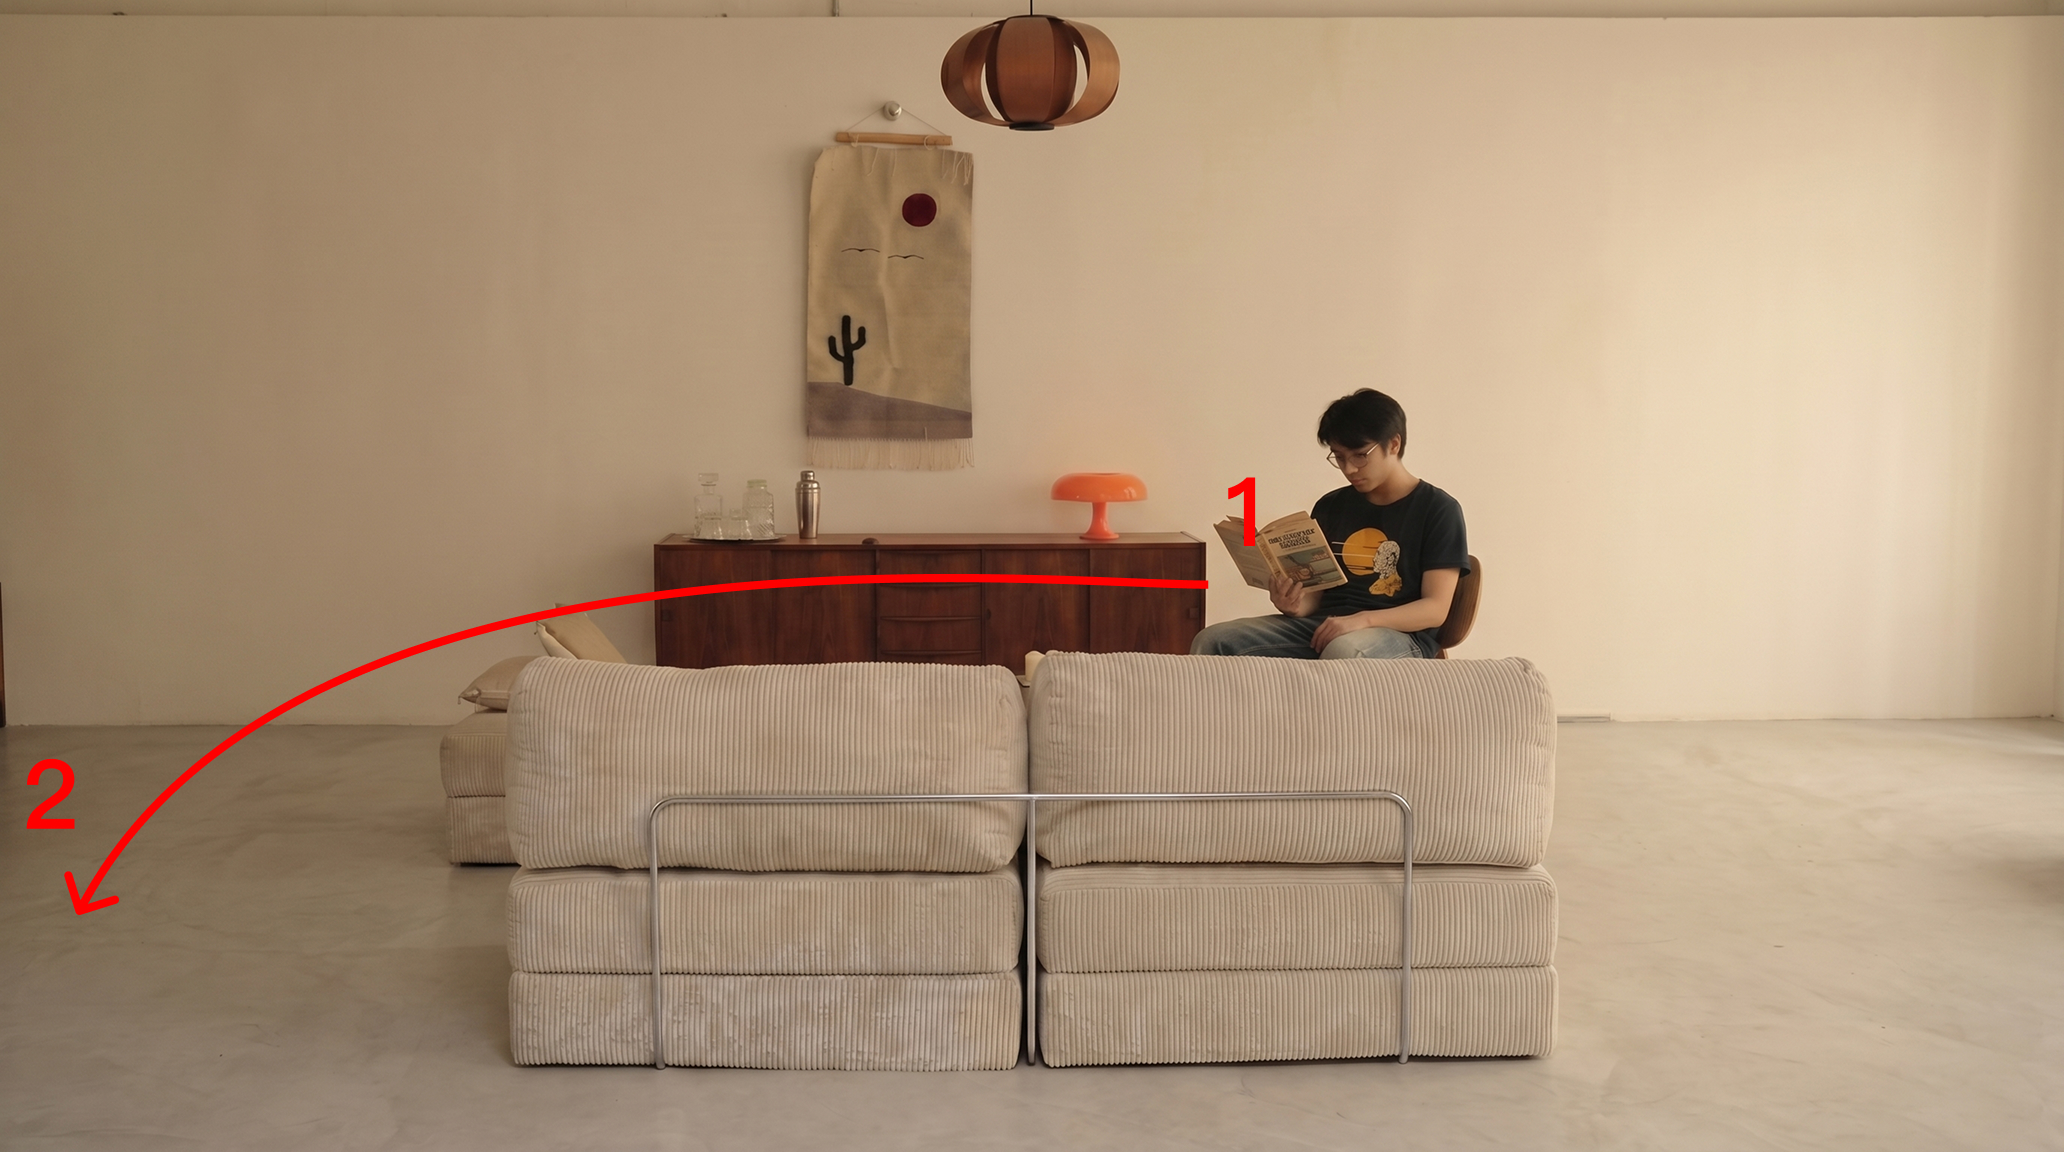
第二步:输入提示词
提示词:
图中的人物按照红色箭头的轨迹行走,生成的画面中不要有红线
这里有一个点要特别注意,就是我们要让AI在生成的时候,必须去掉我们的选框(比如在负面提示词中写明不生成线条和框线)。 否则,AI会把箭头和框一起生成到最终的视频画面里。
第四章:进阶细节——多角色运动的色彩隔离法
当画面中不仅有一个人,而是有两三个角色在进行不同的运动时,AI极其容易混淆,导致张三跑到了李四的轨迹上。
这时候,“不同颜色区分法”就显得尤为关键。
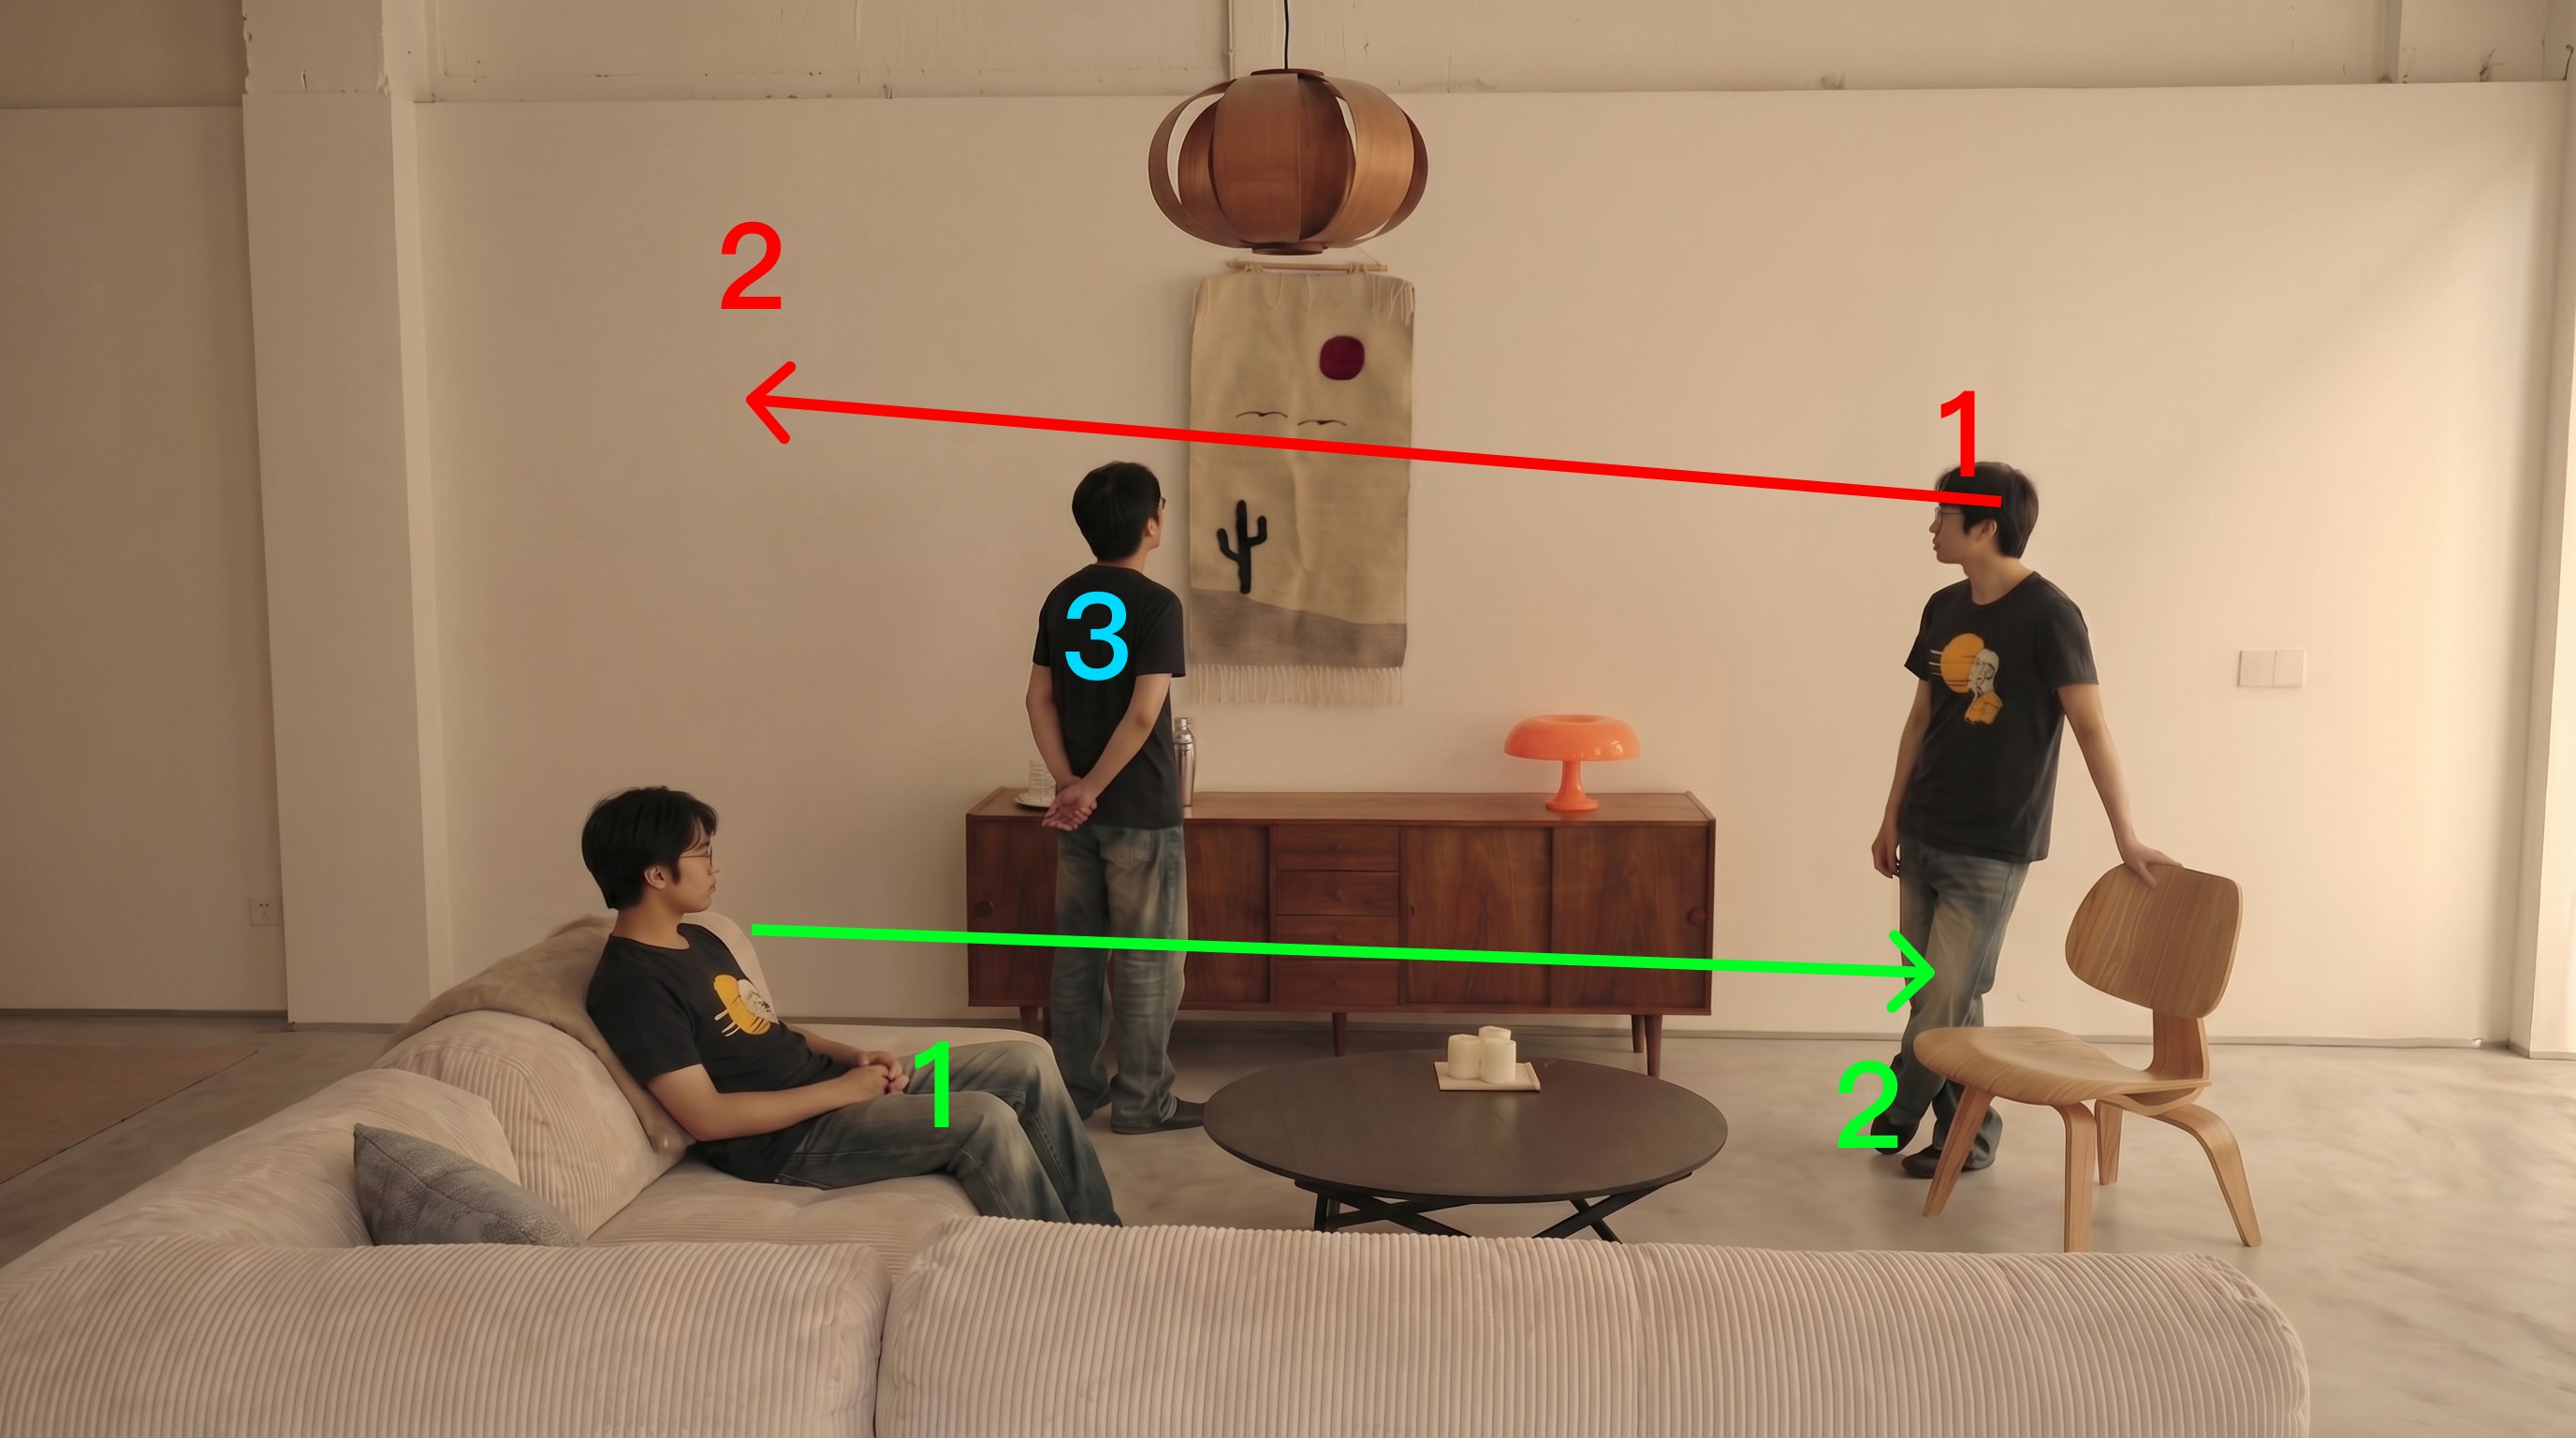
如果你要让绿色人物往右走,红色人物往左走,蓝色人物不动。
在参考图上,用箭头和数字标注运动轨迹。
输入提示词:
图中有三个人物,分别是红色标,绿色标,蓝色标,绿色标人物按照箭头从1处走到2处,红色标人物按照箭头从1处走到2处,蓝色人物保持不动,四处观望。视频中不要有箭头显示
第五章:总结与创作心得
回过头来看,这种看似简单的“画框框”方法,其实蕴含了人机协作的最高效智慧。我们不需要去钻研复杂的节点连线,也不需要学习三维坐标系的输入方式。
无论是使用主打图像的 Nano Banana Pro,还是主攻视频的可灵和海螺,这套基于“视觉锚点”的方法论是通用的。只要掌握了这个技巧,整张画面和整段视频的控制力就会牢牢掌握在你的手中,大大减少抽卡的废片率。希望大家赶紧打开手头的AI工具,亲自去试一试这种精准控制的快感!
角色设计执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课不是让你照着参考图抄脸,而是围绕「玩转AI空间控制:告别人物乱放,精准掌控角色站位」把原创角色脸拆成结构、比例、五官主次和妆造记忆点。
按原文节奏走最稳:先吃透「第一章:为什么AI总是不听话?揭秘空间失控的底层逻辑」,再把「第二章:降维打击——“视觉锚点”控制法原理」定住,接着处理「第三章:视频生成——让角色按轨迹运动」;最后用「第四章:进阶细节——多角色运动的色彩隔离法」收口。
- 先把「第一章:为什么AI总是不听话?揭秘空间失控的底层逻辑」里说的脸型或气质定住。
- 围绕「第二章:降维打击——“视觉锚点”控制法原理」收一收五官,不要让每个部位都抢戏。
- 做完「第三章:视频生成——让角色按轨迹运动」后,先确认角色还是原创。
- 按「第四章:进阶细节——多角色运动的色彩隔离法」去统一气质,不要只改表面。
- 围绕「第五章:总结与创作心得」收一收五官,不要让每个部位都抢戏。
不要直接套真人脸或影视角色脸;不要把所有五官都做成强特征,否则容易撞脸、割裂、不稳定。
检查角色是否有清晰记忆点;年龄感和气质是否一致;换妆造后脸是否稳定;是否不像任何明确真人或影视角色。
请围绕「玩转AI空间控制:告别人物乱放,精准掌控角色站位」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:角色定位、脸型方向、三庭五眼比例、五官主次、妆造记忆点、完整生图提示词。要求原创、有辨识度、避免撞脸和网红脸。