
在AI视觉创作进入2026年的今天,我们惊喜地发现,像Midjourney v7和即梦AI的最新版本,在“文生图”领域对比例、常识的理解已近乎完美。
然而,绝大多数创作者在迈向进阶时,依然被同一个鬼魅般的“恐怖谷”问题困扰:
那就是“图生图”中的合成比例崩溃。
你想把一张高质量的人物模特照放入一张壮观的异星峡谷背景中,结果AI不是生成了一个“挂”在山顶的微缩人,就是把模特的头撑满了大厅。
这并非AI的随机失误,而是由于AI在处理“独立的图像资产”与“新的空间环境”时存在严重的语义断层。
本教程将利用目前最主流、最高效的即梦、Midjourney及Nano等工具的底层逻辑,教你如何用最直观的方法,彻底驯服图生图画面中的比例失调,把人物“种”进环境。
第一章:图生图合成的“认知障碍”:为什么AI读不懂你想“放”哪里?
在开始实操前,我们必须理解AI在进行图生图操作时的核心短板。
1.1 环境优先级逻辑 VS. 元素定位
2026年的文生图模型,其注意力机制能够完美平衡“人物本身”与“场景空间”。然而,当你使用图生图功能时,你是在试图把两个独立的、拥有自己独立视觉上下文的图像强制融合。
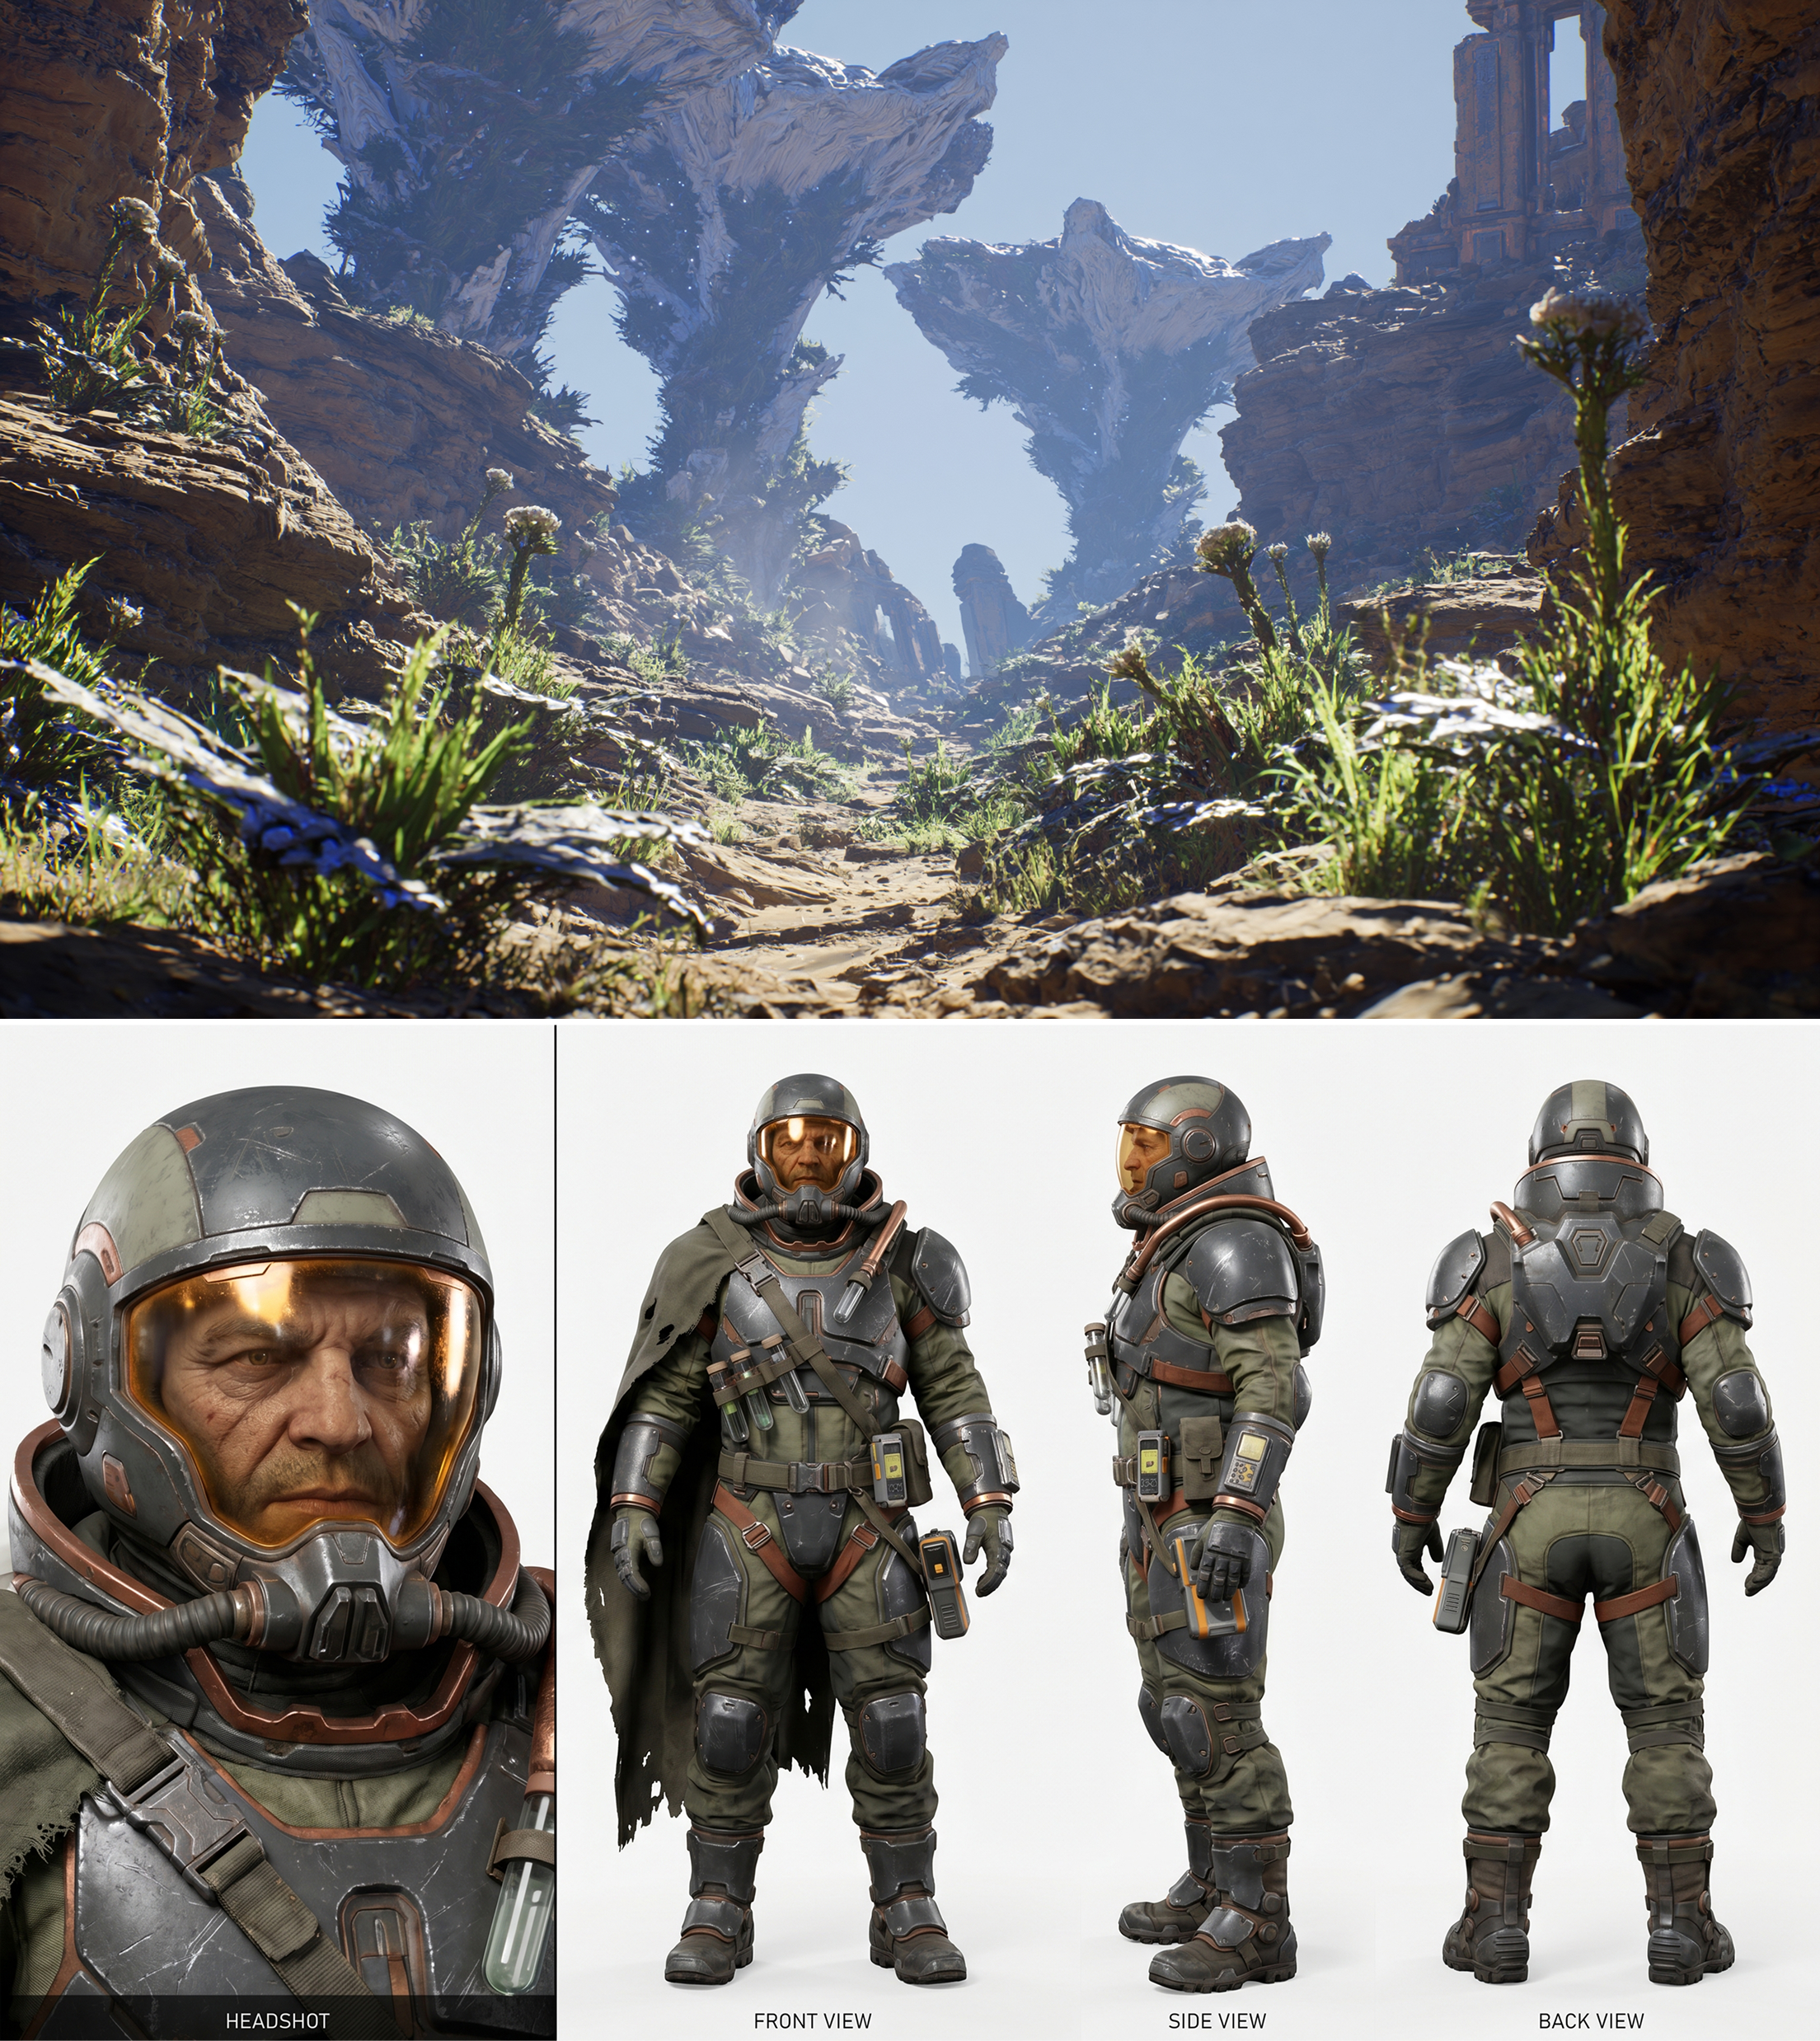
场景模拟:你提供了一张浩瀚无垠、充满巨型异星植物和废墟的广阔峡谷场景图作为背景(环境资产)。你又提供了一张普通的、站立姿态的探险家模特图(人物资产)。
环境的提示词:
A vast and boundless canyon filled with giant alien plants and ruins,Realistic style,uE5 game rendering(翻译:一个广阔无边的峡谷充满了巨大的外星植物和废墟,逼真的风格,uE5游戏渲染)
人物的提示词:
4-panel character reference sheet on pure white background: left panel is a close-up headshot portrait, right 3 panels are full-body views (front view, side view, back view) on clean white background. A rugged alien explorer in photorealistic UE5 game engine style: wearing a highly detailed multi-layered spacesuit with physically-based rendered (PBR) materials, asymmetrical armored plates showing realistic wear, scratches and dirt, a modular utility harness with specimen collection vials and scanning equipment, a half-helmet with a glowing amber visor that reflects realistically, a breathing apparatus on the lower face, reinforced knee and elbow pads with realistic leather and metal materials, a torn tactical cloak draped over one shoulder, heavy magnetic boots with treaded soles. Color palette: muted olive green, burnt orange accents, dark grey armor, copper piping. Photorealistic 3D game character concept, Unreal Engine 5 style rendering, ray-traced lighting, next-gen game asset quality, high detail textures.(翻译:4张纯白背景的人物参考表:左边是特写头像,右边3张是纯白背景的全身视图(正面,侧面,背面)。一个坚固的外星探险家在逼真的UE5游戏引擎风格:穿着高度精细的多层太空服,采用基于物理的渲染(PBR)材料,不对称的装甲板显示真实的磨损,划痕和灰尘,带有标本采集瓶和扫描设备的模块化实用安全带,带有发光的琥珀遮光罩的半头盔,可以真实地反射,下脸上有呼吸器,用逼真的皮革和金属材料加固的膝盖和肘部垫,一个撕裂的战术斗篷披在肩上,厚磁靴,鞋底有踏面。配色:柔和的橄榄绿,焦橙色,深灰色盔甲,铜管。逼真的3D游戏角色概念,虚幻引擎5风格渲染,光线追踪照明,下一代游戏资产质量,高细节纹理。)
语义孤岛化:在你看来,你是要把这个探险家“放”到峡谷中央。但在AI看来,这仅仅是两个独立的语义标签和两组独立的像素分布。AI在融合它们时,如果没有明确的“物理约束”,它就会根据训练集中的平均概率进行盲目匹配。
1.2 缺乏空间锚点
由于缺乏具体的空间坐标和大小约束,AI在融合像素时,比例往往拿捏不准。在图生图中,最容易出现的其实不是那种极其离谱的错误,而是“差之毫厘,谬以千里”的微妙失调:
最常见的痛点:人物偏大,吃掉场景的纵深感。
例如,当我们尝试将详细的人物素材(探险家)‘种’进峡谷中时,AI为了保留人物清晰的装甲和服饰细节,往往会把他放在画面的绝对中心,并放大他的身形。
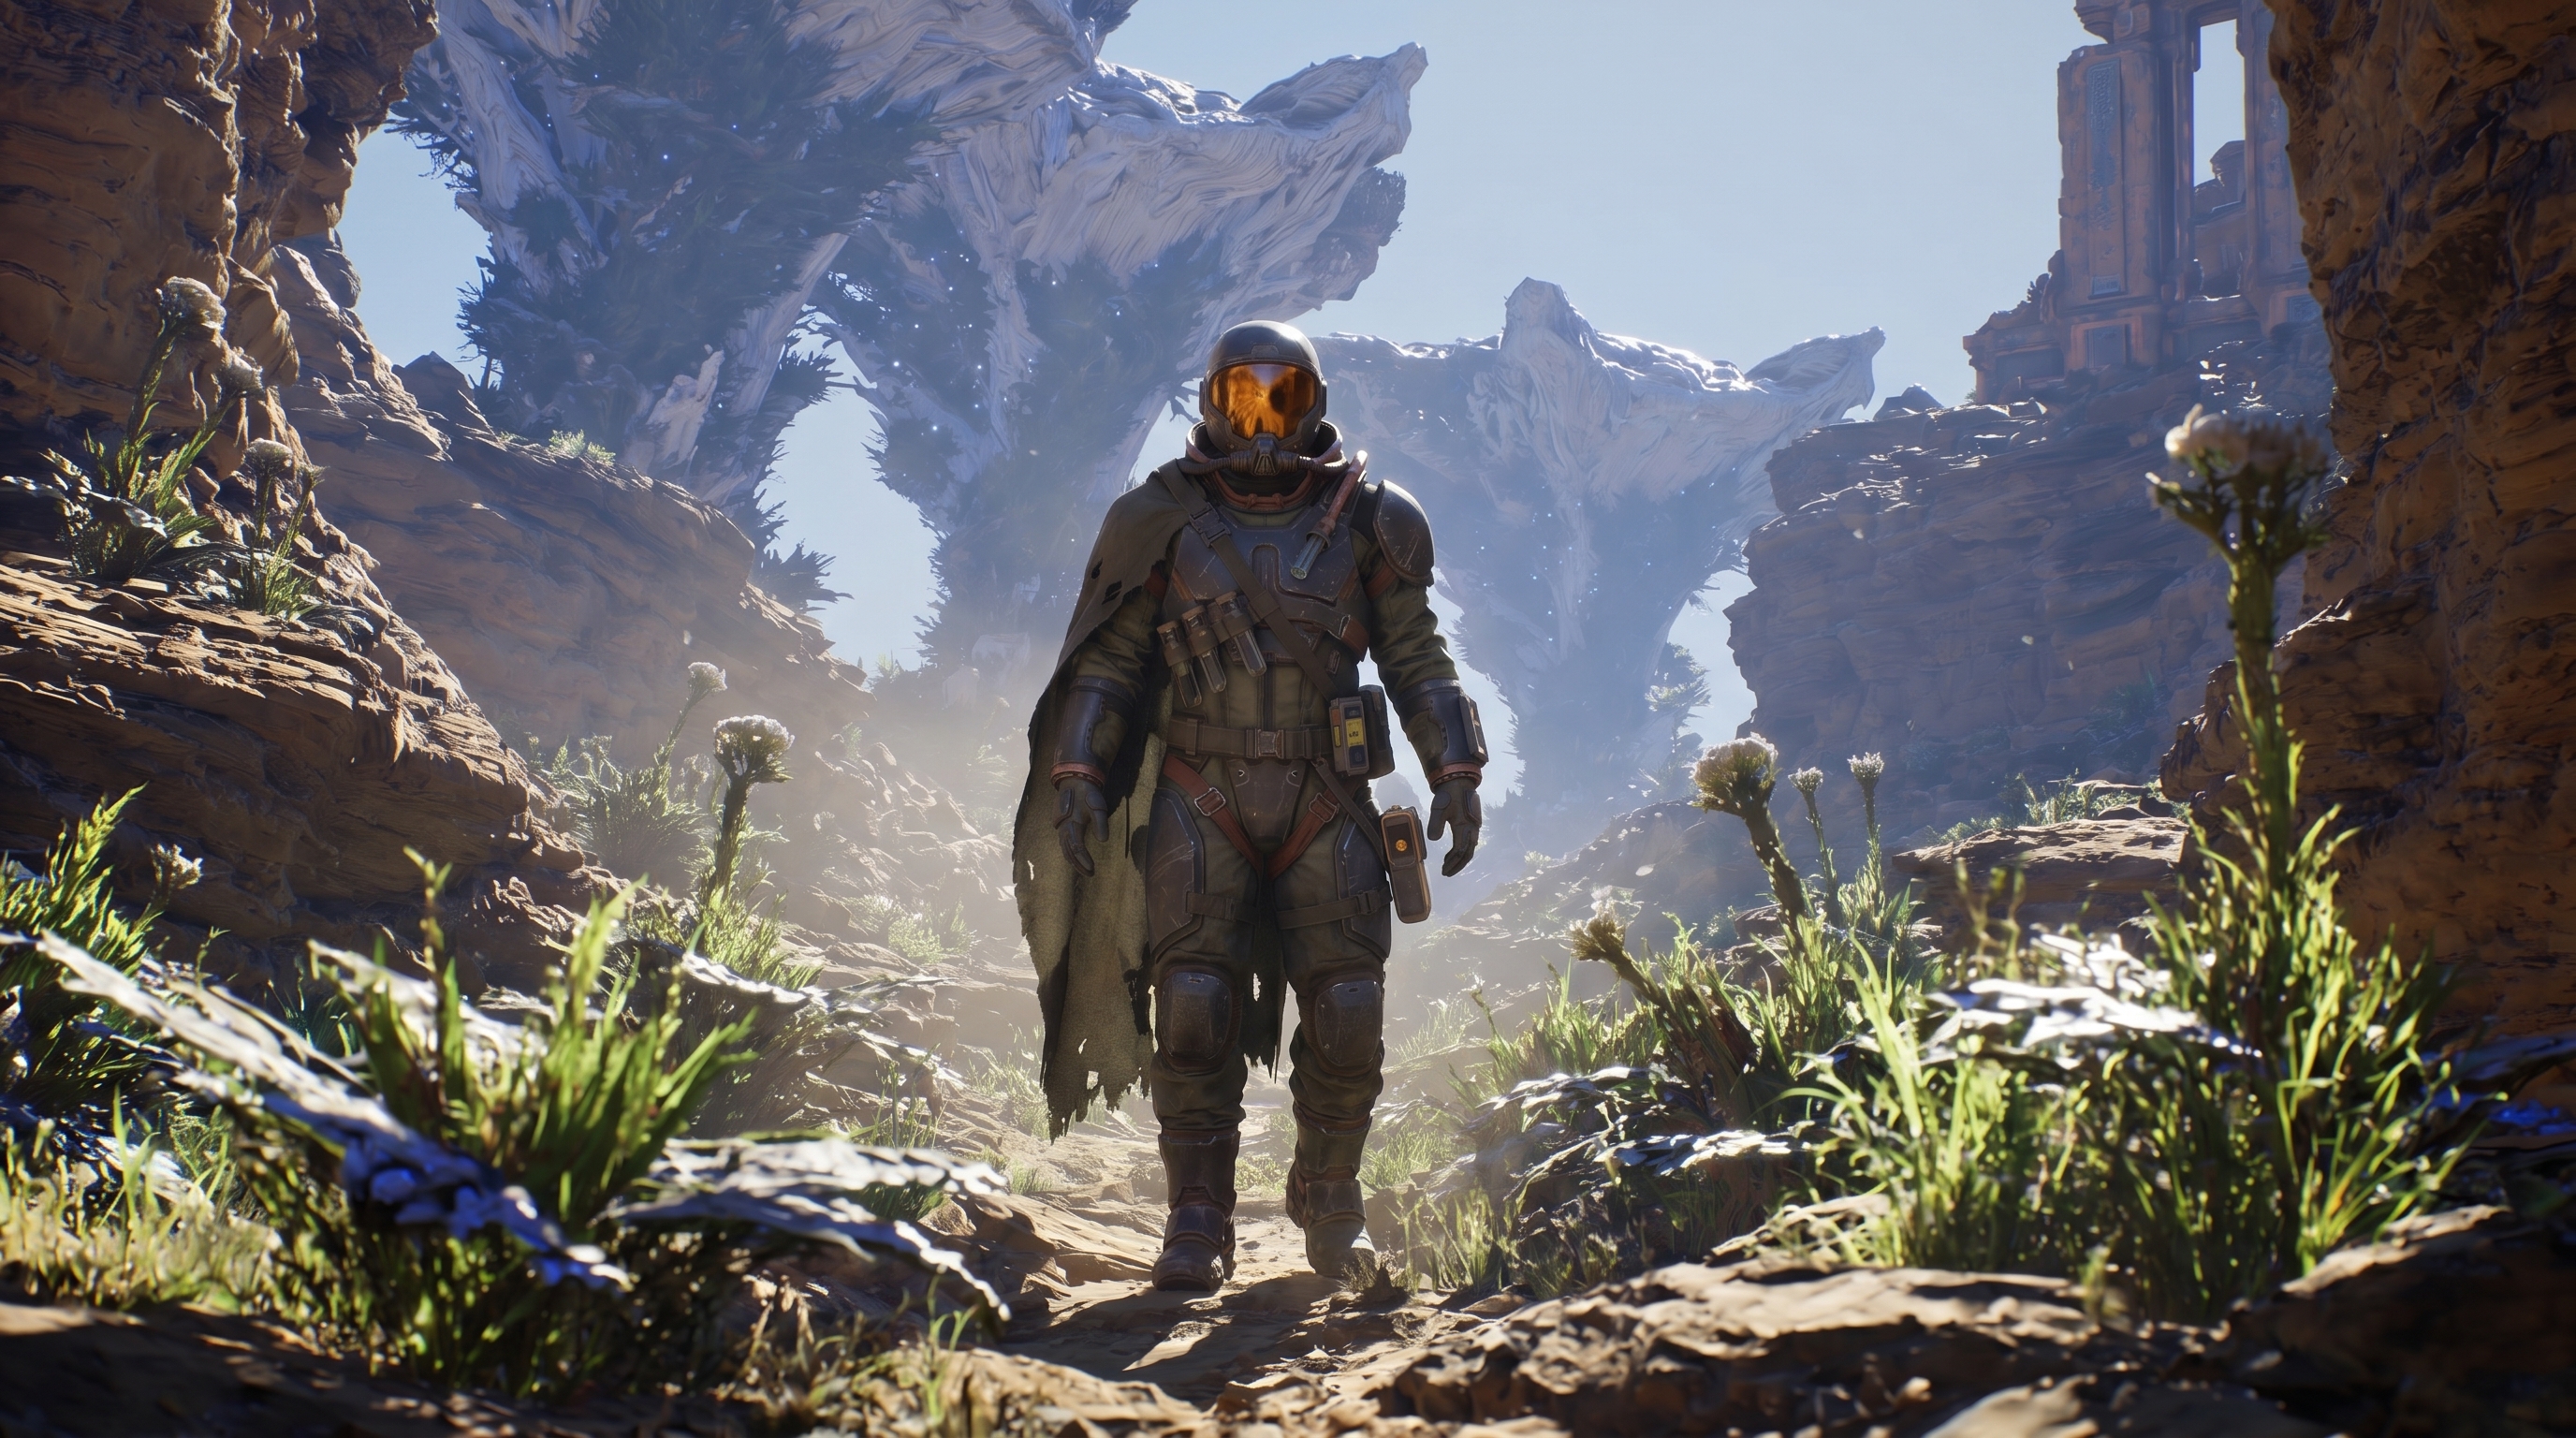
融合提示词:将图2人物自然的放到图1中,光影重构
在这张图里,探险家并没有大得离谱,但在这个本该“浩瀚”的环境里,他的比例明显偏大了。这就导致原本应该显得极其遥远、宏伟的巨型植物和废墟,在视觉上被强行“拉近”了。整个峡谷失去了一种史诗般的深邃感,更像是一个狭窄的布景通道。这种不符合真实透视的比例,会瞬间打破画面的真实感。
另一种极端:人物过小,被环境吞噬。
反之,如果AI过度倾向于保护背景的完整性,它也可能把人缩成一个极小的黑点填塞进某个角落。
第二章:单个人物精准卡位——从“语义参照”到“区域控制”
针对这种无论是偏大还是偏小的比例问题,2026年的主流工具提供了两种高效的解决方案。
方法一:利用语义参照指令
不要只说“一个探险家站在峡谷中央”,这会让AI迷失比例。你需要利用提示词工程在图生图指令中加入具体的物理对比描述。
技巧:直接告诉它人物在视觉上占据环境的多少。例如:“人物的高度大约占据画面垂直高度的八分之一”,“人物大约只有背景神庙废墟一个立柱底座那么高”。
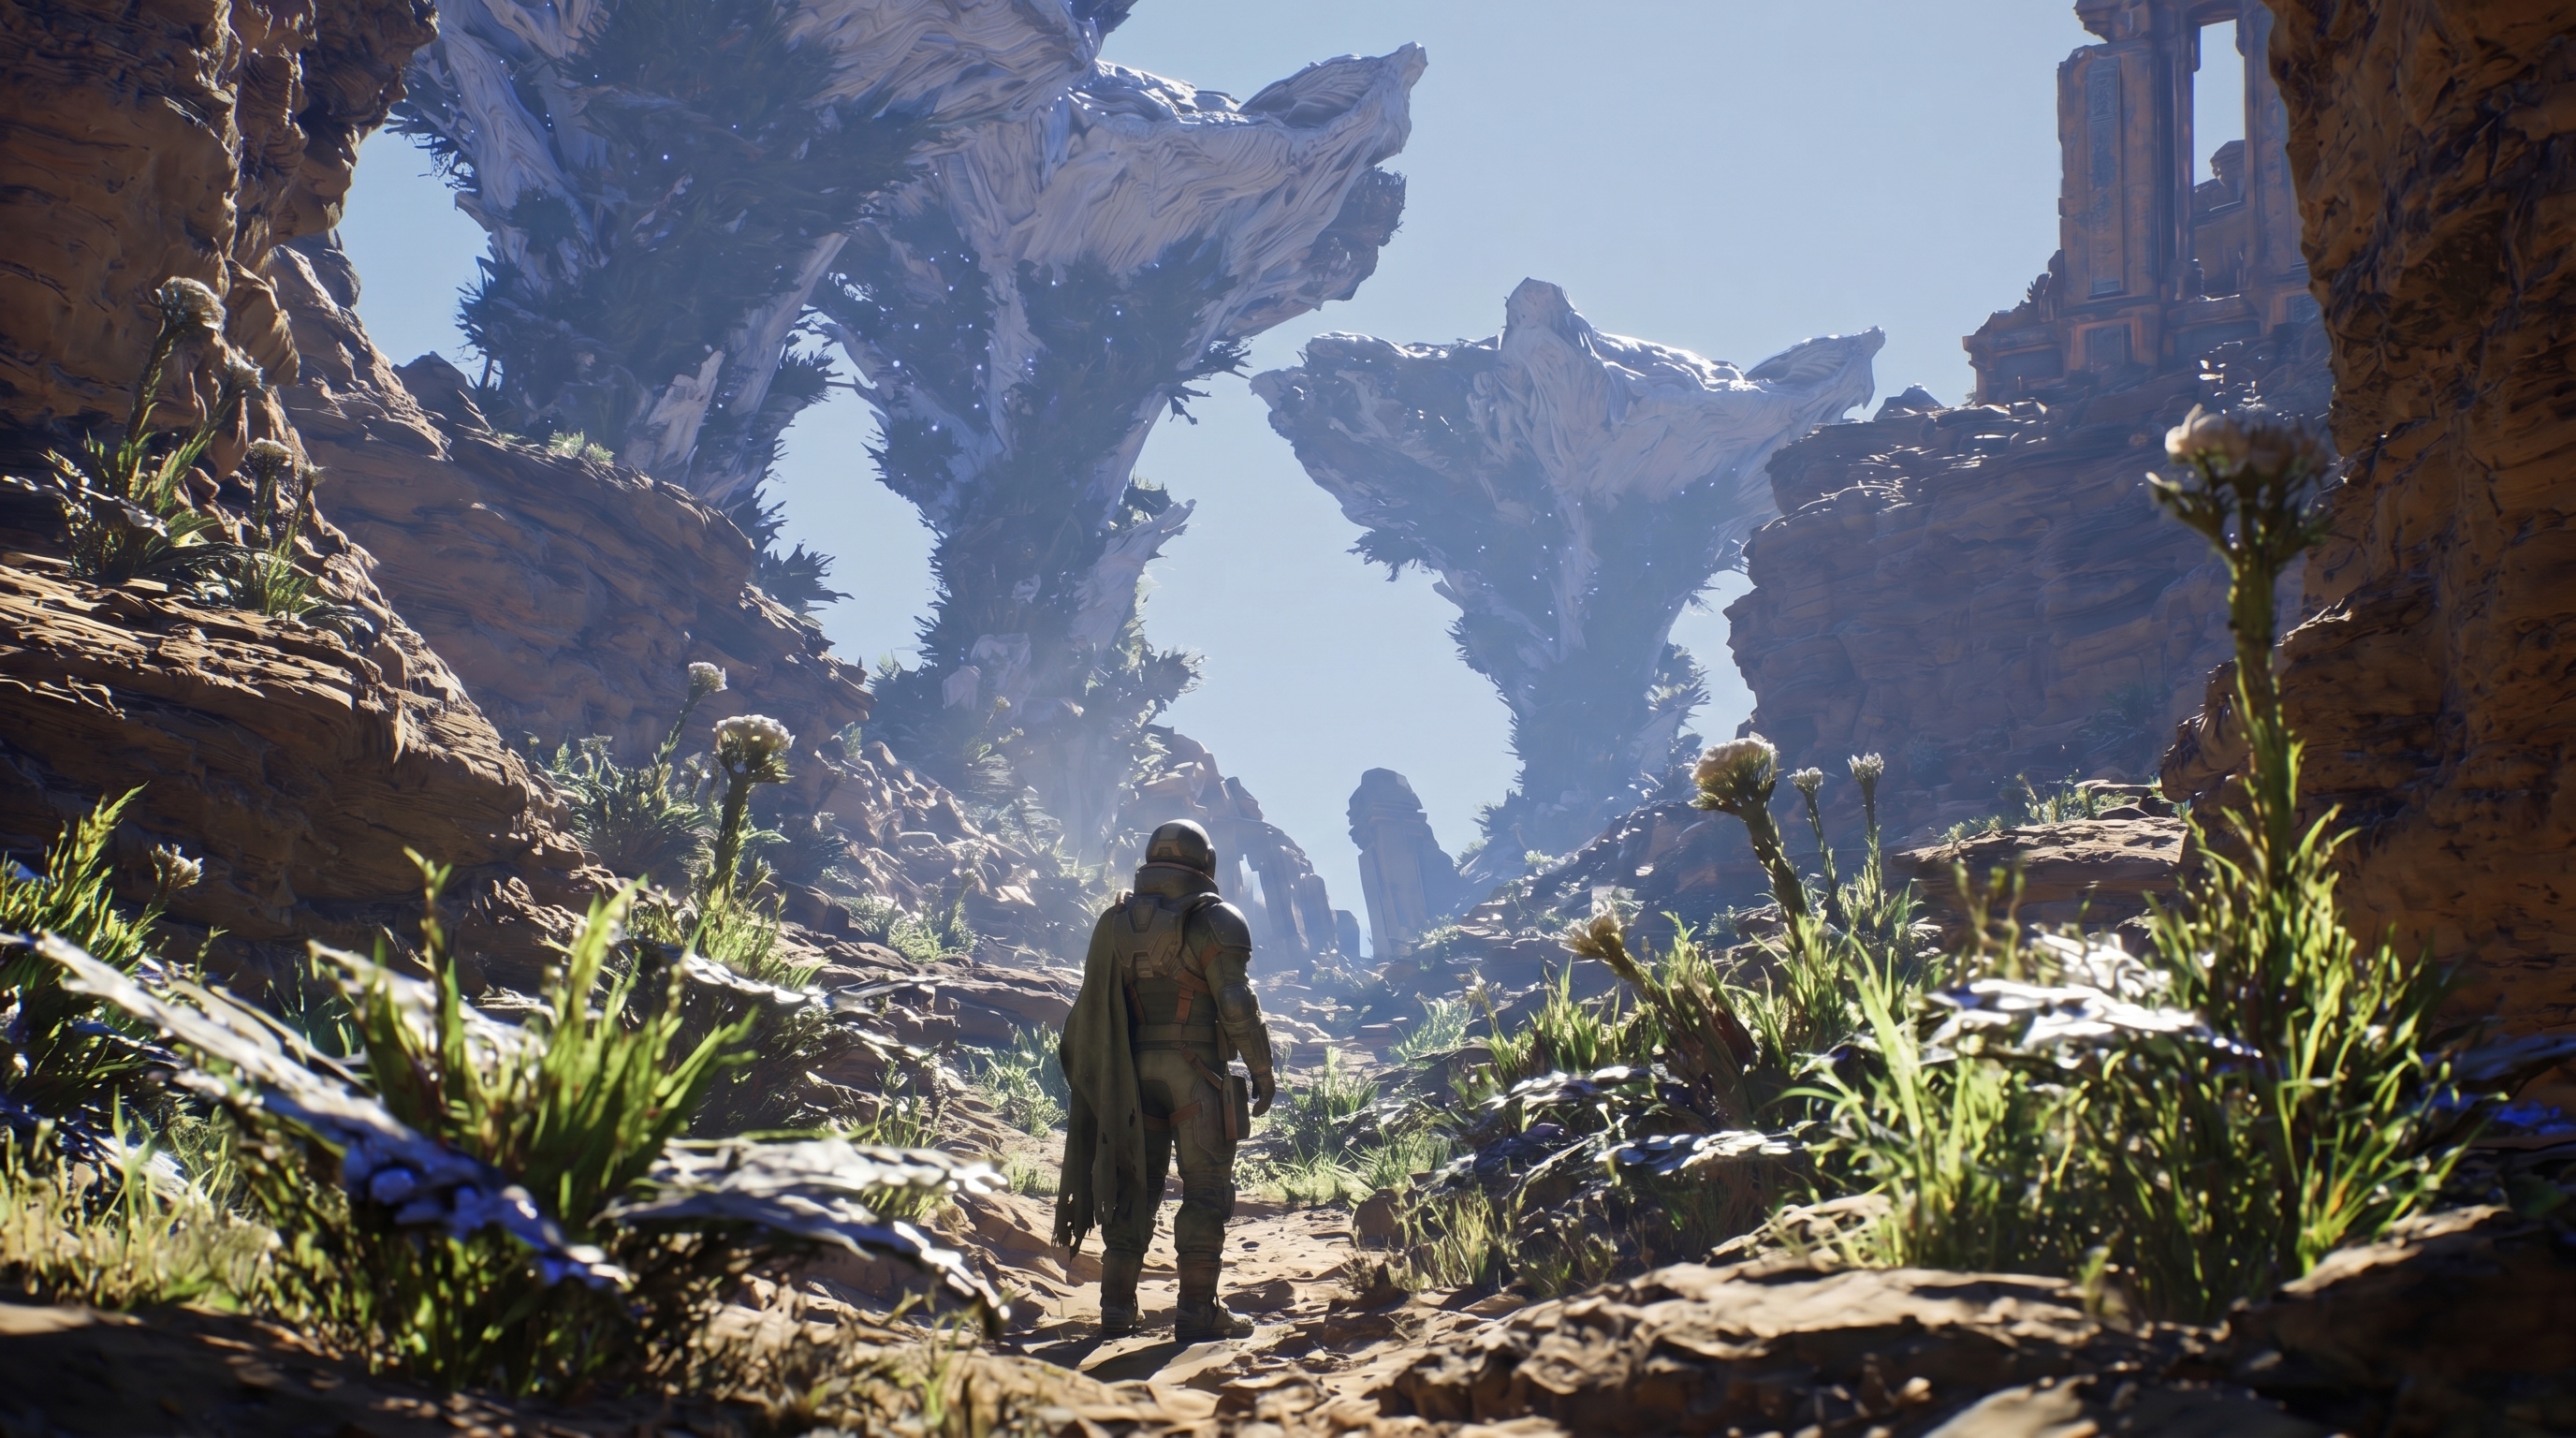
融合提示词:将图2人物自然的放到图1中,光影重构,人物的高度大约占据画面垂直高度的八分之一,体现出人物的渺小,环境的宏大
方法二:区域控制
——最强烈推荐,解决此类比例崩溃最精准、最好上手的方法。
核心逻辑:与其指望AI通过文字理解比例,不如直接“画地为牢”。
操作流(以即梦AI为例):
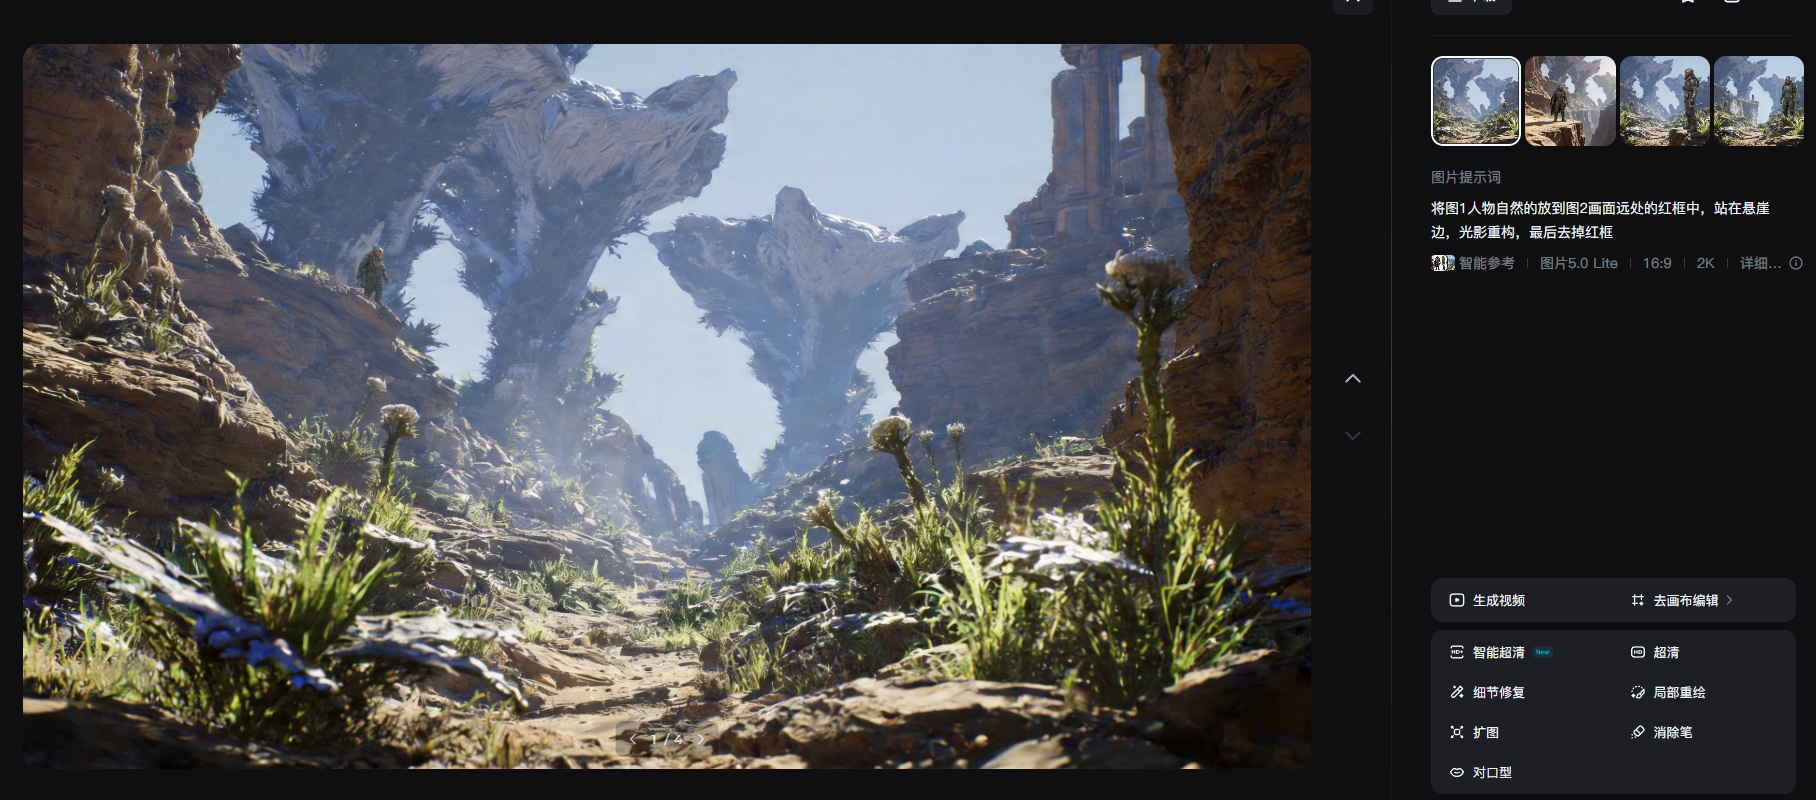
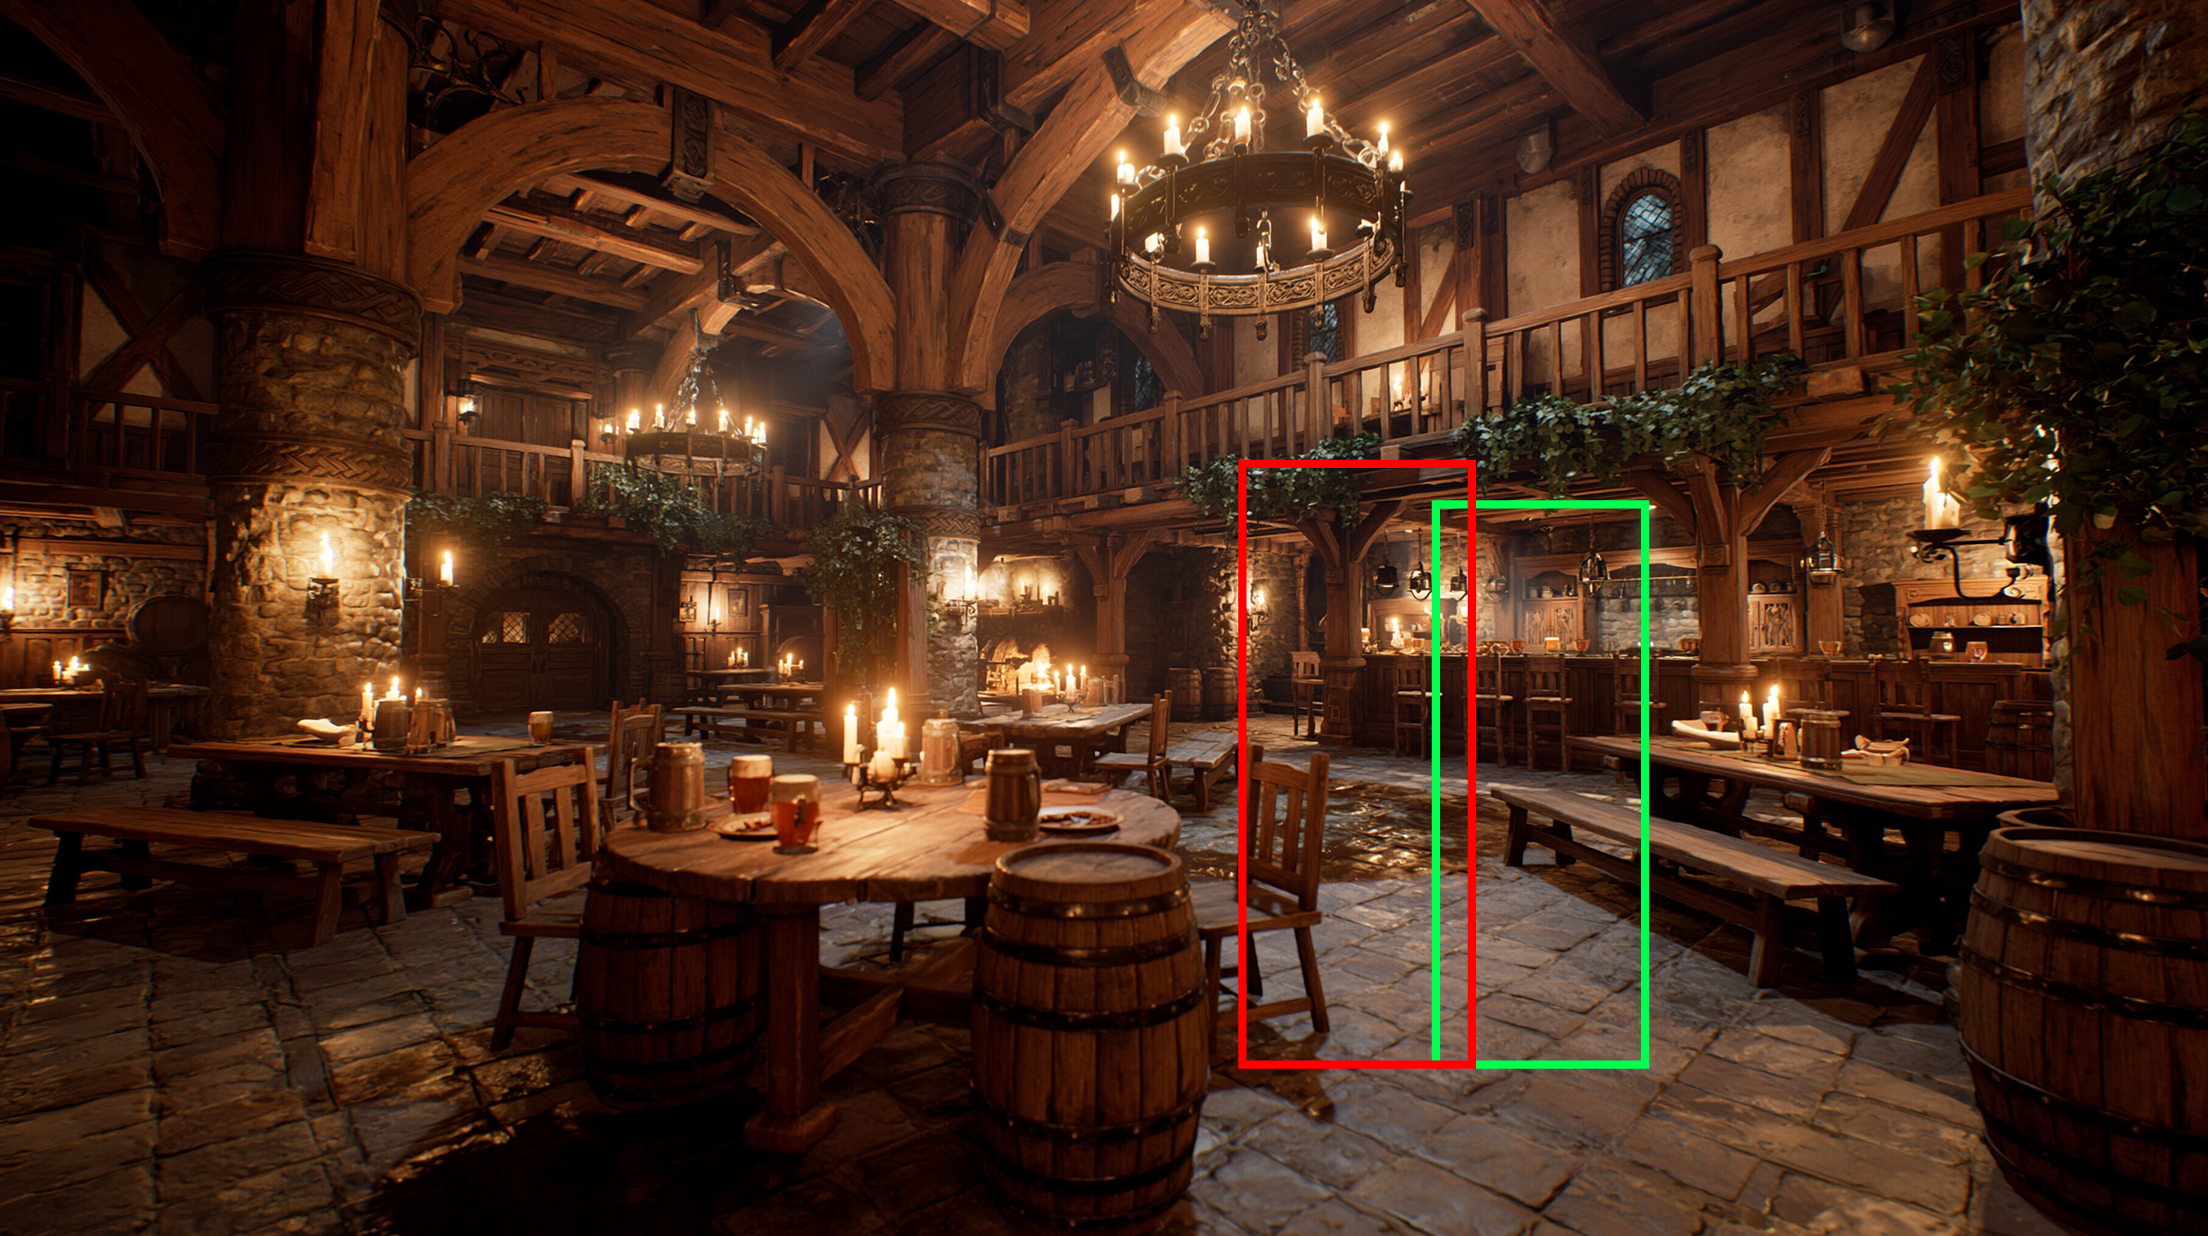
先在场景中,在你希望人物出现的位置,直接拉一个框出来。这个框的大小,就是人物最终的大小! 如果你想展现峡谷的浩瀚,就把这个框画得小一点。
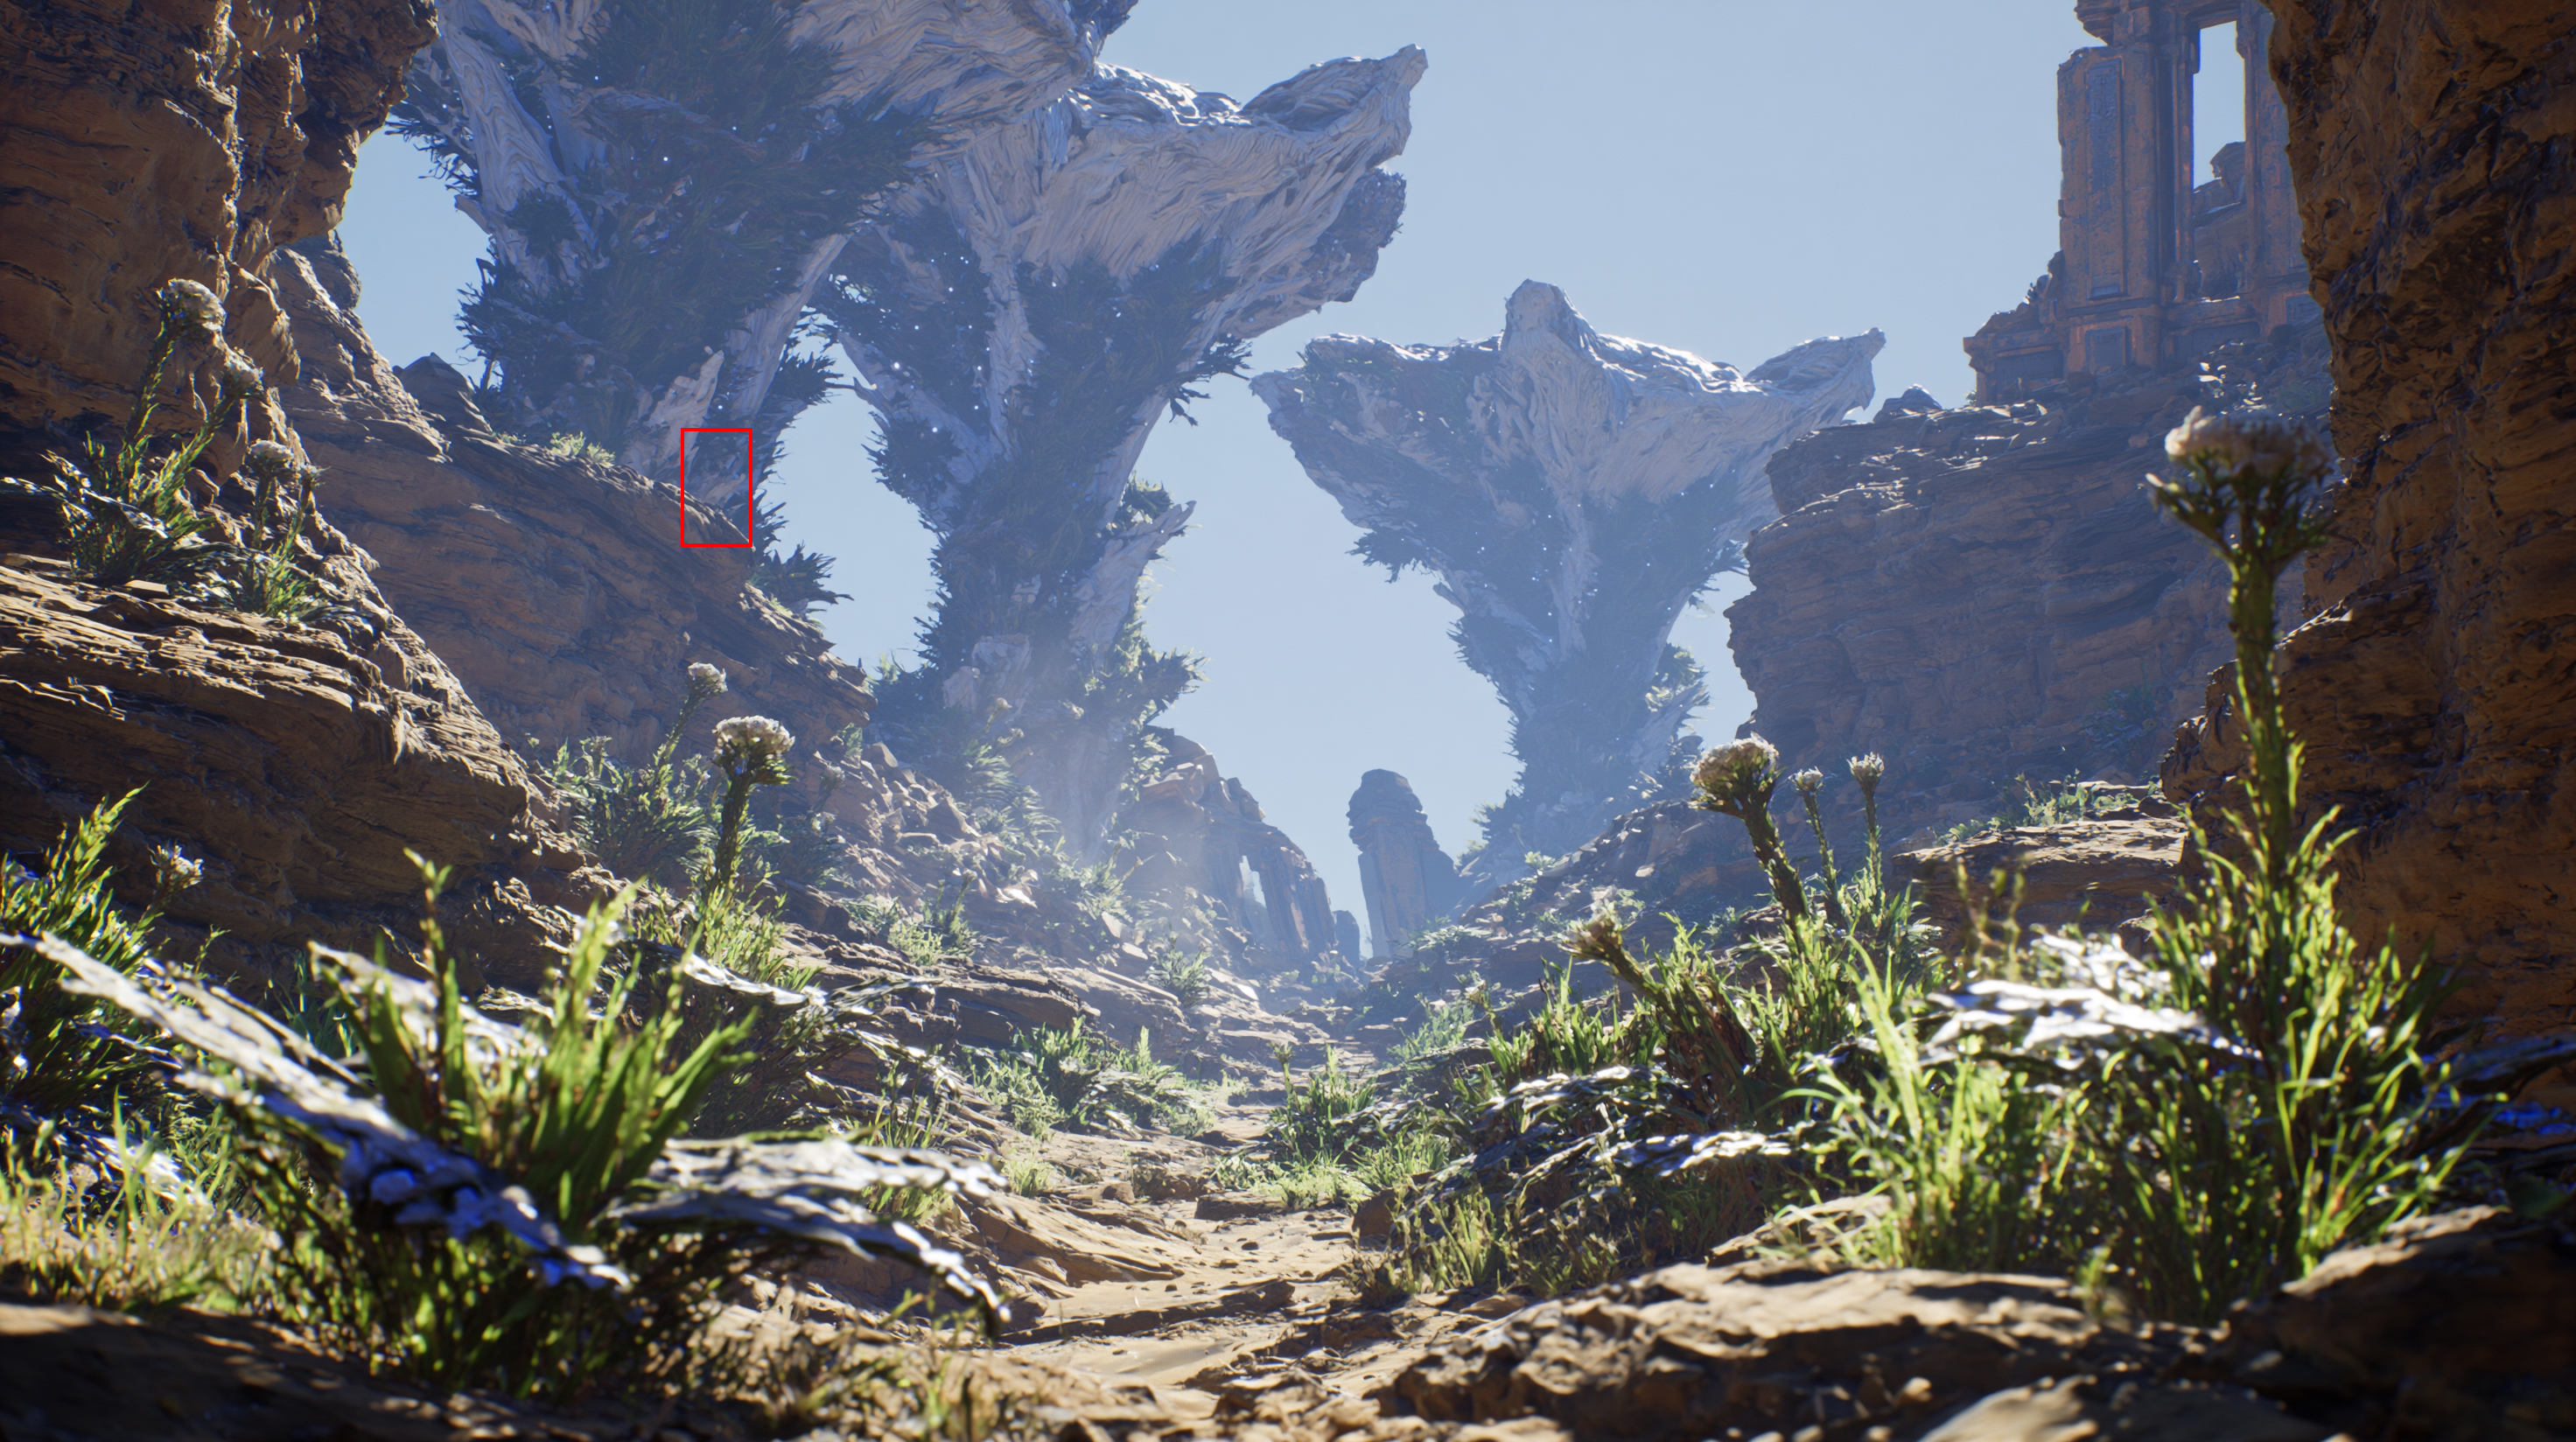
上传你的场景背景图。
上传你需要合成的人物参考图。
输入提示词:
将图1人物自然的放到图2画面远处的红框中,站在悬崖边,光影重构,最后去掉红框
第三章:多人物图生图——透视与互动的“多框法则”
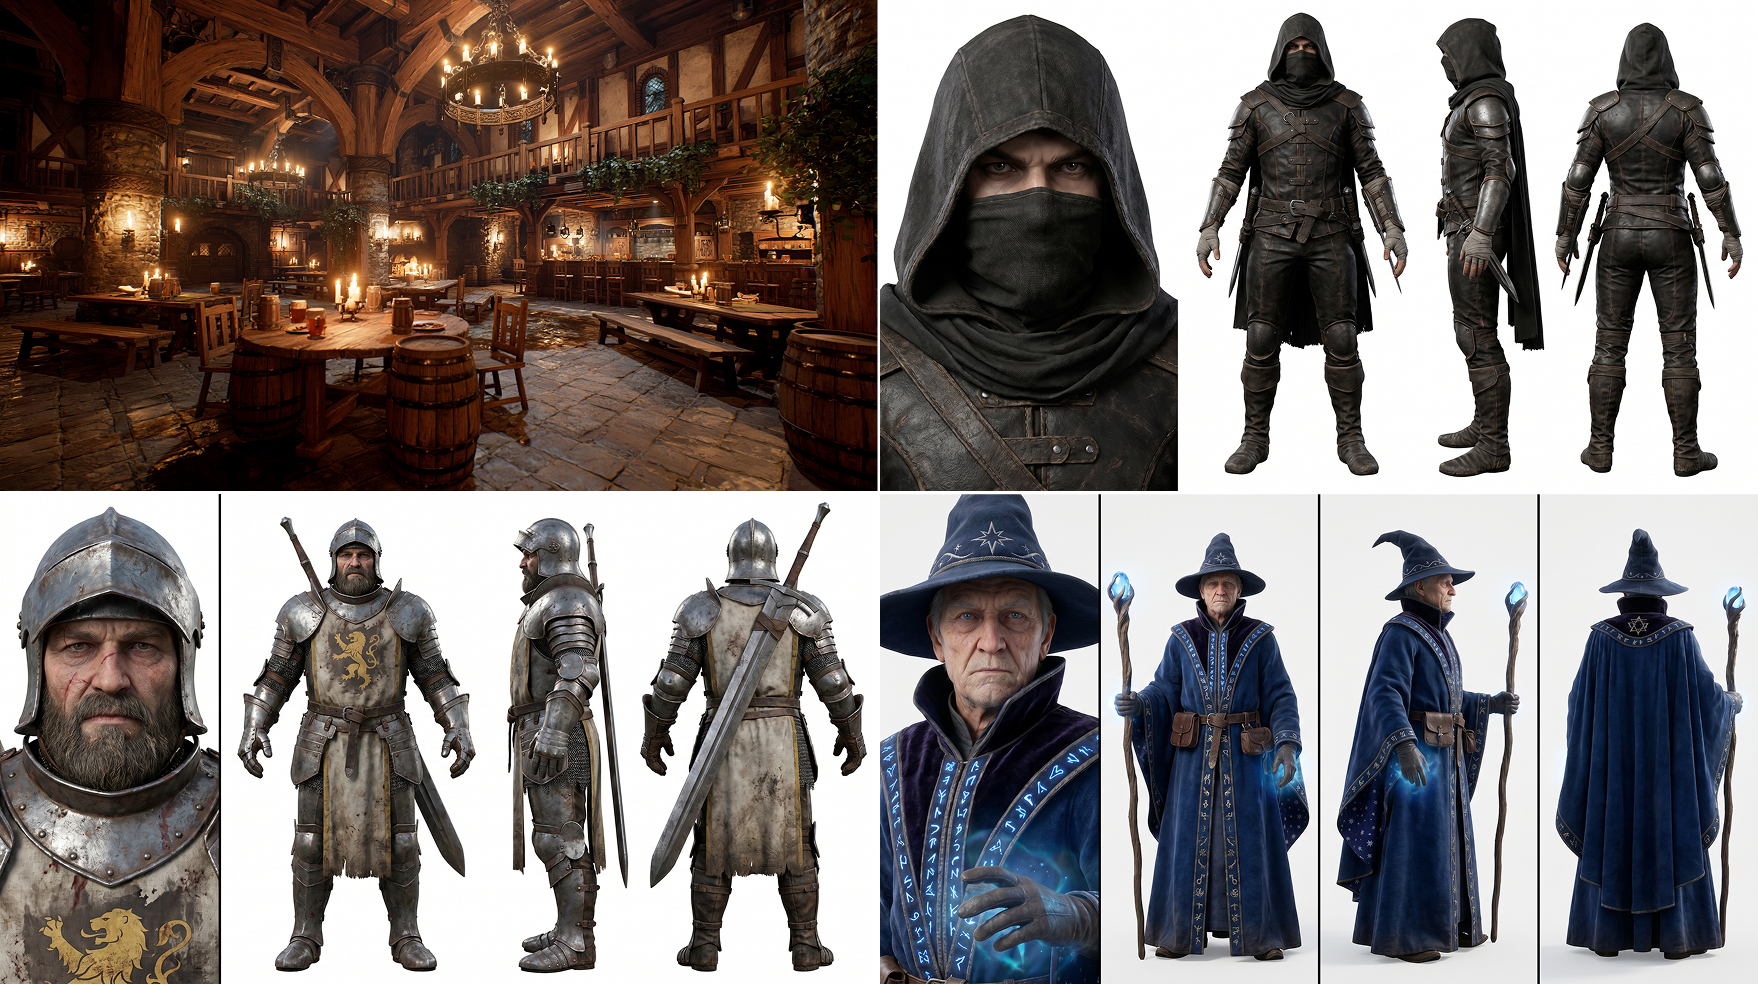
刚才我们解决了单个人物在场景里的站位,那如果是往一张背景图里塞进一支游戏小队呢?比如,我们现在的背景变成了一个“光影昏暗、充满魔法氛围的奇幻冒险者公会(酒馆)”,我们想往里面放入“战士、法师和刺客”这经典的三人组。直接丢提示词通常会迎来灾难:AI要么把所有人挤成一团,要么完全无视近大远小的物理规律。
3.1 告别“纸片人”排排坐
在图生图模式下,如果你只写“三个冒险者在酒馆里”,AI大概率会在画面的同一个深度层面上,给你生成三个一样大的人并排站着。这不仅呆板,还会彻底毁掉公会大厅本该有的空间纵深感,看起来就像早期的2D横版页游。
3.2 多框透视法:近大远小自己画
别去跟AI解释什么是透视,直接用框选工具教它做人!
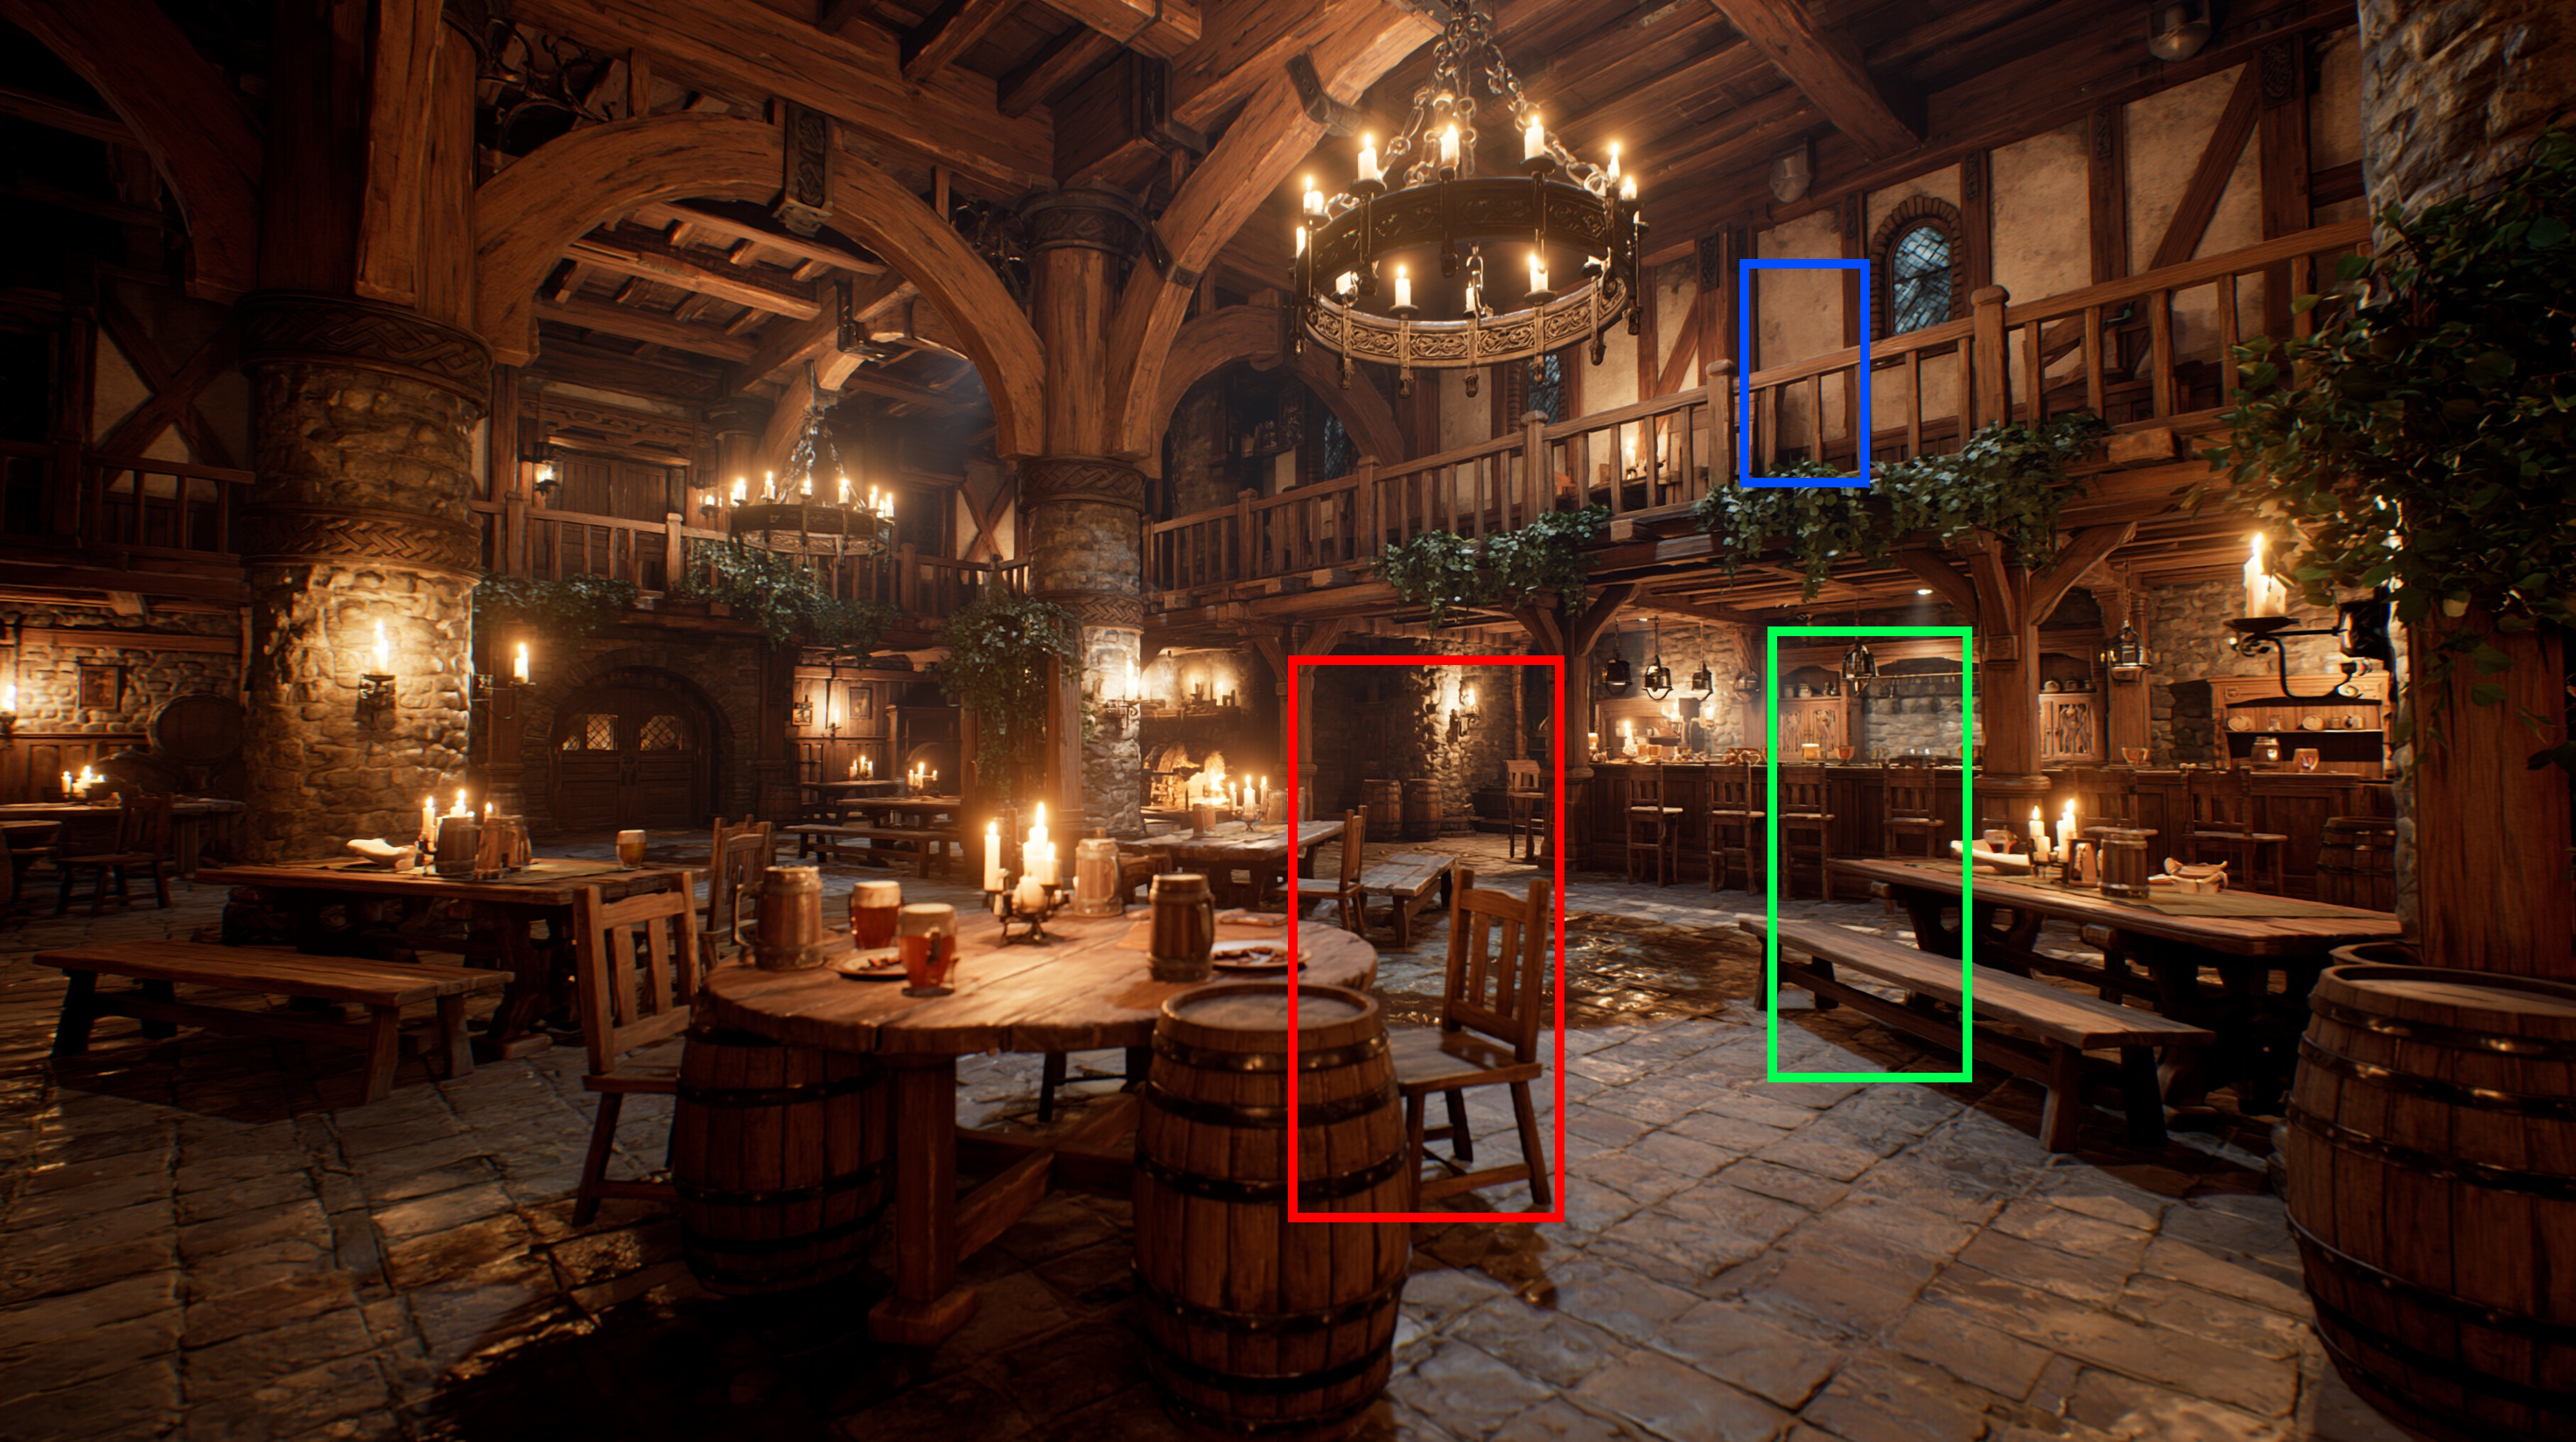
AI的魔法: 即梦或banana非常聪明,只要你把框的大小和高低位置错开,它在生成时会自动脑补出空间的Z轴(深度)。最前方大框里的战士连盔甲上的划痕都清晰可见,而后方小框里的刺客会自动带上酒馆角落的阴影和景深模糊,完全融入背景!
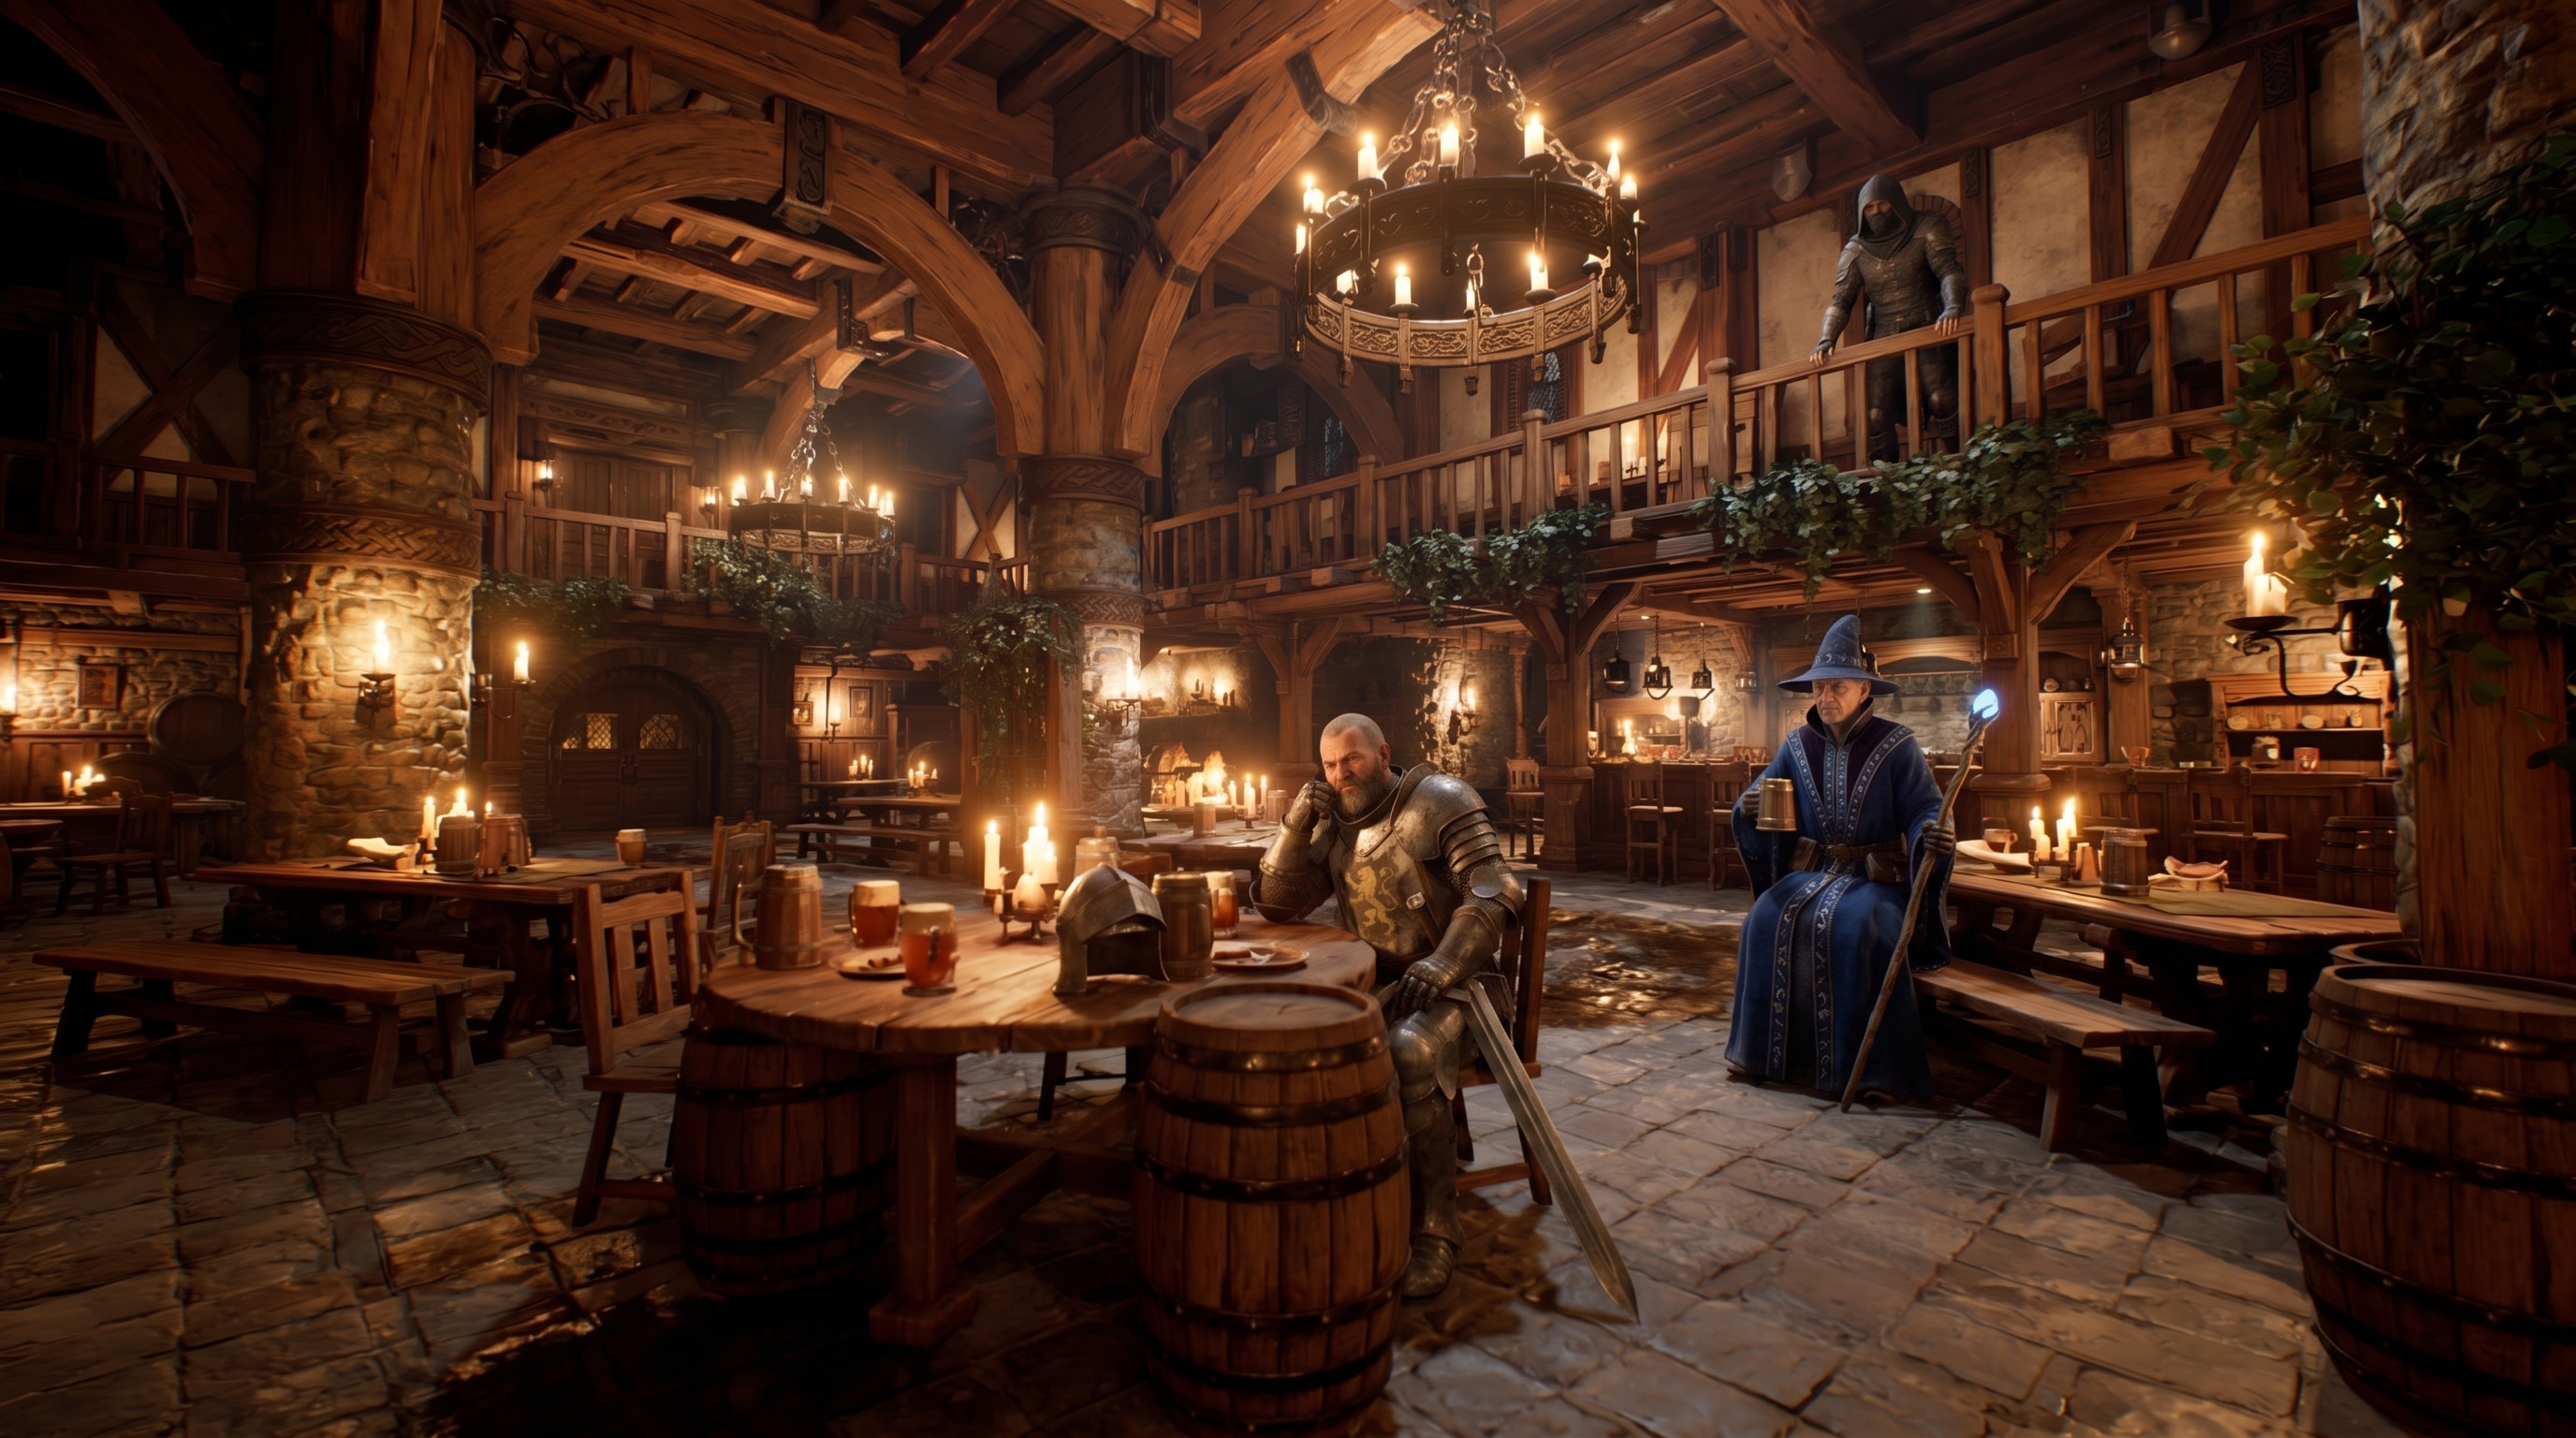
融合提示词:
将图1角色自然的放在蓝框处,图2角色自然的放在绿框处,图3的角色自然的站在红框处,姿态各异,动作随便,最后去掉框
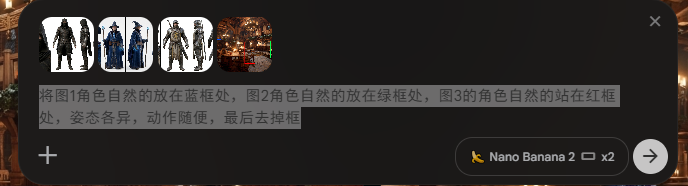
3.3 互动法则:
框必须“打架” 如果你想让两个人有互动,比如在这个公会里,你想生成“酒保正把一杯麦酒递给战士”或者是“两个NPC在交头接耳”。
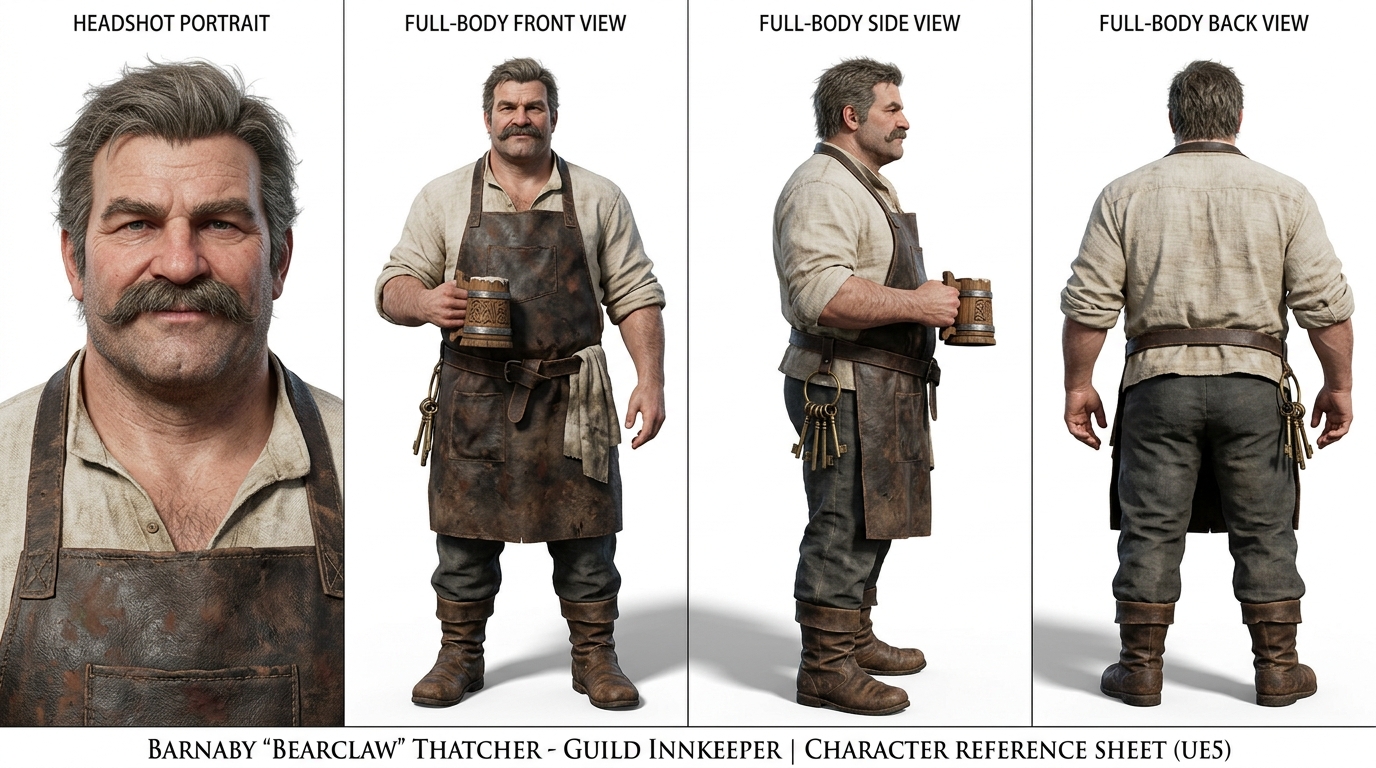
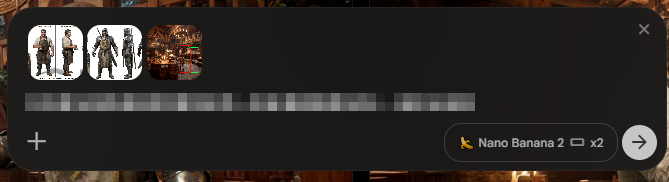
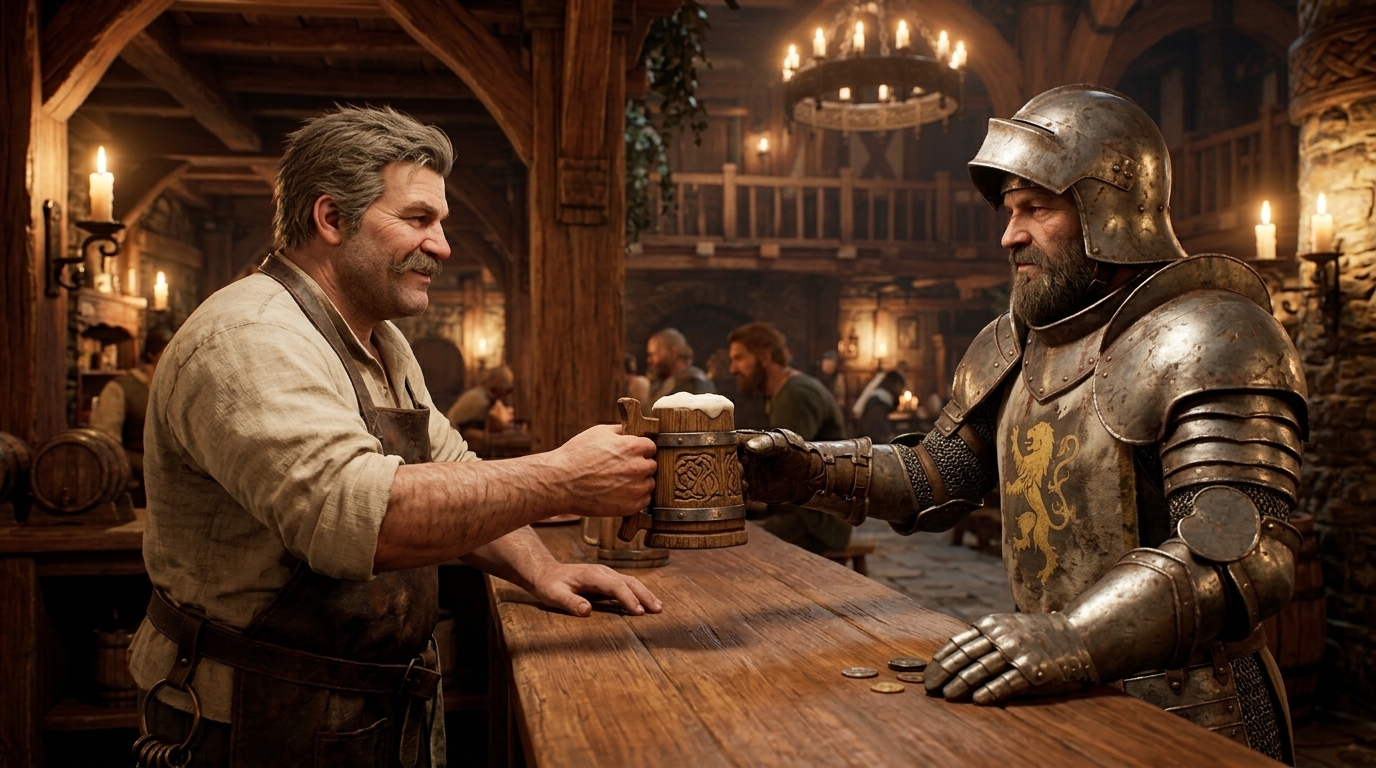
记住死理:这两个选框千万不能是完全分开的! 必须让两人的选框有一部分重叠。只有选框重叠了,AI才会知道这两个物体在空间上是接触的,从而生成自然的肢体互动,而不是两个各干各的木头人。
融合提示词:
红色框与绿色框处图1酒保正把一杯麦酒递给图2战士,最后去掉框
第四章:细节进阶——彻底告别“大头娃娃”的换脸陷阱
好不容易把干员完美地“种”进废土神庙场景里了,全身比例和构图都堪称完美,但很多创作者在做“角色深度定制”时翻了车:你想把游戏角色的脸换成指定的脸部设定图。比如,你生成了一个“脸部全露出来、戴着面罩但五官清晰可见的全身特战干员”。盔甲、战术挂件和背景神庙细节堪称电影级,但当你局部重绘头部进行换脸时,出来的图要么顶着个硕大无比的脑袋,要么原本的脖子和肩膀装甲被脸吞噬,瞬间从硬核射击游戏变成了Q版搞笑滤镜。
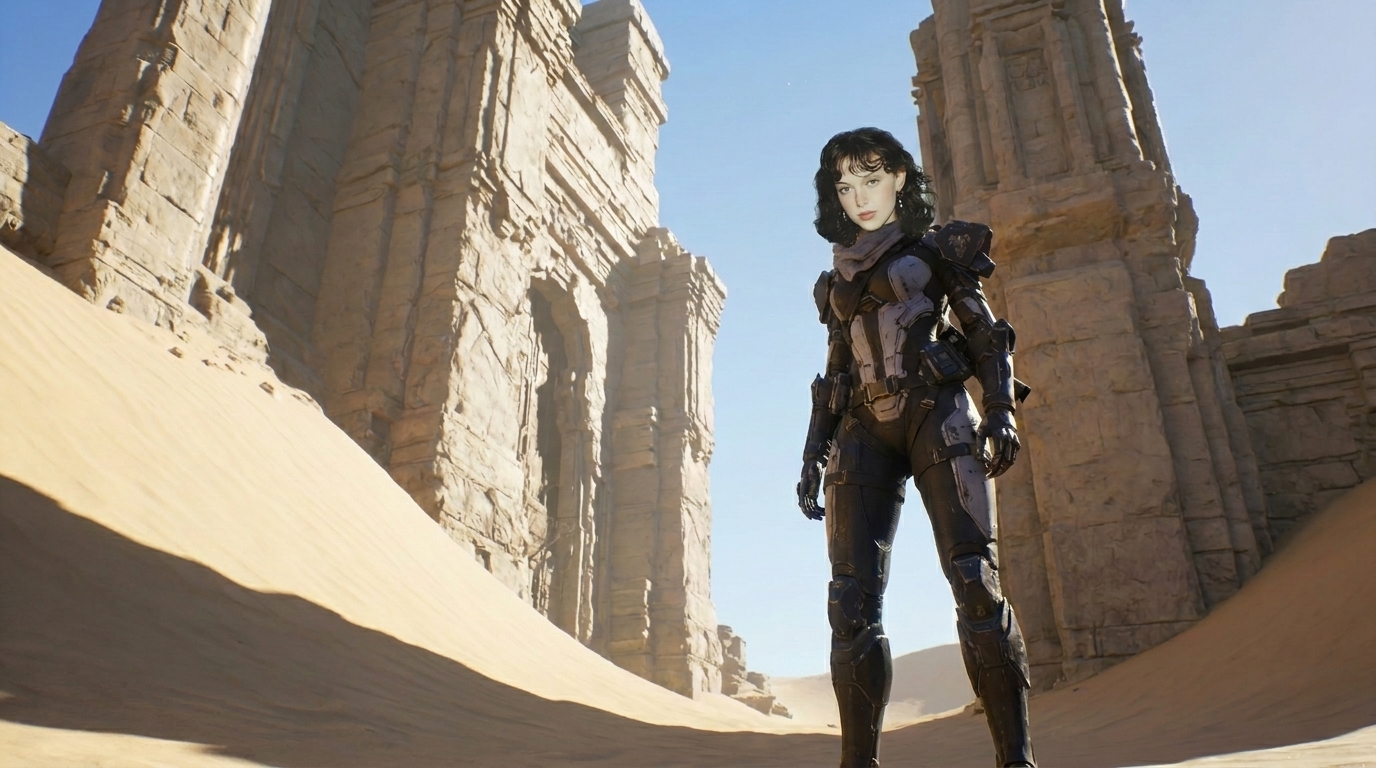
4.1 为什么换脸后会变成“大头娃娃”?
这就涉及到了图生图中局部重绘一个最致命、也最容易被忽略的硬伤:参考图的面部占比与选框不匹配。
场景还原:
我们来看全身构图比例协调的原图。
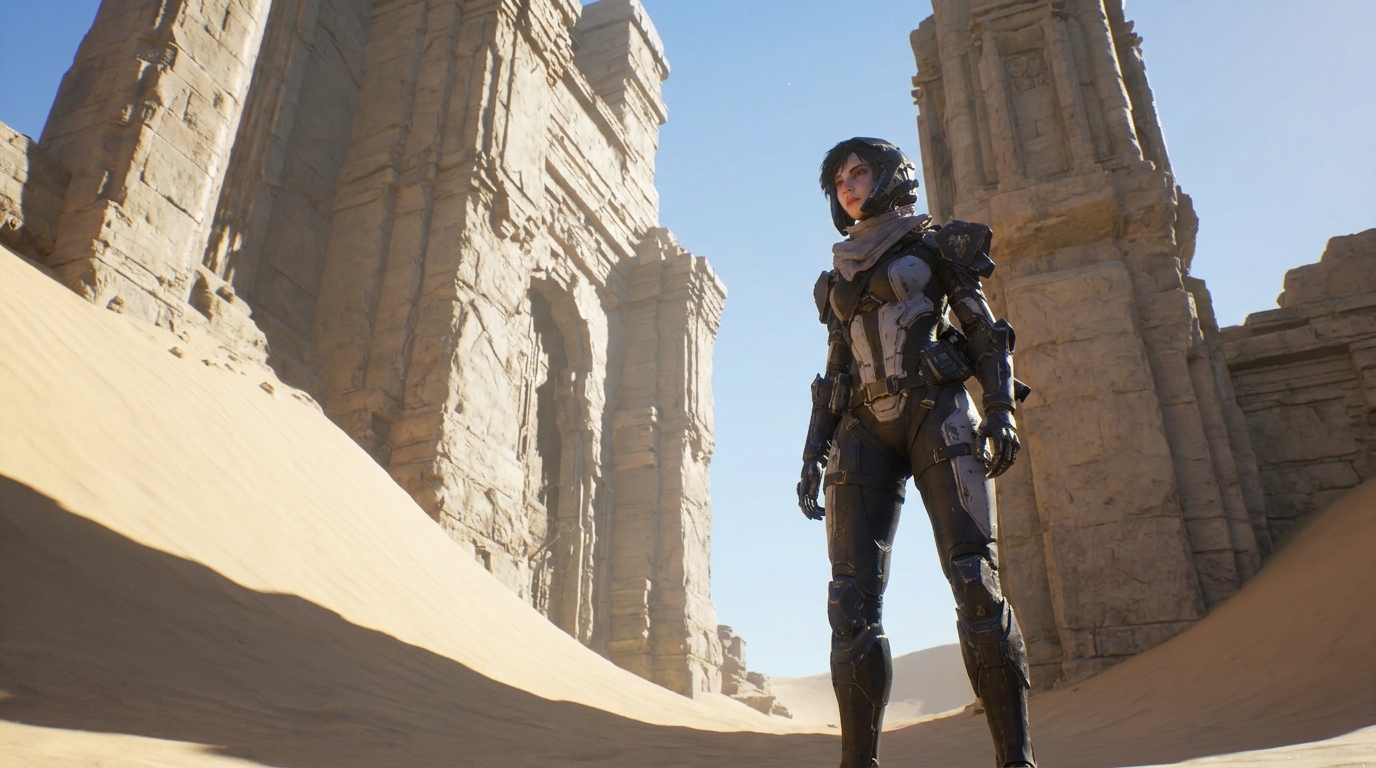
给AI喂了一张参考照片(比如你自己的脸或模特设定),是一张“极度的脸部塞满画面的大头特写”。
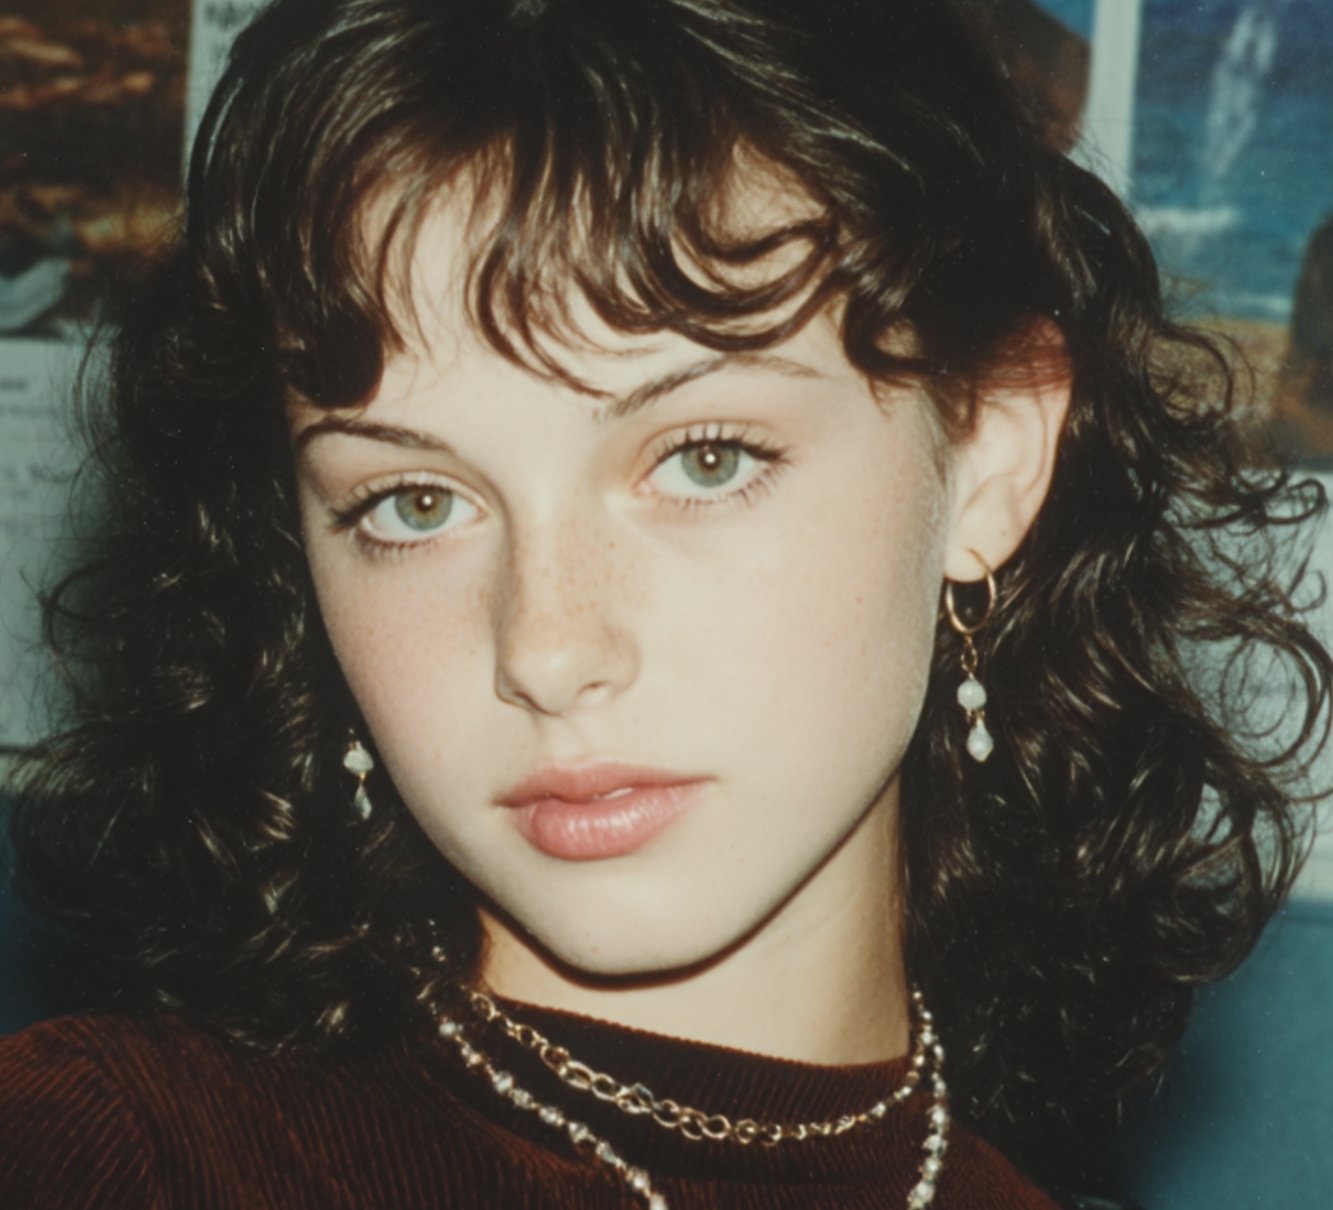
AI的死脑筋逻辑: AI在处理图生图时,会严格参考参考图的“构图逻辑”。它看到你的参考照片里人脸占了90%,于是它就把这张脸强行拉伸和放大像素。
4.2 一秒解决比例崩溃:对齐占比的两条路径
不需要去调整权重参数,解决这个问题有最直观的物理方法:
精准替换:使用人脸画面占比较小的图片去生成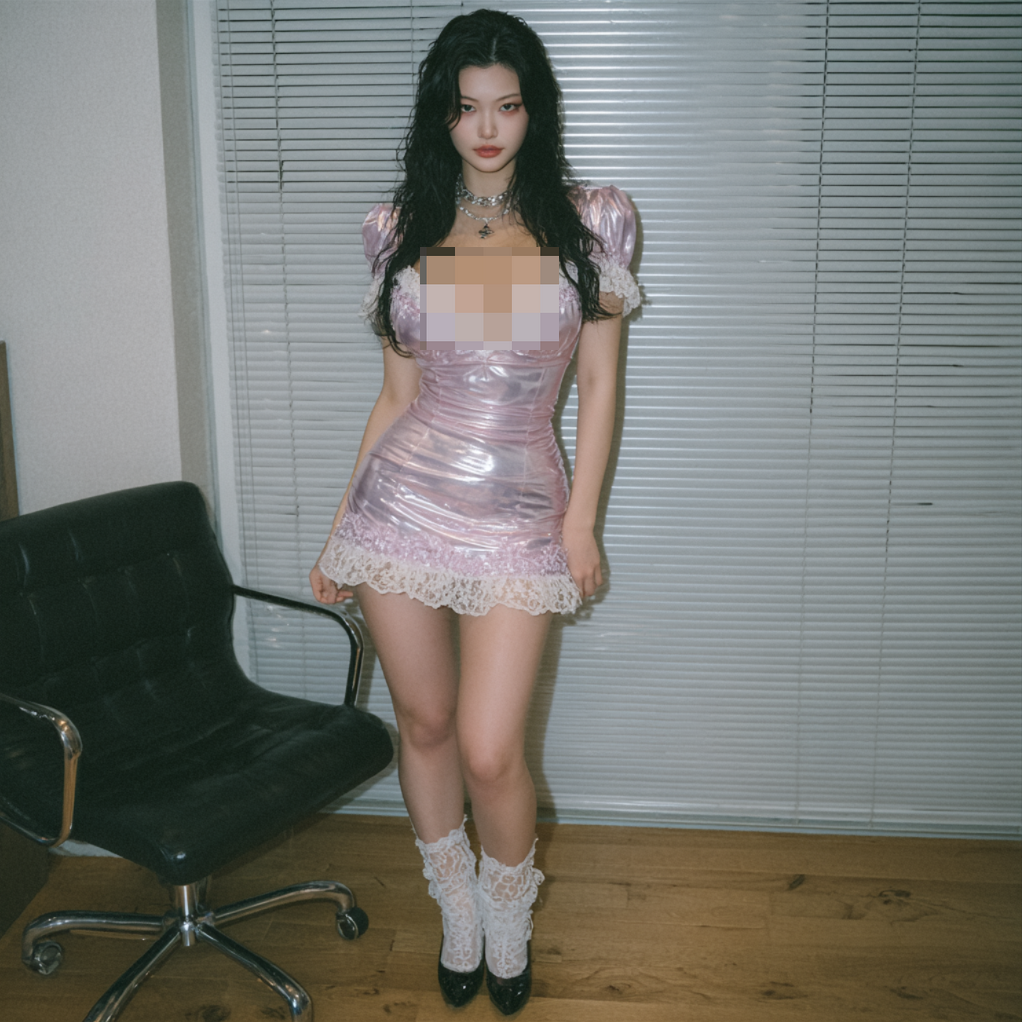
直接进行替换。
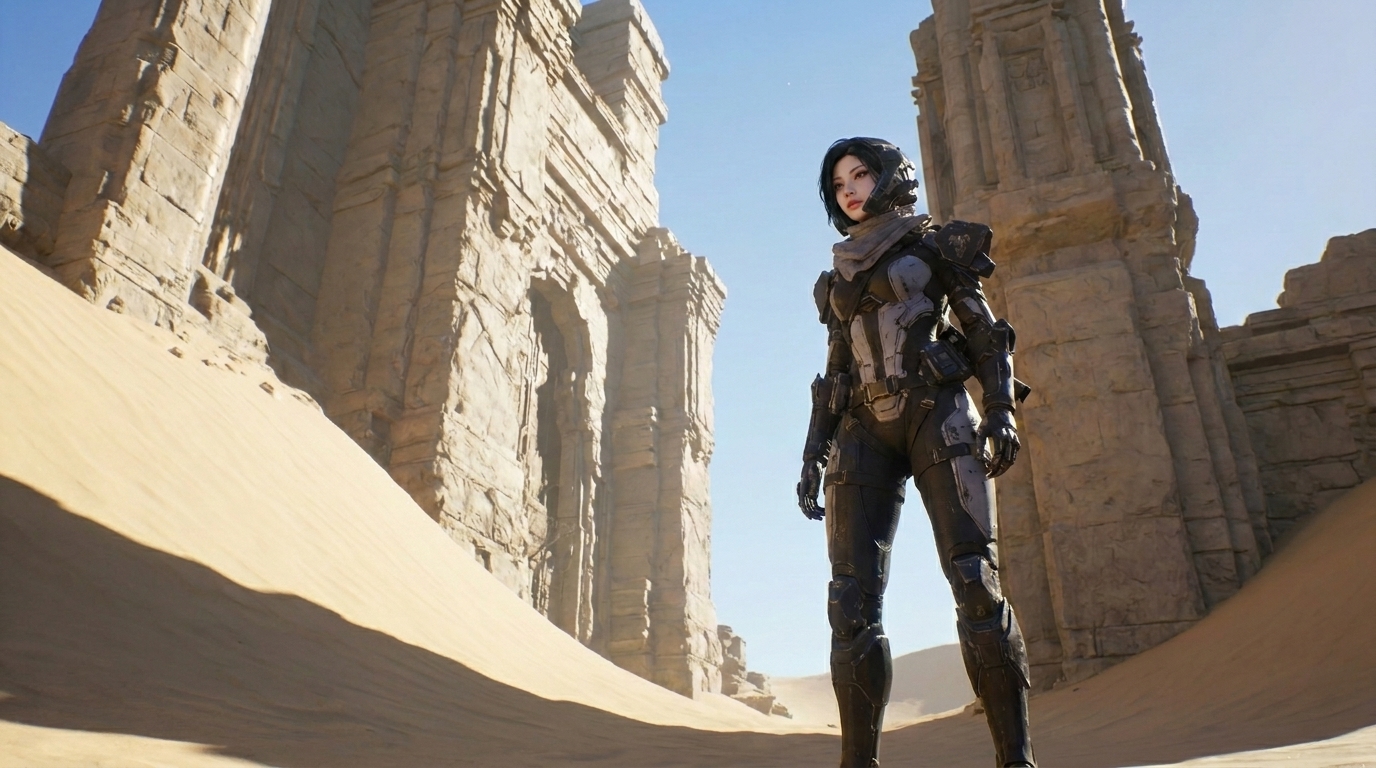
第五章:总结
AI绘图工具的算力和对基础图像的理解已经极其强大。在面对图生图的合成时,我们不需要再妄图用一大堆冗长晦涩的提示词去“求”AI给出正确的比例。
记住核心口诀:“提示词定内容,选框定比例”。 想要纵深感,框就画小点;想要多层次,大框套小框;想要完美换装换脸,参考图的面部占比要和选框对齐。掌握了这套最直观的视觉引导逻辑,无论你是做硬核战术射击、奇幻RPG公会还是角色立绘设计,都能精准掌控每一个元素的命运,让你的作品彻底摆脱AI的塑料感,拥有大师级的真实硬核构图!
提示词结构执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课的重点不是堆形容词,而是围绕「精准掌控画面人物比例」把提示词写成能执行、能复用、能检查的结构。
按原文节奏走最稳:先吃透「第一章:图生图合成的“认知障碍”:为什么AI读不懂你想“放”哪里?」,再把「第二章:单个人物精准卡位——从“语义参照”到“区域控制”」定住,接着处理「第三章:多人物图生图——透视与互动的“多框法则”」;最后用「第四章:细节进阶——彻底告别“大头娃娃”的换脸陷阱」收口。
- 先把「第一章:图生图合成的“认知障碍”:为什么AI读不懂你想“放”哪里?」里的变量写全。
- 这一段别堆词,先把作用分清。
- 做完「第三章:多人物图生图——透视与互动的“多框法则”」后,把可复用句子留下。
- 先把「第四章:细节进阶——彻底告别“大头娃娃”的换脸陷阱」提到的误区排掉,别踩同一坑。
不要只堆形容词;提示词要写清主体、场景、镜头、光线、动作、限制条件和验收标准。
检查提示词是否有清晰主体;是否说明画面关系;是否有可执行动作;是否包含避免跑偏的限制条件。
请围绕「精准掌控画面人物比例」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:提示词结构拆解、中文提示词、英文提示词、负面限制词、生成后修改建议和自检清单。要求每个词都有明确作用。