
在接触AI视频生成的过程中,你是否遇到过这样的情况:
精心撰写了长达几百字的提示词,把能想到的细节全写了进去,但AI生成的画面却完全偏离了你的预期?
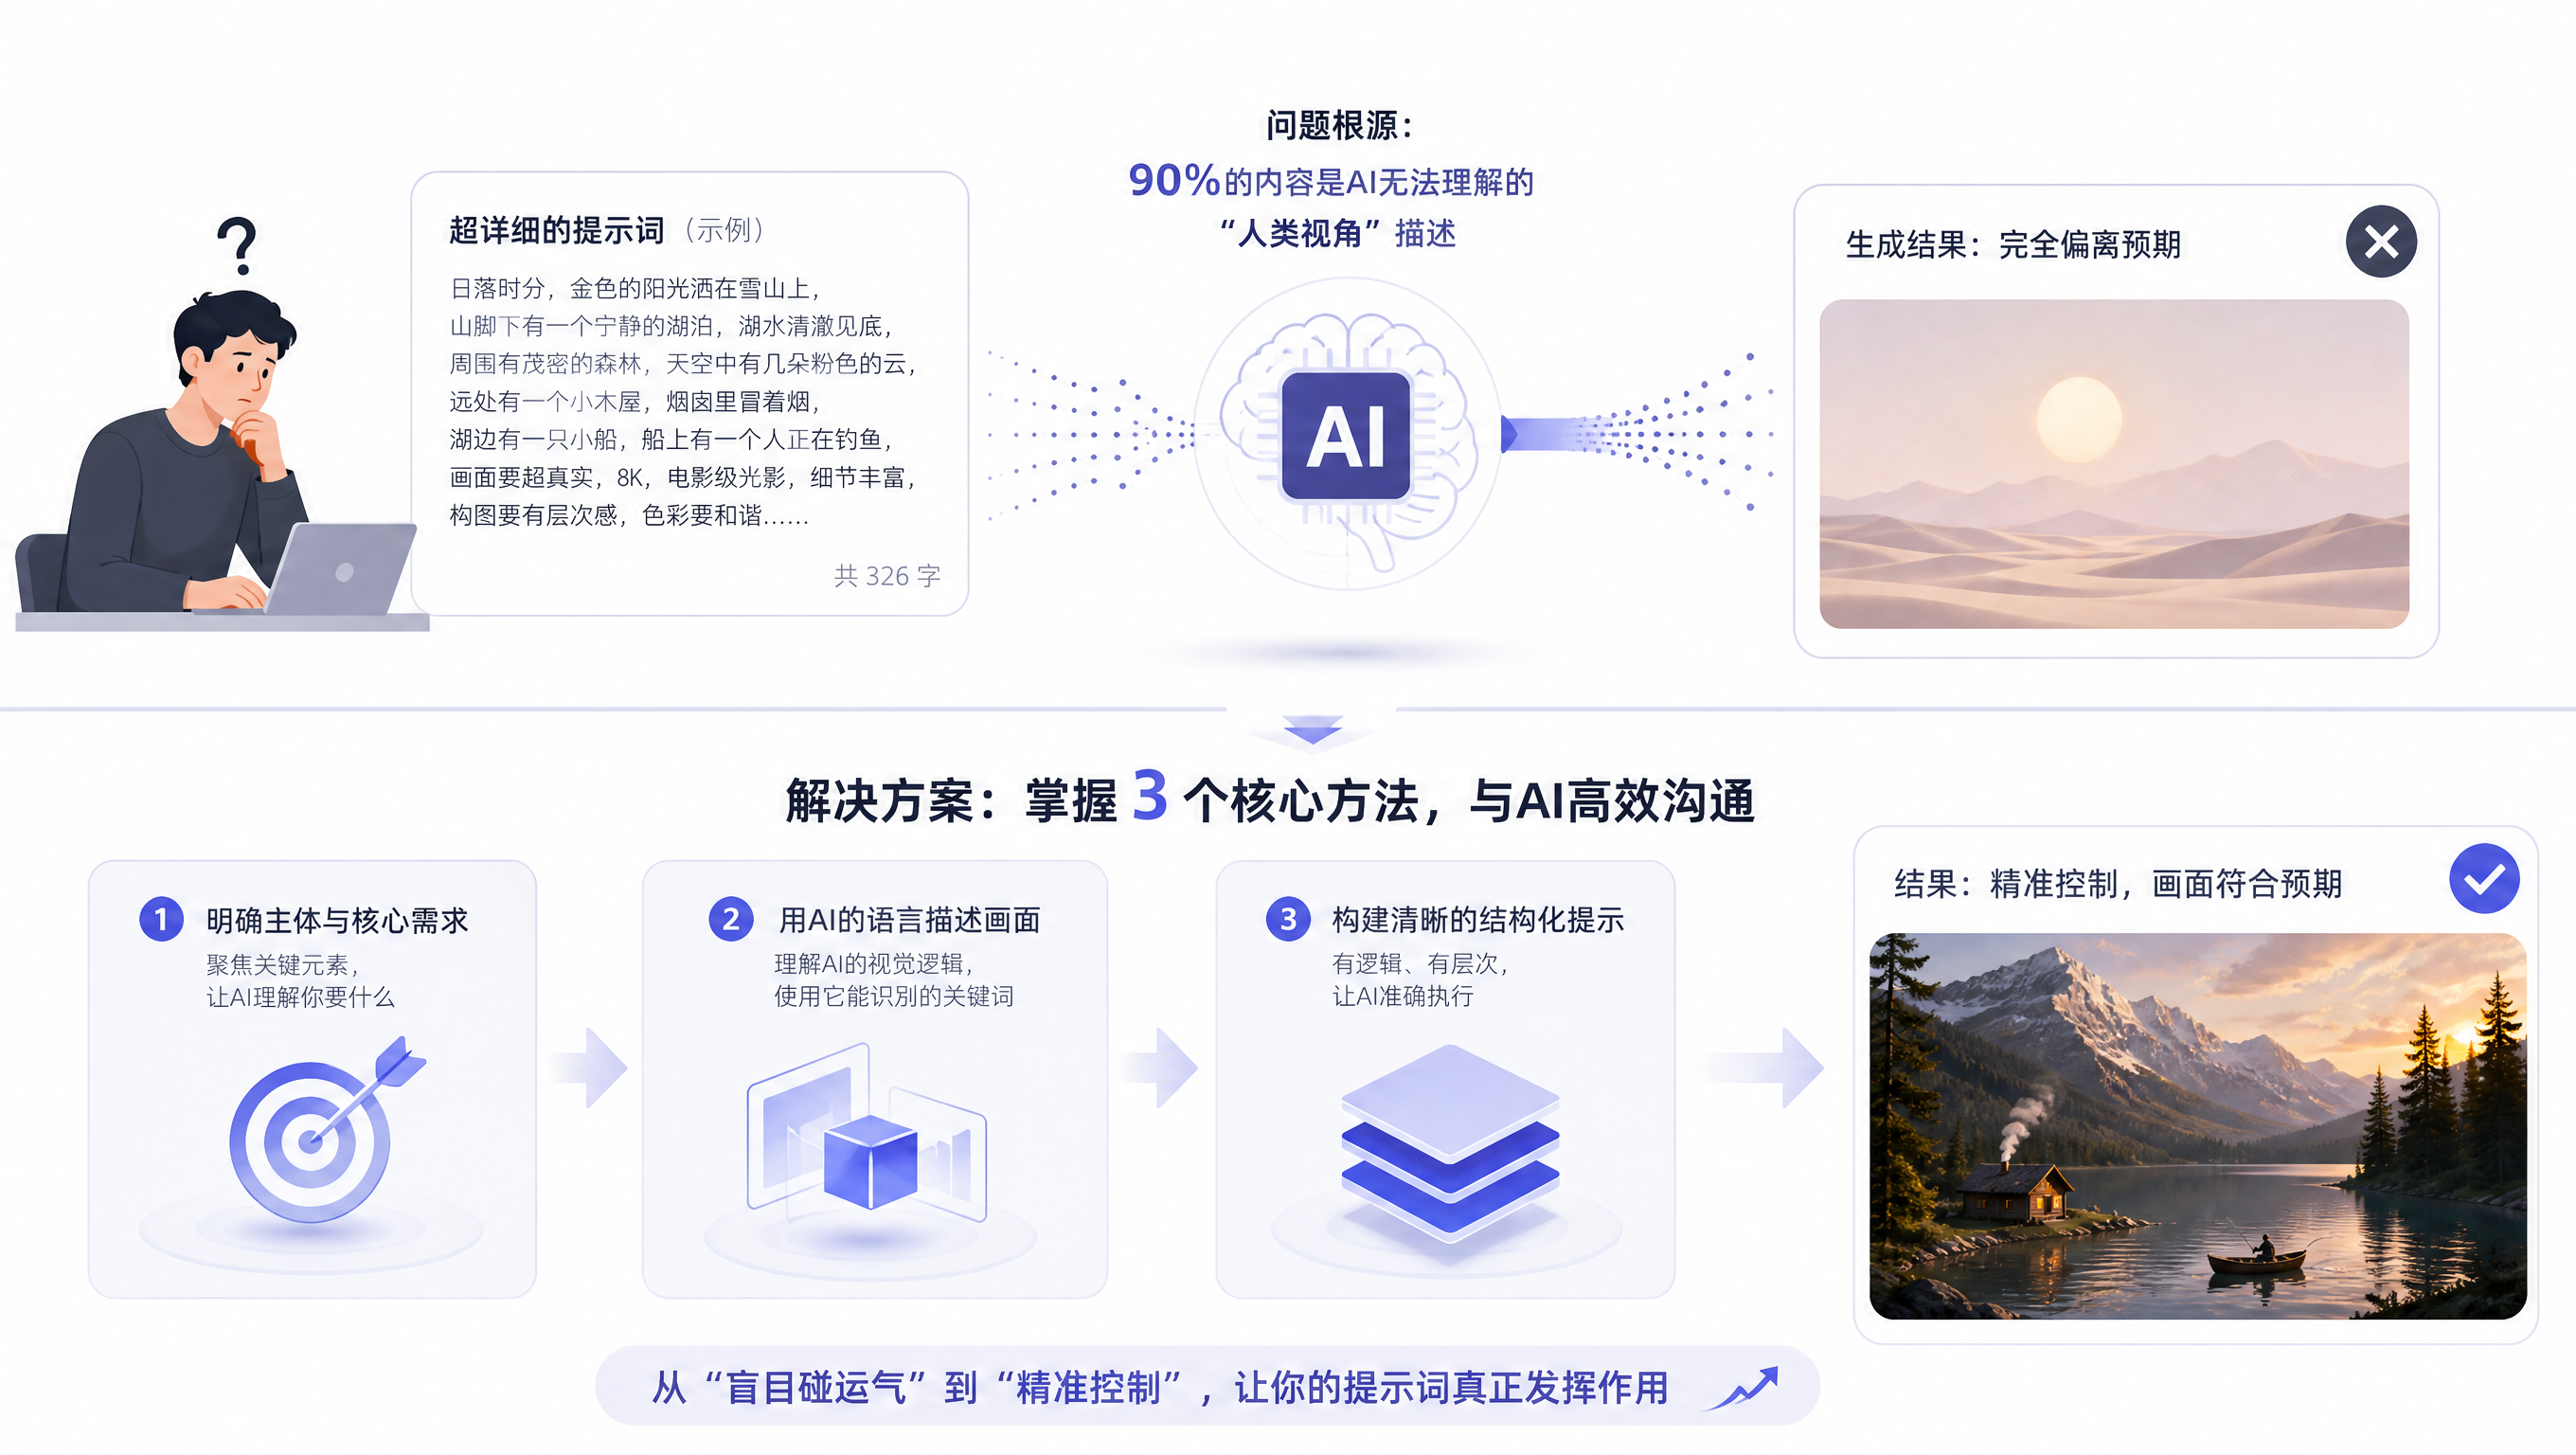
其实,这并不是AI不够聪明,而是因为我们的大多数提示词有90%都是无效的。看似提供了海量的有用信息,但AI底层的视觉渲染逻辑根本无法理解这些“人类视角”的描述。
今天,我们将通过解析大家在日常操作中最常犯的3个核心错误,带你重新梳理与AI沟通的底层逻辑。掌握这三个方法,你的提示词将从“盲目碰运气”升级为“精准控制”。
错误一:大量堆砌无用提示词,忽视首帧权重与视觉参照
很多人在进行“图生视频”时,习惯性地把文本生成图像的那套逻辑搬过来,用大量的风格词去描述画面。比如在提示词里堆砌“超写实、电影级光影、8K分辨率、高级质感”等等。
但事实上,在当前顶级的AI图生视频底层逻辑中,第一帧画面拥有“绝对的霸权”。
这一帧图片已经完全决定了你视频的视觉风格、光影结构和基础细节。盲目在视频提示词里堆砌风格词,不仅毫无用处,还会严重稀释你的“动作权重”。
1.风格词的冗余与与“算力浪费”
在图生视频的底层逻辑中,权重最高的永远是你的第一帧画面(即你上传的原图)。这一帧图片已经完全决定了你视频的视觉风格、光影结构和基础细节。
为了让大家直观理解,我们来看一张典型的测试原图:
画面中是一位穿着深色大衣的女孩,站在冷峻的冰雪荒原中,整体呈现出极其纯净的日系胶片蓝青色调。
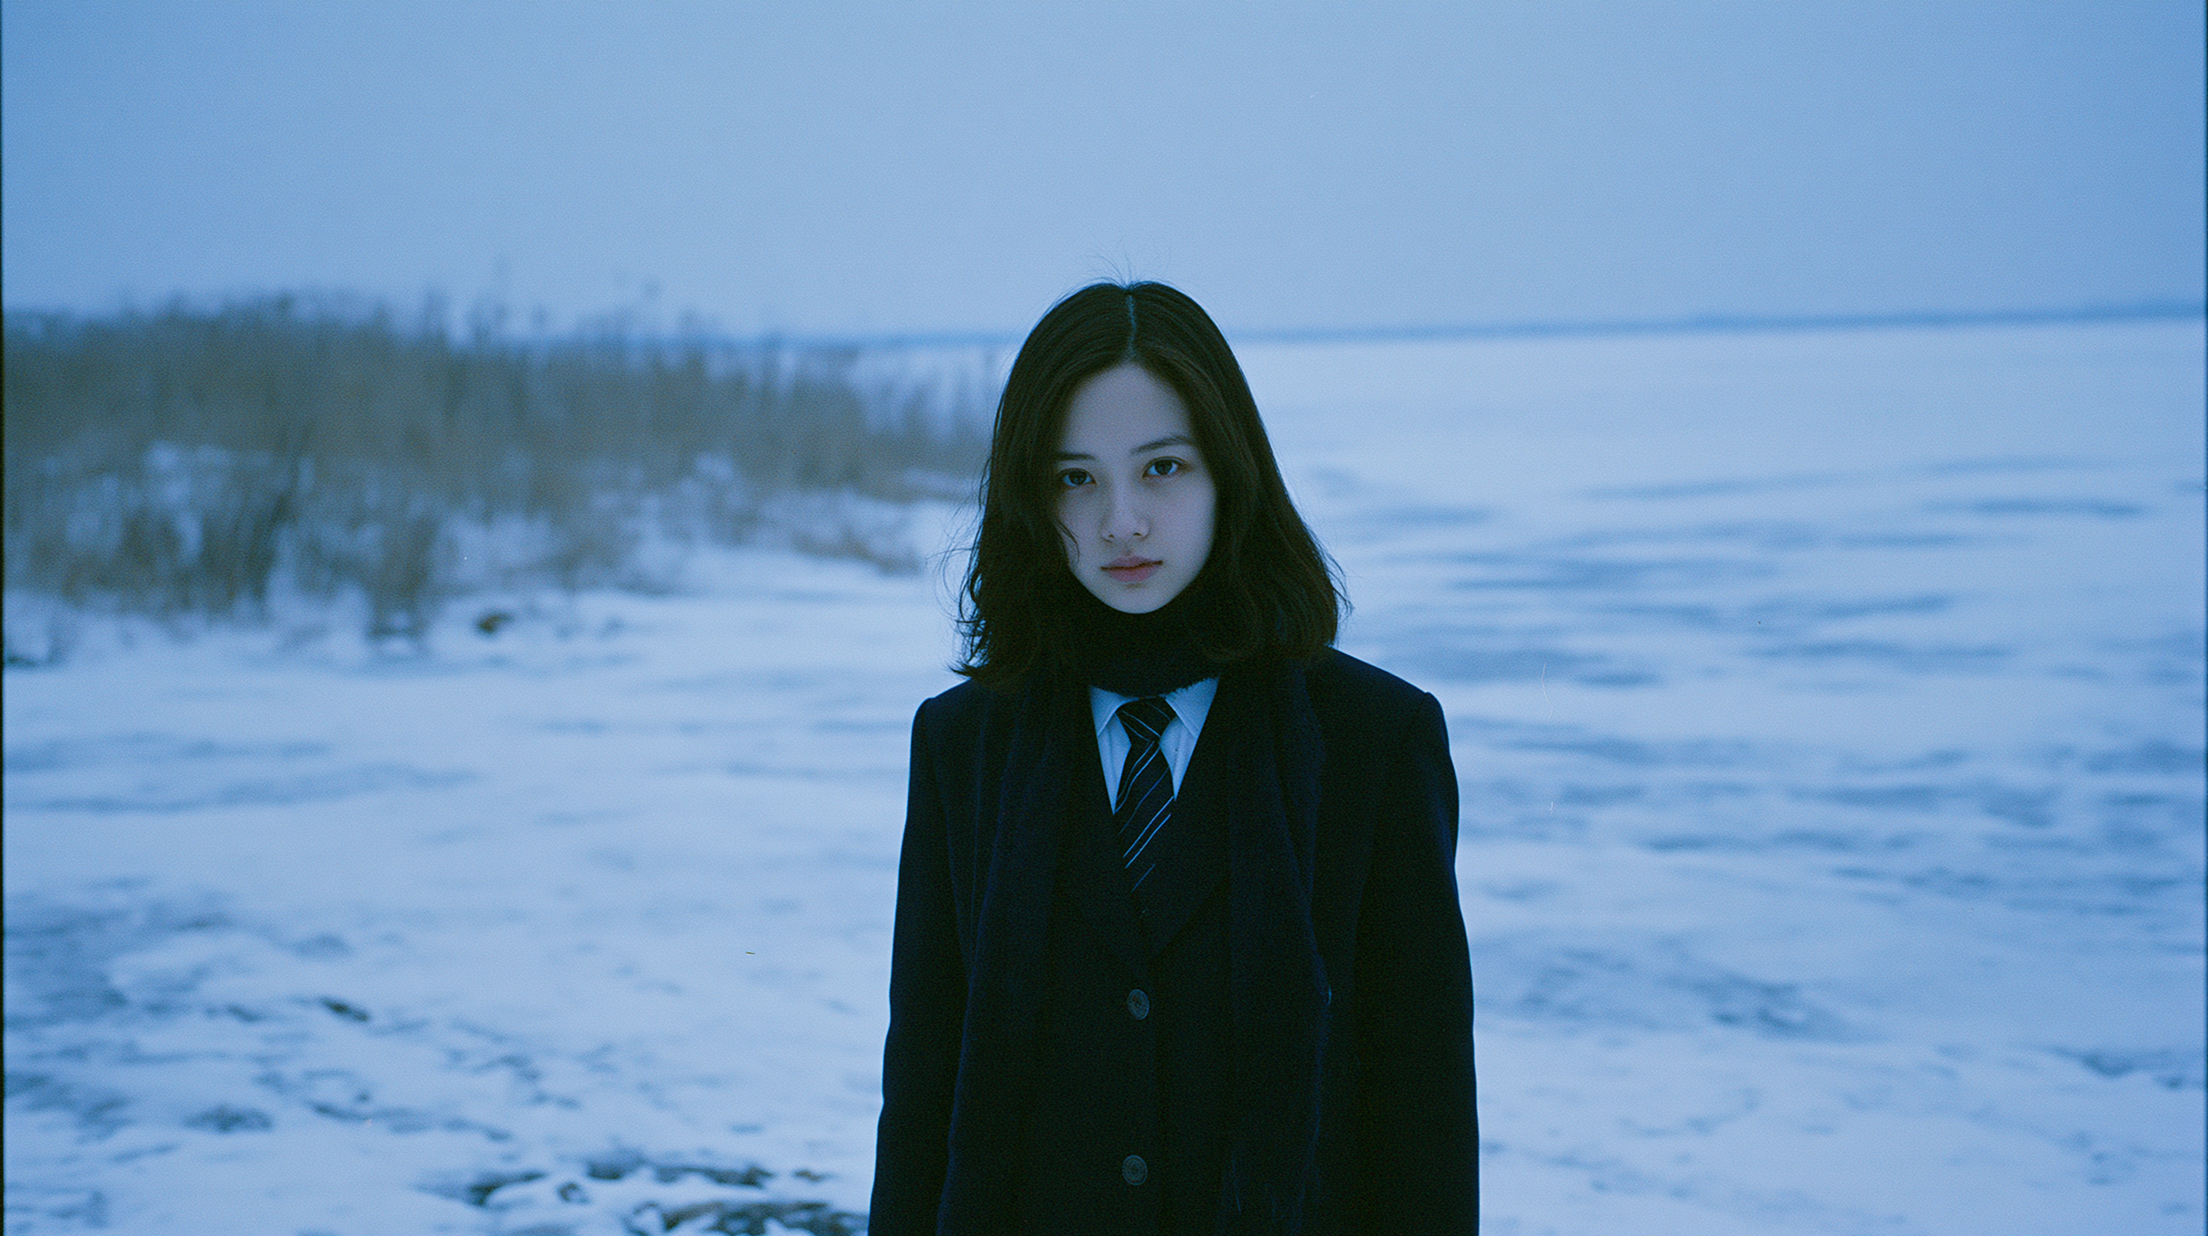
midjourney V8.1生成,图片prompt:
In the style of the movie *Love Letter*, featuring Shunji Iwai's aesthetics. A Chinese girl in a dark winter school uniform stands on a frozen lake. With a cold cyan-blue color tone, the picture is clean and minimalist, illuminated by the soft diffuse light of an overcast day, shot in 35mm film with a slightly grainy texture, embodying ultimate purity and restraint, and presented in 8K resolution.
当我们把这张图喂给AI视频大模型,并强行加入冲突的风格词时,看看底层的逻辑博弈是怎样的。
【反面案例】
错误提示词: “赛博朋克光影,虚幻引擎5(UE5)顶级3D渲染,极度清晰,超高质感,女孩缓缓转动一圈,最后看向镜头。”
雷区揭秘: 很多人以为加上“赛博朋克、UE5”会让画面更炫酷。但实际生成后你会发现,画面根本没有变成赛博朋克!
为什么?因为现在的AI非常聪明,它发现你的文字指令与上传的原图发生了严重冲突。为了保住原图的合理性,AI会直接把“赛博朋克、UE5、超高质感”这些词汇判定为“无效噪音”并强行屏蔽
(不过这种图片一般人不会加上“赛博朋克”这种提示词,主要是为了作为案例讲解)。
这意味着,你的提示词有80%的算力权重被白白浪费了。
【正面案例】
正确提示词:
女孩在雪地中缓缓转过身,目光自然地落向镜头。转身的瞬间,寒风轻轻扬起了她的发丝和深色的衣角。
解析:
彻底删去所有的渲染词、画质词和风格词。让AI明白,它的任务仅仅是驱动物理运动,而不是重新做视觉设定。我们将省下来的提示词权重,全部用来描述“目光”和“发丝扬起”等物理细节。这样生成的视频不仅能完美保持原图的冷峻胶片感,人物的动态也会变得极其丝滑和细腻。
2. 数值类指令的失效
除了风格词,另一个常见的无效堆砌是“绝对数值”。AI是没有现实物理世界度量衡概念的,它无法准确理解“降雪50毫米”或“移动5米”在当前画面比例中代表多少像素的位移。
【实操案例演示】化抽象数值为视觉参照
初始状态: 依然使用这张冰雪荒原的女孩图。
【反面案例】(踩中雷区:盲目写数值)
错误提示词: “风力达到了6级,非常大。女孩以每秒1米的速度向前走,走了大概5米的距离,眼神悲伤。”
雷区揭秘: “风力6级”、“每秒1米”和“5米距离”这些物理数值AI根本无法精确换算。
【正面案例】(正确优化:化数值为视觉参照物)
正确提示词:
“凛冽的寒风吹过,女孩的头发和领带被剧烈地向后吹起。大片雪花不断飘落在她深色的大衣肩膀上,她微微低头,呼出一口清晰的白雾。”
解析:
放弃具体的风力等级,改用“衣角被猛烈吹起”来体现风大;放弃具体的移动距离,用“向前迈出一步”和“踩出清晰的脚印”来给AI提供完美的物理空间纵深参照。这样人物的动作才会扎实,具有真实的重量感。
把重心放在上半身的细节互动上。用“微微低头”和“呼出白雾”这种细微的物理变化给AI提供完美的视觉参照。这样不仅完美契合了原图的景别,还让画面充满了真实的呼吸感和电影氛围。
错误二:提示词有冲突内容,导致AI逻辑摇摆
很多人的提示词看起来非常专业,写满了各种高级指令,但实际上内部充满了互相矛盾的冲突。这种情况往往发生在大家习惯性套用长文本模板的时候。
最典型的例子,就是很多人的提示词里,既写了“手持感镜头”,又写了“极其平滑的电影级推轨”。
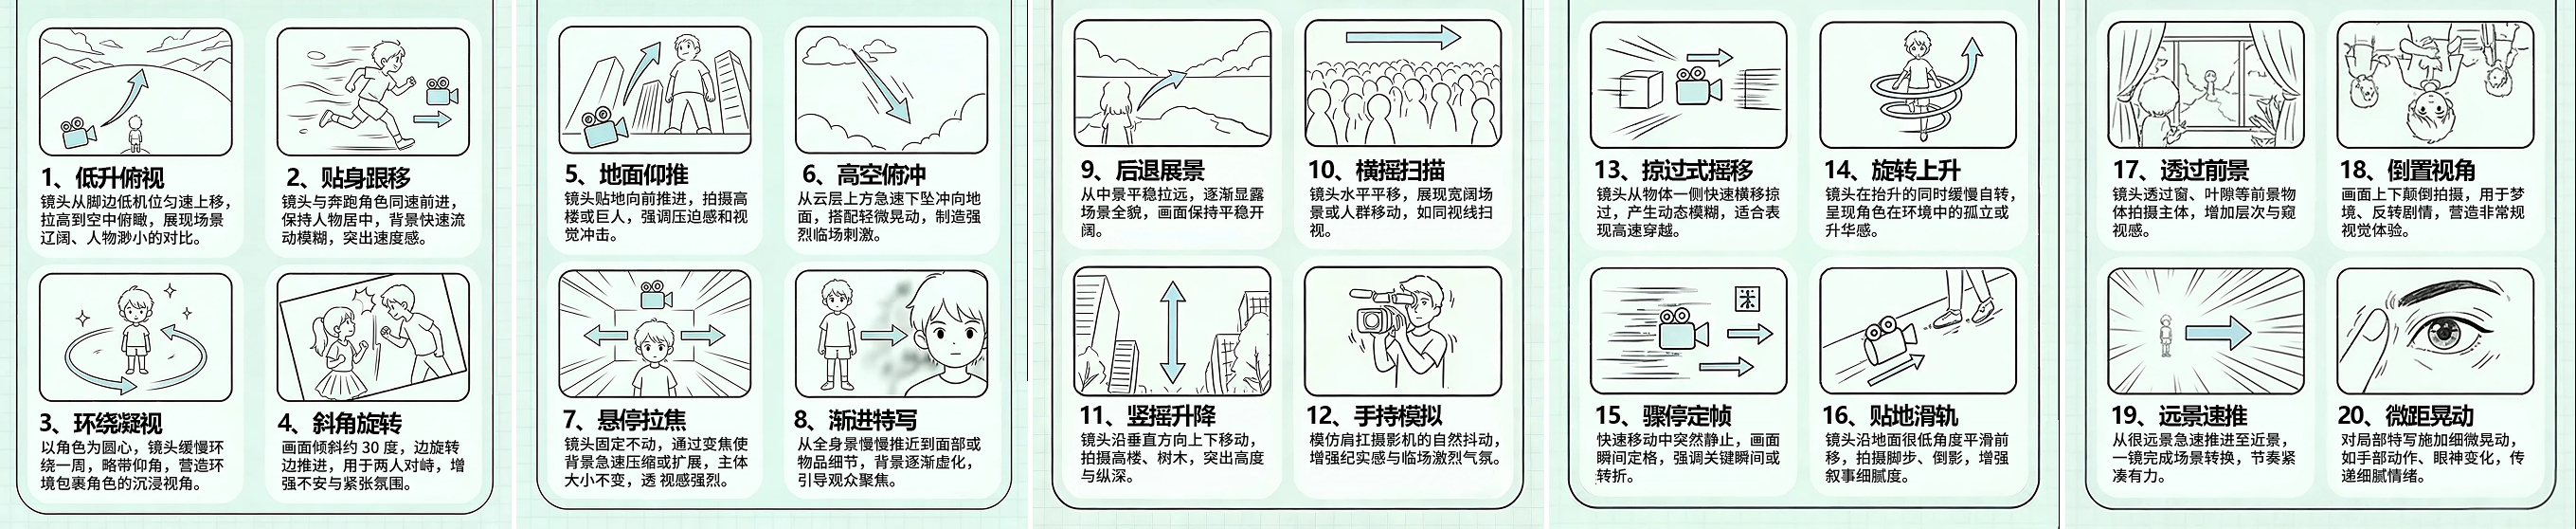
20种运镜提示词
我们必须明白,现在的AI视频模型已经非常聪明。当它面对这种完全对立的指令时,它不会像早期的AI那样发生“画面融化”或“扭曲崩坏”,它的底层处理机制变成了:强行中和,或者直接忽略。
既然你既要“晃动”又要“平滑”,AI干脆把这两个指令相互抵消,最后给你生成一个极其平庸、像PPT一样呆板的缓慢推镜头;或者当它发现你写的“高对比度影棚打光”跟原图的“柔和自然光”严重冲突时,为了保证画面的合理性,它会直接把你的打光词汇权重降为零(当做废话处理)。
最终的结果就是:你写了几百字的高级词汇,但你彻底丧失了对画面的精准控制力。所以我们在写提示词之前,要先想清楚,这个镜头到底是谁在主导,是情绪感还是广告感?
我们将这张室内看书图作为案例。
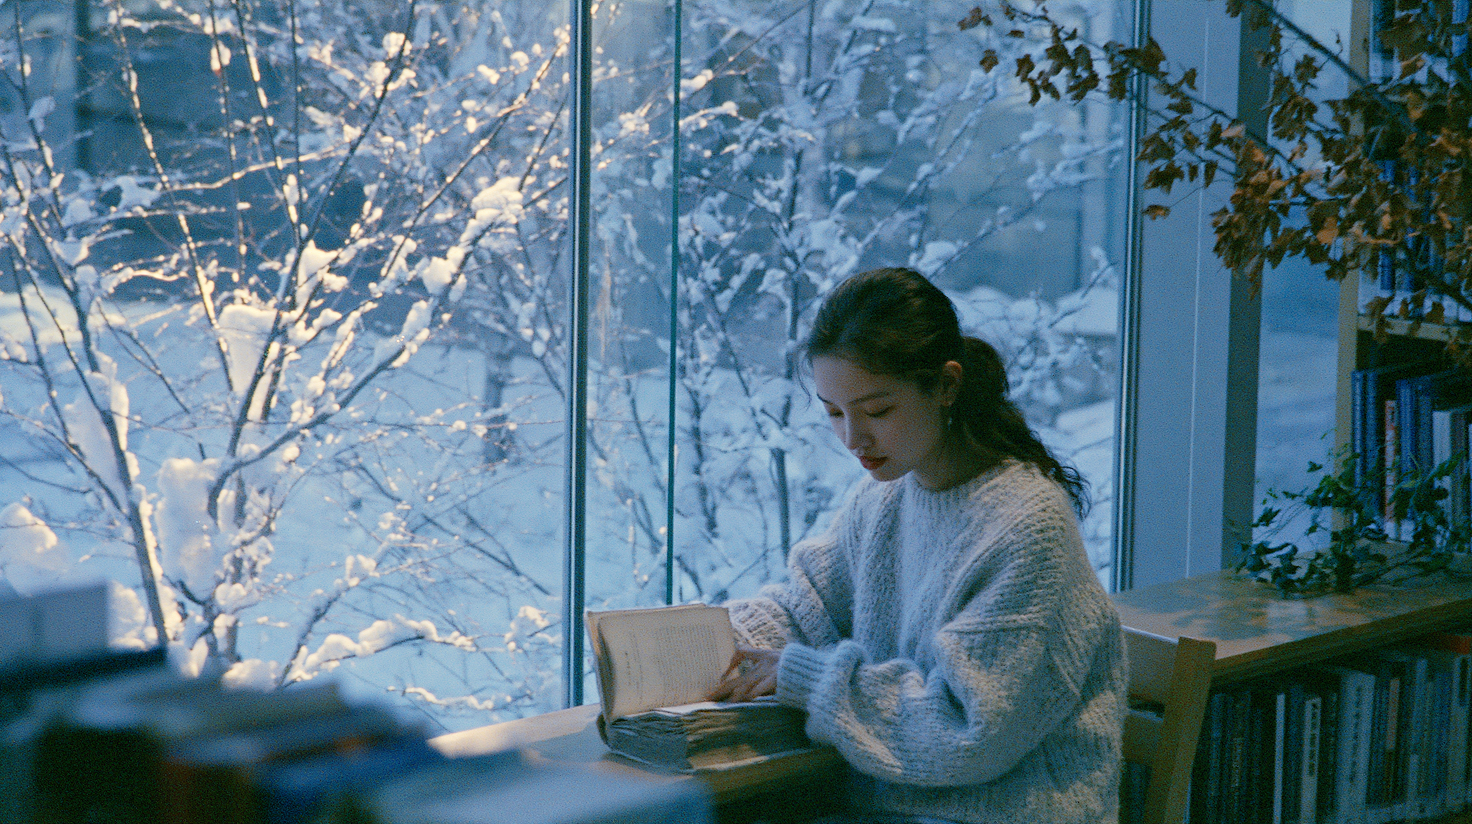
midjourney v8.1生成,prompt:
Cinematic shot, Shunji Iwai's "Love Letter" movie aesthetic. A Chinese girl wearing a vintage thick-knit sweater sitting quietly at a wooden desk by a library window, looking down and flipping through an old book. Outside the window are snow-covered branches and soft overcast light. Cold blue and cyan tones, minimalist composition, 35mm film grain, melancholic and nostalgic atmosphere, 8k,
图生视频控制(演示“专业词汇堆砌”导致的控制力丧失)
进入视频生成阶段,我们来看看很多人为了追求“电影感”而写出的真实冲突指令。
【反面案例】(踩中雷区:运镜与光影逻辑严重冲突)
错误提示词: “电影级运镜,强烈的肩扛手持镜头展现情绪张力,同时镜头缓慢且极其平滑地向前推进。极具戏剧性的高对比度影棚打光,女孩静静地翻书。”
雷区揭秘: 这段提示词汇集了网上最火的“万能词汇”,但在现在的AI面前,它是一段“无效指令”:
1.运镜互相抵消:
“手持晃动”和“平滑推进”是相反的轨迹。强大的AI不会让画面崩溃,但它为了平衡这两个词,最终只会给出一个毫无生气的、缓慢且僵硬的匀速平移。你想要的“情绪张力”完全出不来。
2.光影指令被无视:
原图明明是“柔和的阴天自然漫反射光”,你却硬要加“影棚打光”。现在的AI为了维持首帧的物理合理性,会直接屏蔽你这句打光指令。你浪费了算力和字符,却没起到任何作用。
【正面案例】(正确优化:做减法,确立“静谧感”单一主导逻辑)
正确提示词:
“固定机位。维持原有的柔和自然光。女孩的手指轻轻翻开书的下一页,眼神依然专注在书本上。”
解析:
1.统一视觉主逻辑:
既然原图的基调是“安静、内敛”,那我们就确立“静谧感”为主导逻辑。果断删掉所有晃动、推轨等容易造成干扰的运镜词,直接明确使用“固定机位”。AI接收到明确且唯一的指令后,执行会极其精准。
2.不干预光影,专注动作:
明确告诉AI“维持原有光影”,把所有的提示词权重都留给“翻开书的下一页”这个动作上。不堆砌废话,AI反而能把动作细节渲染得极其逼真。
错误三:同时下达过多指令,导致运动权重被无限稀释
很多创作者在写提示词时,习惯把所有动作指令塞进一句话里:既想要人物跑,又想要镜头转,还想要背景的东西漫天飞。
现在的顶尖 AI 模型虽然算力强大,不会轻易让画面崩坏,但当你指令超载时,AI 会变得非常“敷衍”。它会为了兼顾所有要求,强行平摊运动权重,导致结果非常平庸:镜头仅仅晃了一下,人物动作只做了一半,原本的大片感变成了毫无力度的“半成品”。
核心痛点:AI 视频的本质是“运动算力分配”。你需要把提示词从“一句话描述”升级为“分镜头脚本”。
【实操案例演示:雪地信件】
初始状态: 一张中景图,女孩蹲在雪地,前方散落着大量信件。
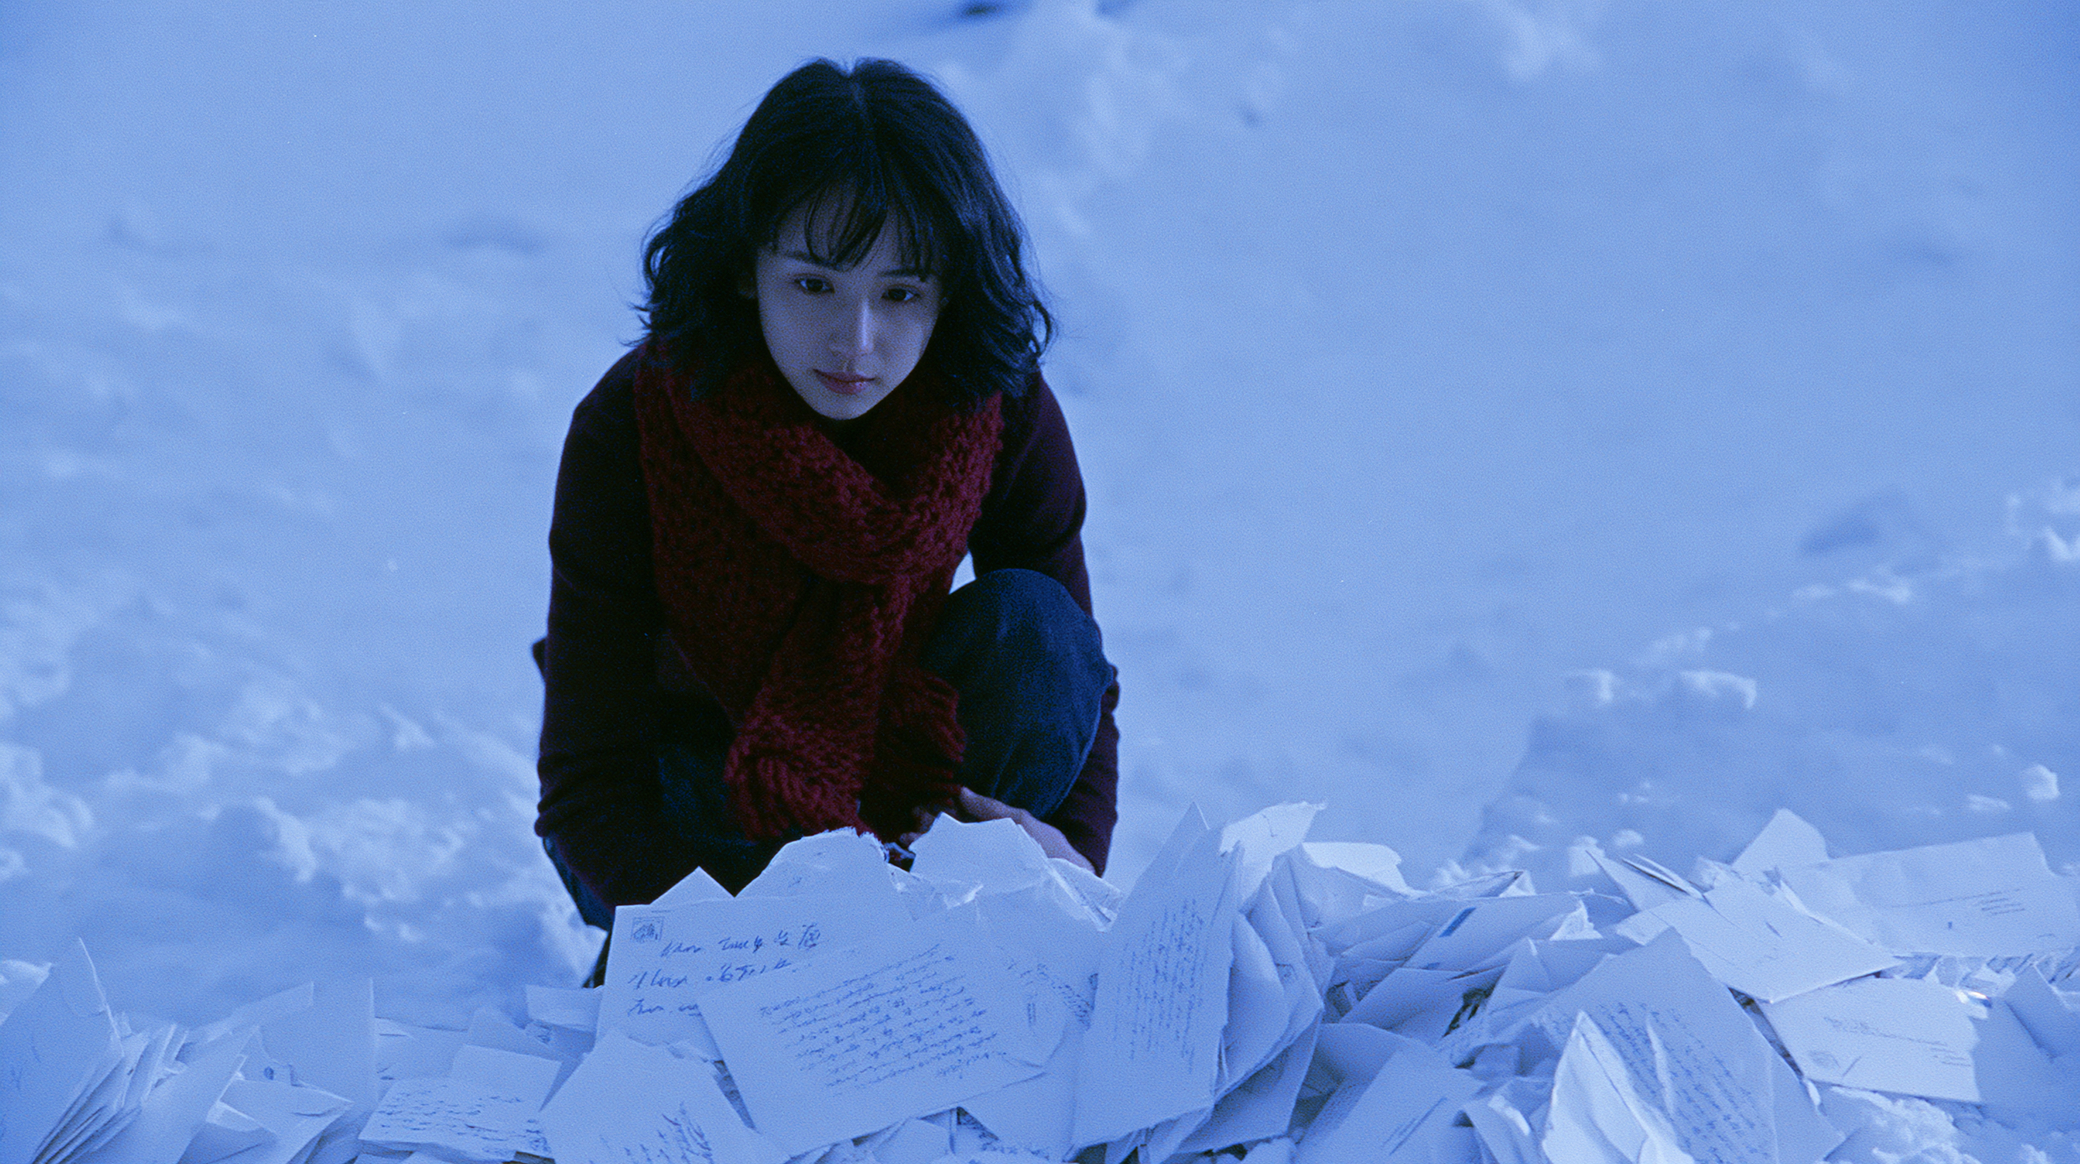
Midjourney v8.1生成,prompt:
Medium shot, Shunji Iwai's "Love Letter" movie aesthetic. A Chinese girl crouching in the pure white snow, scattered in front of her are dozens of white envelopes and letter papers. The girl wears a deep red knitted scarf, forming a sharp contrast with the cold blue and cyan snowy landscape. Minimalist composition, film photography grain, extreme purity and sorrow, 8k,
【反面案例】(一锅炖式的超载指令)
错误提示词: “一阵狂风刮过,地上的几十封信全部被卷起飞向天空。女孩猛地站起身来向前追赶,同时无人机镜头360度快速环绕。”
避坑指南: 这种写法在现在的 AI 面前不仅没有张力,反而很“奇怪”。因为没有先后逻辑,AI 会让所有动作在同一秒发生,导致信件飞得没力度,女孩站起像瞬移,镜头转动也显得突兀,完全丧失了电影的节奏感。
【正面案例】(进阶技巧:拆分元素 + 8秒时间线控制)
正确的做法是:用时间线的形式规定出具体时间里的具体运动,把环境、主体和镜头彻底拆分。
正确提示词:
[核心参数] 环境:细雪,清冷色调;镜头:固定机位(Static camera)。
[0-2秒] 氛围铺垫: 女孩保持蹲姿,低头注视信件,红围巾随微风轻微晃动。
[2-5秒] 物理交互: 强风突然袭来,雪面上的信件受力产生真实的物理翻滚和位移。
[5-8秒] 情绪爆发: 女孩感受到风力,缓慢自然地抬起头看向远方,红围巾和发丝随风剧烈飘拂。
为什么“时间线法”是降维打击?
1.算力精准投放:
通过分段,我们将 8 秒钟切成了三个任务。0-2s 算力给微动,2-5s 算力全给信件,5-8s 算力全给人物。每一秒 AI 都只有一个核心目标,动作才会扎实、精准。
2.建立因果逻辑:
因为起风了,所以信动了,所以女孩抬头了。这种逻辑链条是让 AI 视频摆脱“PPT感”、产生叙事张力的关键。
3.稳住空间感:
既然内部运动已经足够复杂,我们就锁死镜头。放弃无意义的环绕,把每一度算力都压榨在信纸翻动的细节上。
核心总结:
不要再给 AI 丢乱麻,要给它一份带时间轴的脚本。把人物、背景和镜头拆开写,规定好每一秒谁是主角。这种“分段式运动”控制,才是从“抽卡玩家”进阶为“AI导演”的分水岭。
总结:
1. 尊重首帧的“绝对霸权”
在“图生视频”模式下,第一帧已经决定了所有视觉基调。
2. 确立单一视觉主导逻辑
镜头必须有清晰的定位——要么是“情绪主导”,要么是“广告感主导”。
3. 引入“分镜头脚本”式时间轴
视频AI的本质是“运动算力分配”。
视频生成执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课不是先追求炫技成片,而是围绕「告别无效指令:AI视频提示词优化的三大核心法则」先把主体、动作、镜头和节奏稳住。
按原文节奏走最稳:先吃透「错误一:大量堆砌无用提示词,忽视首帧权重与视觉参照」,再把「错误二:提示词有冲突内容,导致AI逻辑摇摆」定住,接着处理「错误三:同时下达过多指令,导致运动权重被无限稀释」;最后用「总结:」收口。
- 把「错误一:大量堆砌无用提示词,忽视首帧权重与视觉参照」整理成可复制版本,后面直接复用。
- 把「错误二:提示词有冲突内容,导致AI逻辑摇摆」整理成可复制版本,后面直接复用。
- 做完「错误三:同时下达过多指令,导致运动权重被无限稀释」后,先查连贯性和穿帮。
- 先把「总结:」里的主体和动作定死。
- 这一段重点看镜头和节奏,别急着炫技。
- 做完「图生视频控制(演示“专业词汇堆砌”导致的控制力丧失)」后,先查连贯性和穿帮。
不要一上来就生成最终片;先拆镜头、定主体和运动,再逐段生成,否则容易跳轴、穿帮、节奏混乱。
检查主体是否稳定;镜头运动是否明确;前后画面是否连贯;节奏是否服务主题;是否有明显变形或穿帮。
请围绕「告别无效指令:AI视频提示词优化的三大核心法则」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:核心创意、分镜表、每个镜头的画面描述、视频生成提示词、剪辑顺序和成片自检清单。要求主体稳定、动作明确、镜头连贯。