一起来看一下成品:
准备工具
ChatGPT https://chatgpt.com/c/
nanobanan pro/nanobanan 2 https://labs.google/fx/tools/flow/
Midjourney https://www.midjourney.com/imagine
即梦seedance2.0 https://jimeng.jianying.com/ai-tool/
倘若不知道模型怎么使用,可以参考这个教程(https://www.super-i.cn/info-2796.html),与本教程一起使用
https://www.flowpix.club/bj/37017.html?token=8d17bfe10aadecc1f73e7d451c0e48a6
这套方法能解决什么问题?
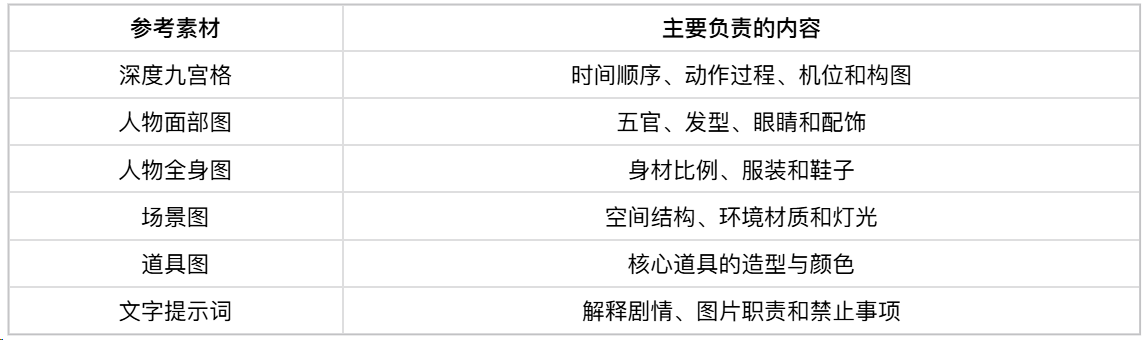
直接把普通九宫格交给视频模型,分镜图中的颜色、纹理、错误五官和画面噪点也可能影响成片。我的处理方式是先把九宫格转换成深度图,只保留人物轮廓、动作姿态、镜头构图和空间层次,再分别提供人物、场景和道具参考图。
每张图只负责一件事:
完整制作流程分为六步:
准备人物 → 设计剧情 → 生成场景与道具 → 制作九宫格 → 转换深度图 → 生成视频
第一步:准备人物参考图
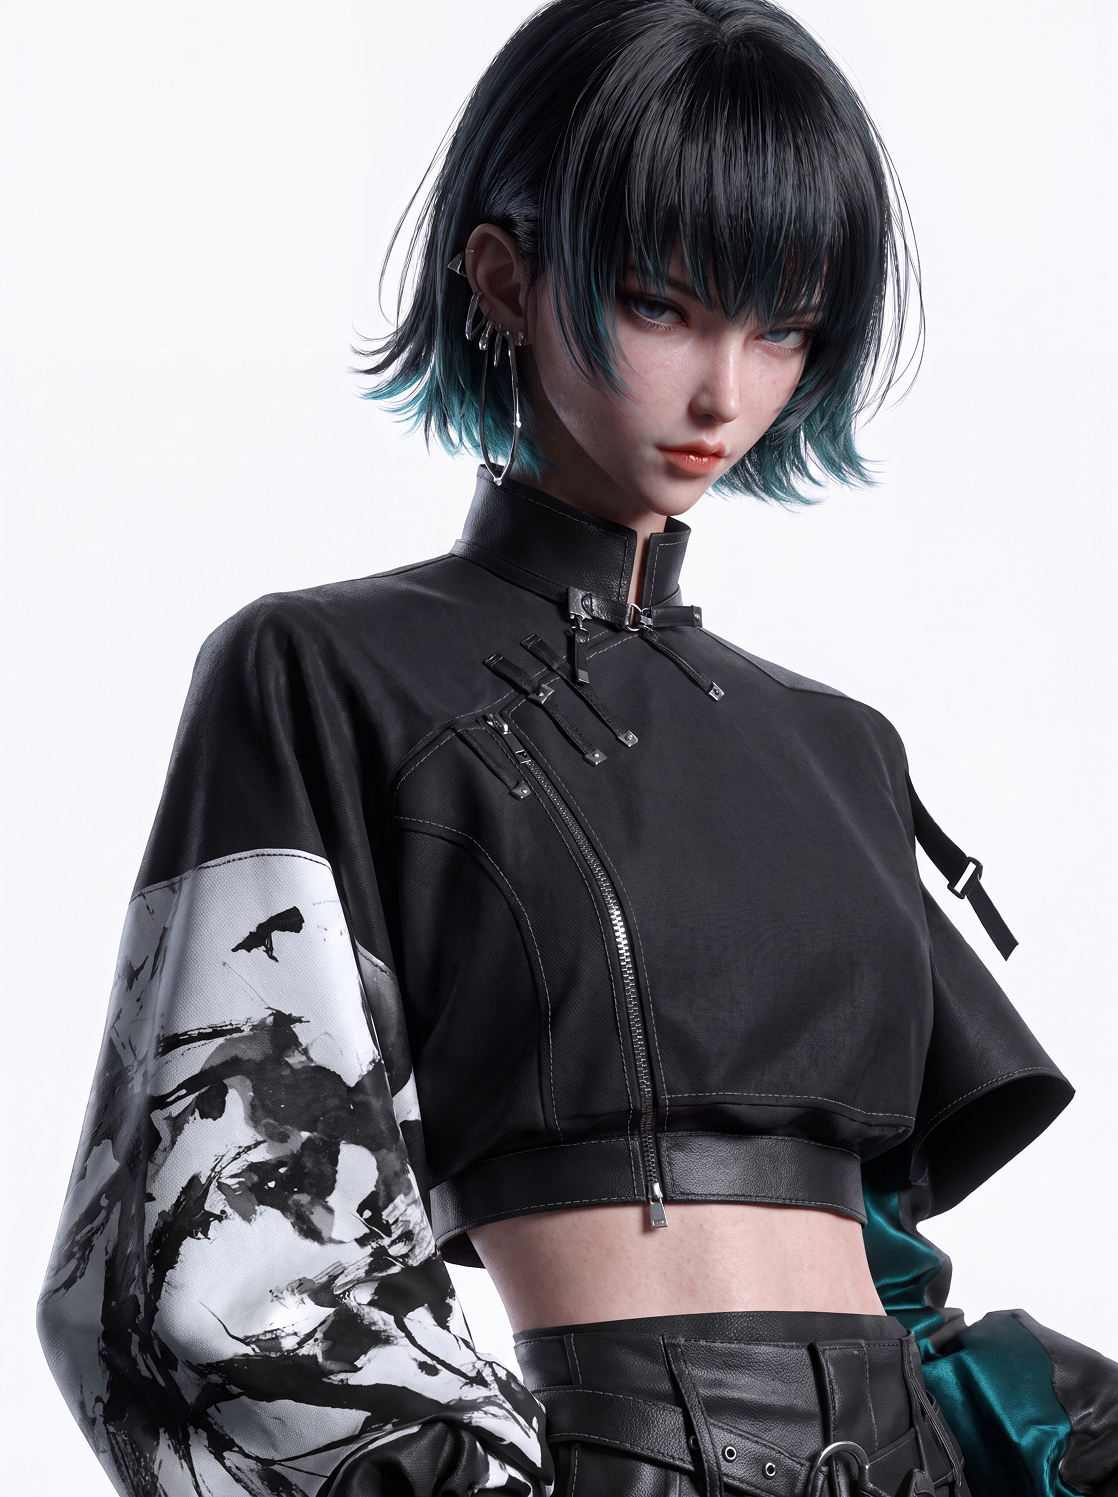
开始制作前,首先需要一个稳定的人物形象。
本次案例使用的是之前生成的写实3D CG人物(详细教程可看这一篇https://www.super-i.cn/info-2972.html)。
得到了这一张图片
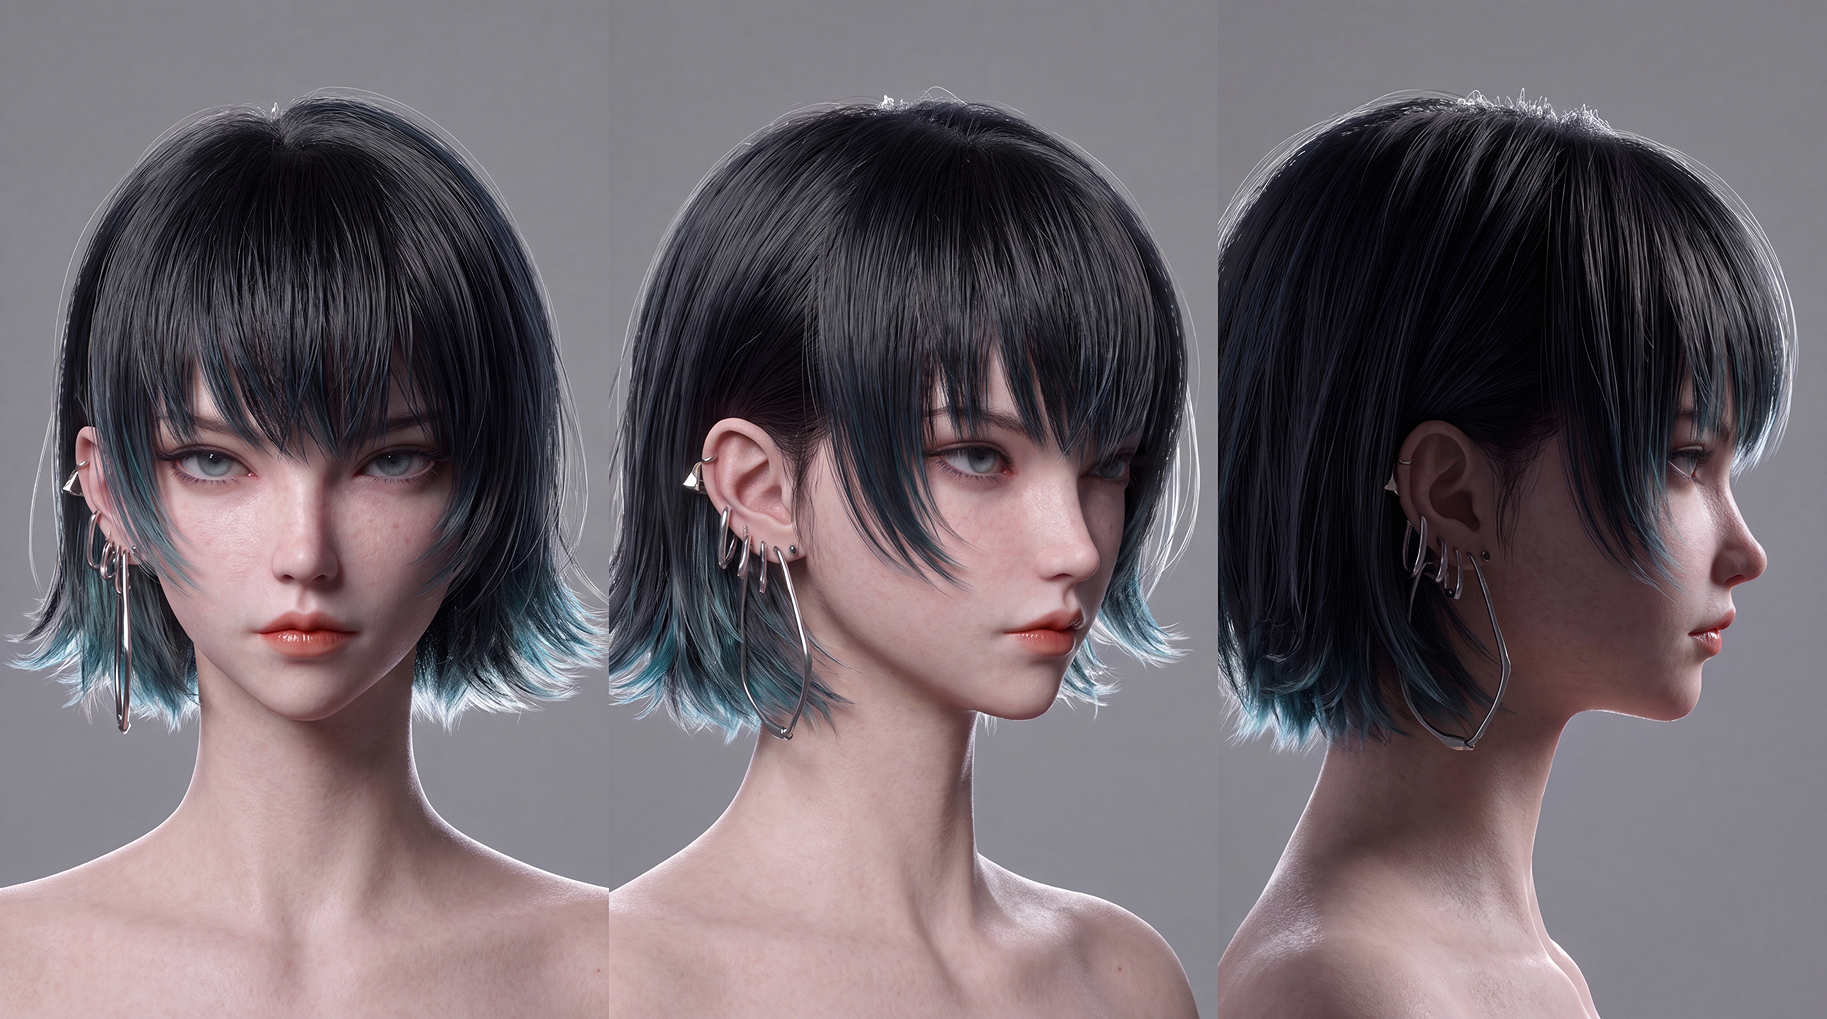
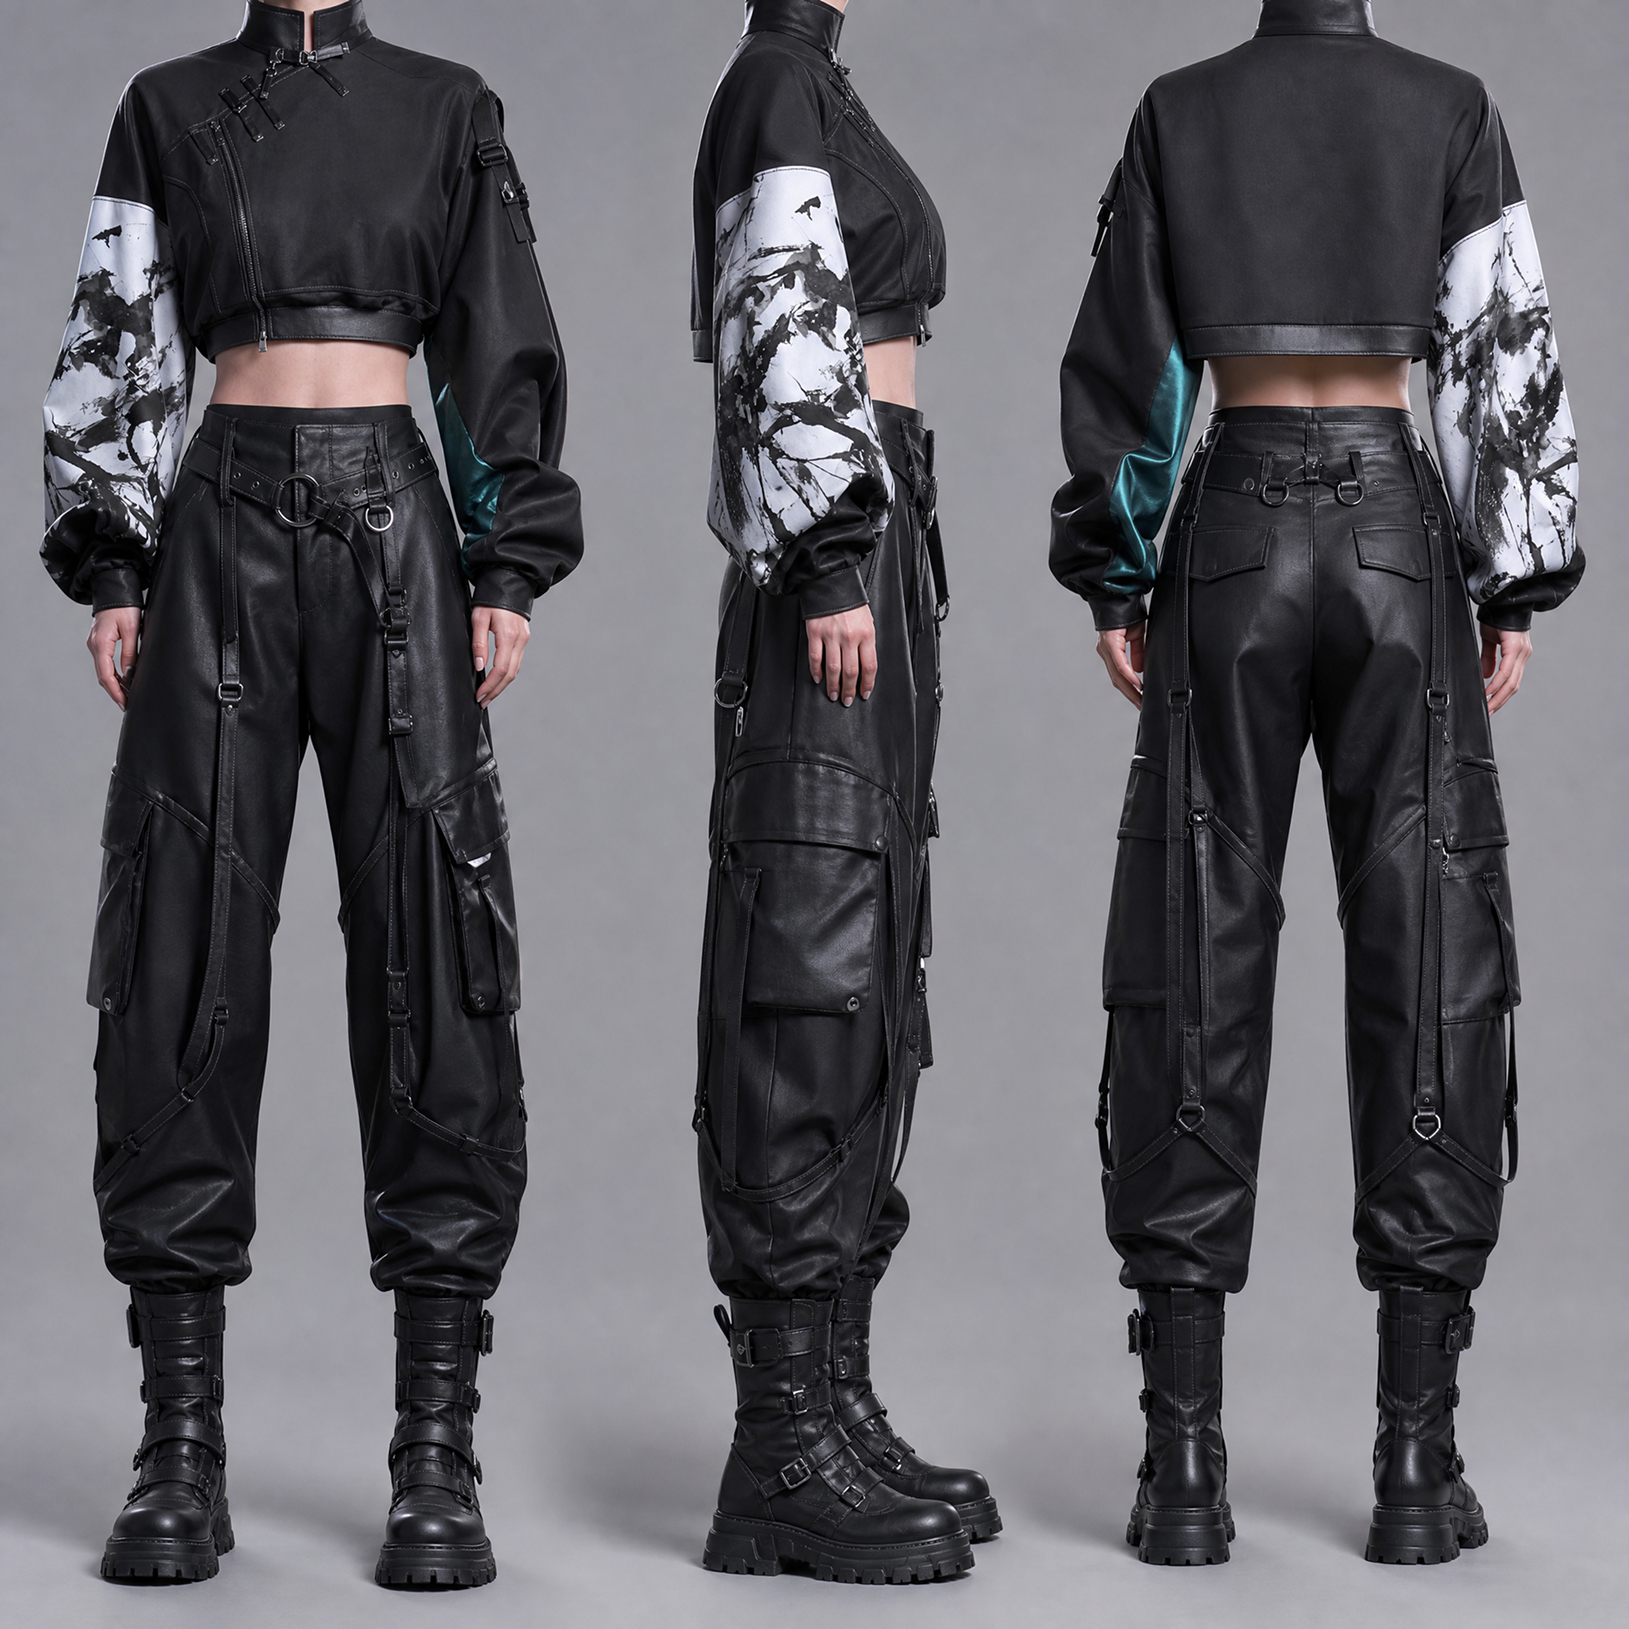
随后生成人物面部三视图和人物全身三视图(使用nanobanan pro)
面部三视图提示词:
生成人物的面部三视图,正面,半侧面,纯侧面,灰色背景,超清画质。光线只使用干净统一的摄影棚三点式打光:正左侧主光,正右侧辅助光,后右侧轮廓光。不要杂乱光效,不要彩色灯光,不要强氛围特效。背景为纯净灰色无缝影棚背景。
人物躯干三视图:
生成人物的全身图,正面,侧面,背面,灰色背景,超清画质。光线只使用干净统一的摄影棚三点式打光:正左侧主光,正右侧辅助光,后右侧轮廓光。不要杂乱光效,不要彩色灯光,不要强氛围特效。背景为纯净灰色无缝影棚背景。裁切掉头部,只留下身体
第二步:使用GPT设计15秒剧情
准备好人物后,将人物参考图上传给GPT等大语言模型,让它根据人物外形和气质设计一段15秒剧情。
15秒不能容纳太复杂的故事。比较适合的结构是:
明确目标 → 出现阻碍 → 做出反击 → 高潮结尾
本次案例中,女主的目标是带着数据核心离开货运平台;阻碍是无人机追击;反击方式是诱导导弹击落集装箱;结尾是女主利用集装箱斜坡跃上磁悬浮列车。
可以直接使用下面的剧情提示词:
请以我上传的人物为女主角,设计一段15秒的写实3D CG动作短片。
要求:
1. 剧情必须包含明确目标、外部阻碍、动作转折和高潮结尾;
2. 人物动作符合真实力学,适合AI视频生成;
3. 场景和关键道具数量尽量精简;
4. 不要加入复杂对白和过多人物;
请输出:
剧情梗概;
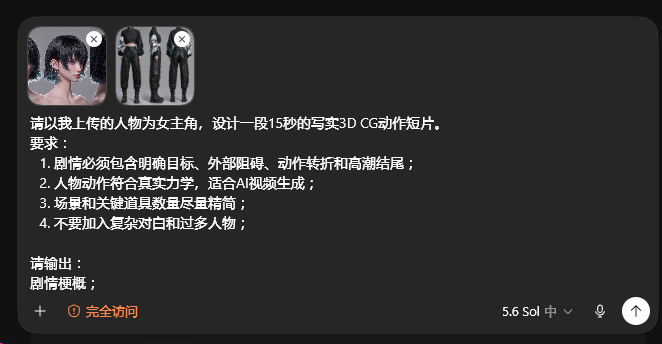
生成界面
本次生成的故事是:
女主夺取青蓝色数据核心后遭到无人机追击。她穿过云端货运平台的集装箱通道,利用追踪导弹击断悬吊集装箱的锁扣。集装箱坠落形成临时斜坡,女主沿斜坡助跑,跃上磁悬浮列车逃离。
第三步:反推并生成场景、道具
剧情确定后,让GPT根据动作反推出场景和道具提示词,再使用Midjourney V8.2生成图片。
1. 反推场景
接着对话,直接输入提示词:
再给我想一个场景,符合这个剧情,要符合Midjourney v8.2的编写结构
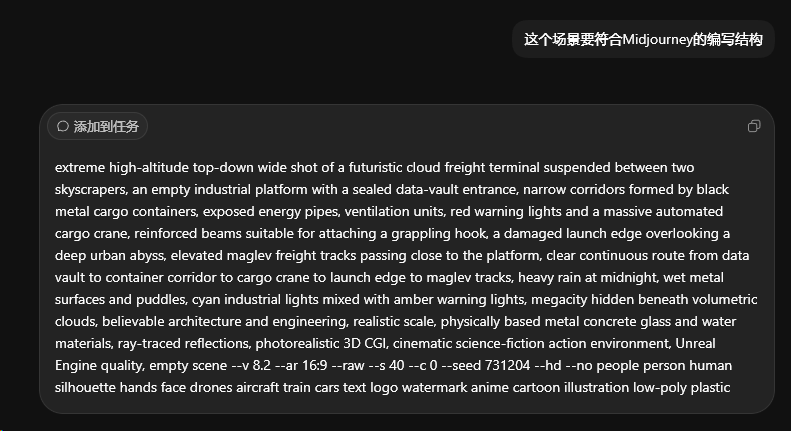
对话界面
生成的提示词如下:
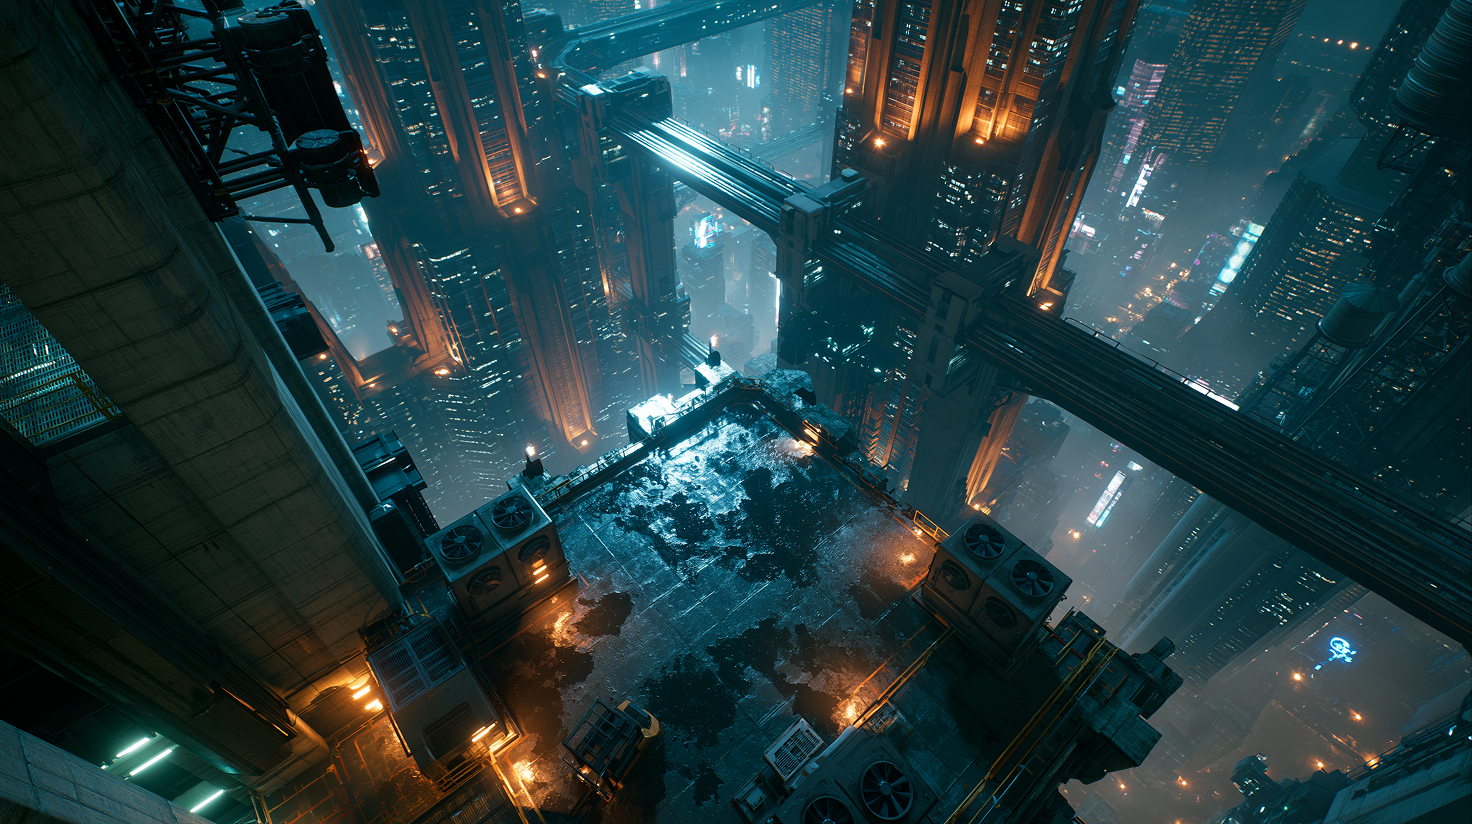
extreme high-altitude top-down wide shot of a futuristic megacity rooftop at midnight, empty rain-soaked skyscraper roof with ventilation units, puddles and safety lights, clear route from rooftop entrance to the broken outer edge, elevated maglev tracks crossing the gap between skyscrapers, deep neon city and atmospheric fog below, cyan and amber lighting, realistic architecture and scale, wet physically based materials, ray-traced reflections, photorealistic 3D CGI, cinematic sci-fi environment, Unreal Engine quality, no characters or vehicles --no people human silhouette drone aircraft train car text logo watermark anime cartoon illustration --ar 16:9 --seed 731204 --raw --stylize 40 --hd
随后使用Midjourney去生成场景(记得选择v8.2模型)
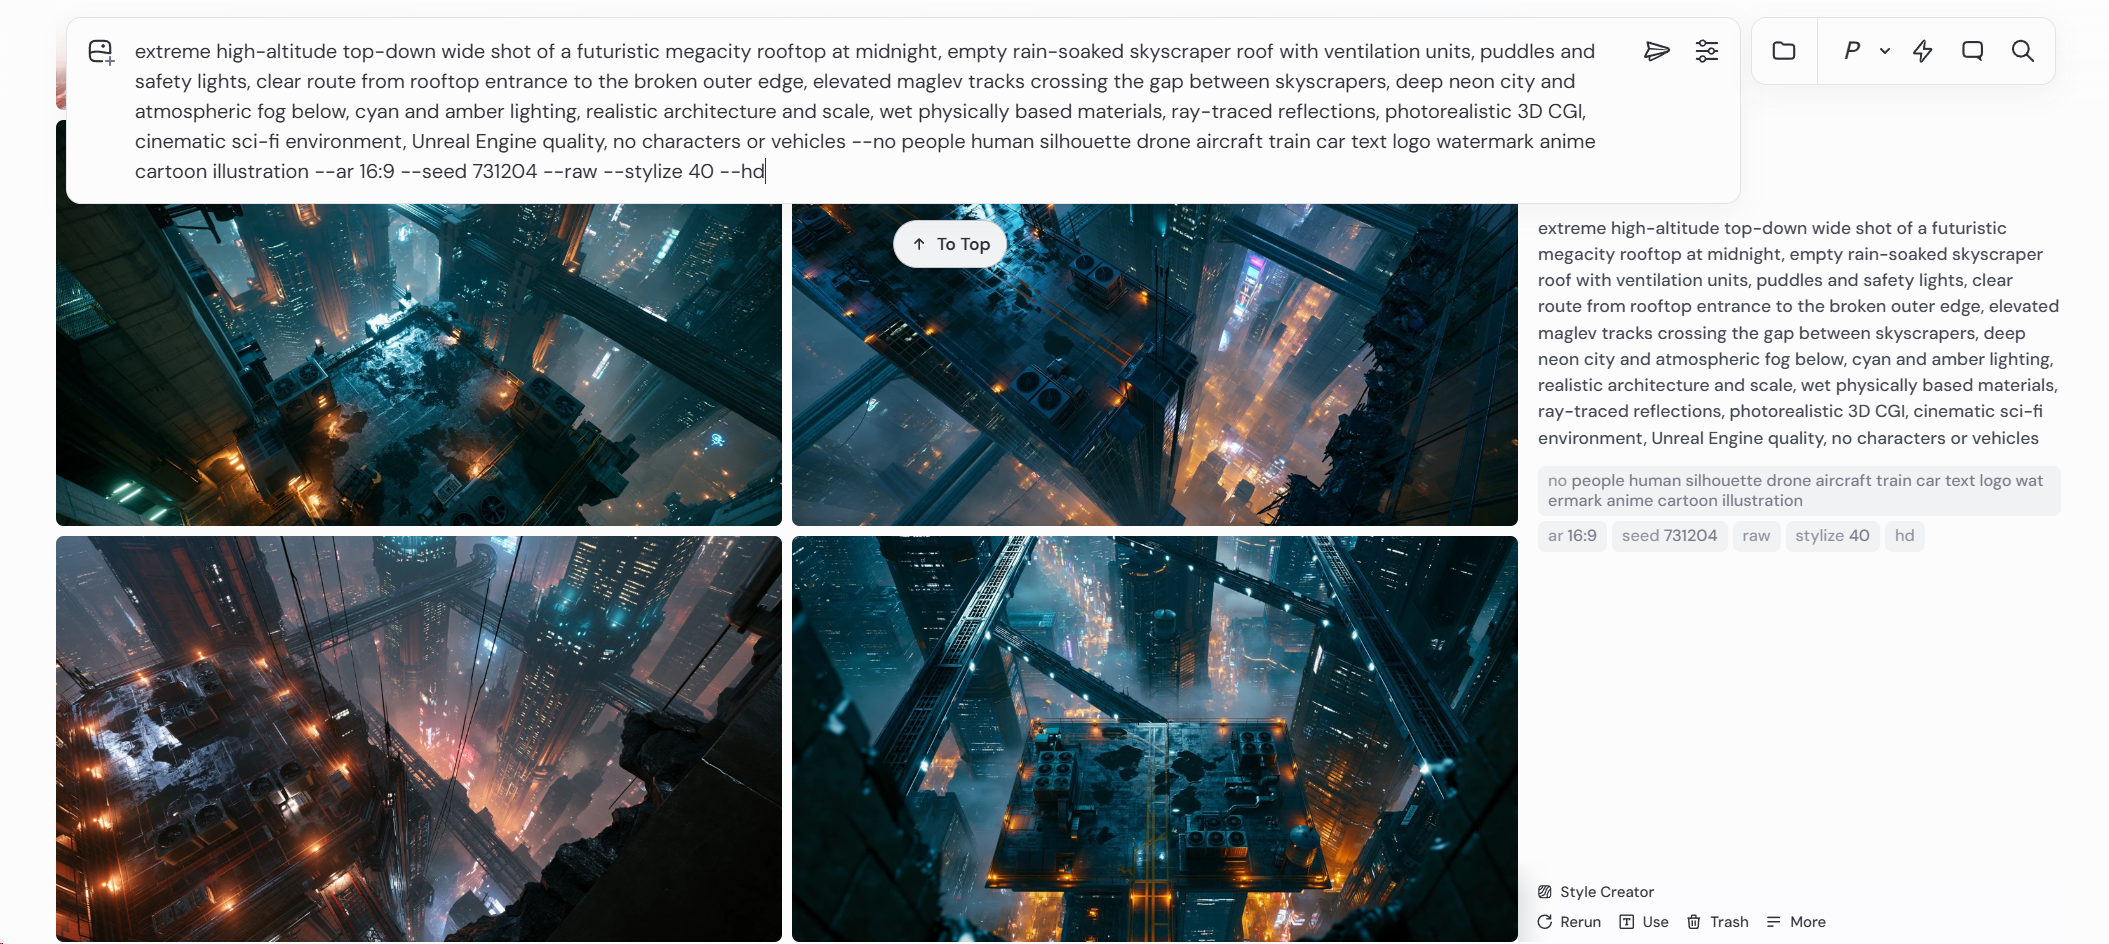
生成界面
2. 生成核心道具
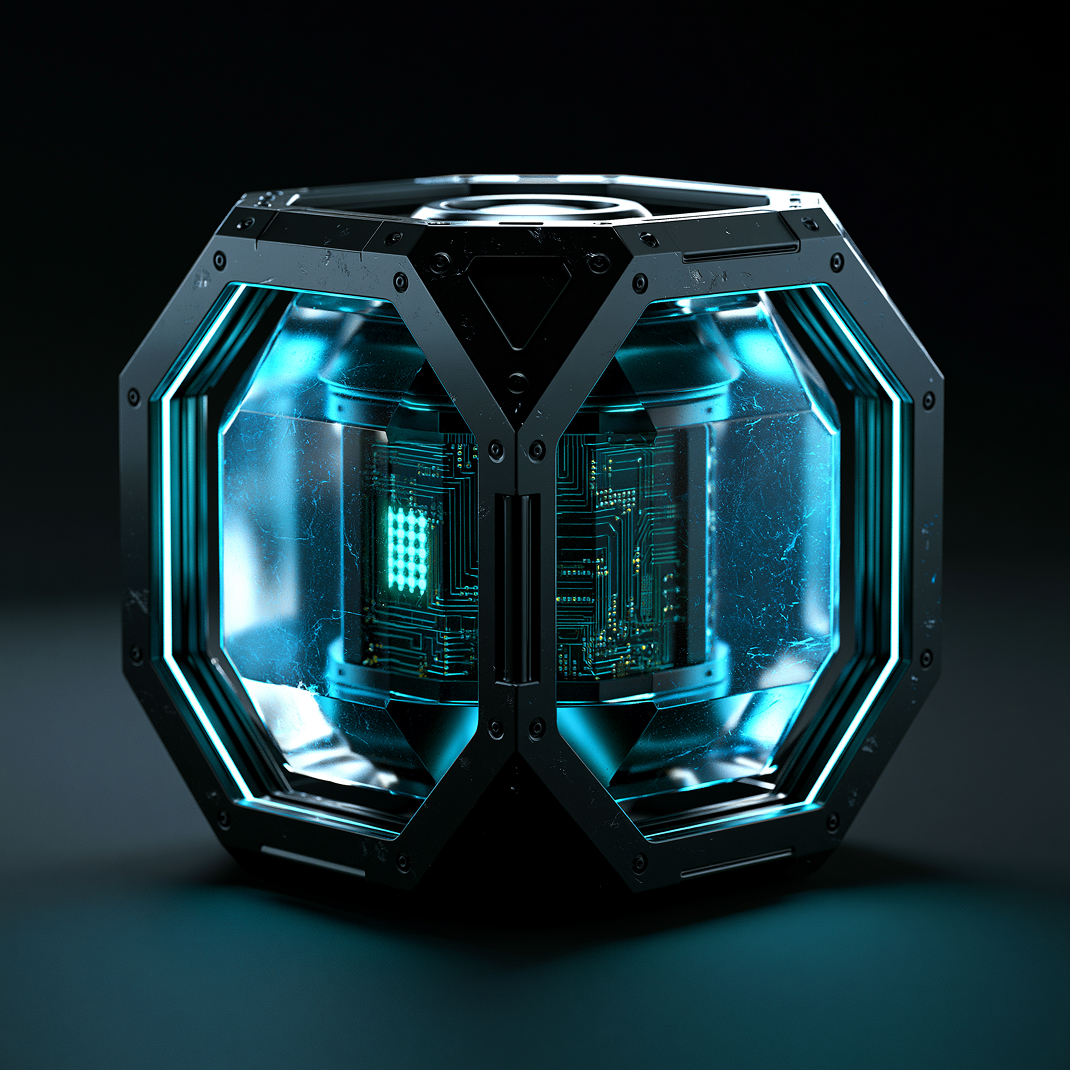
本次只单独生成一个数据核心。道具图采用纯黑背景,让模型集中识别道具轮廓。正面主光负责照亮结构,青蓝色轮廓光负责把黑色金属与背景分开。
紧跟着历史对话输入,提示词如下:
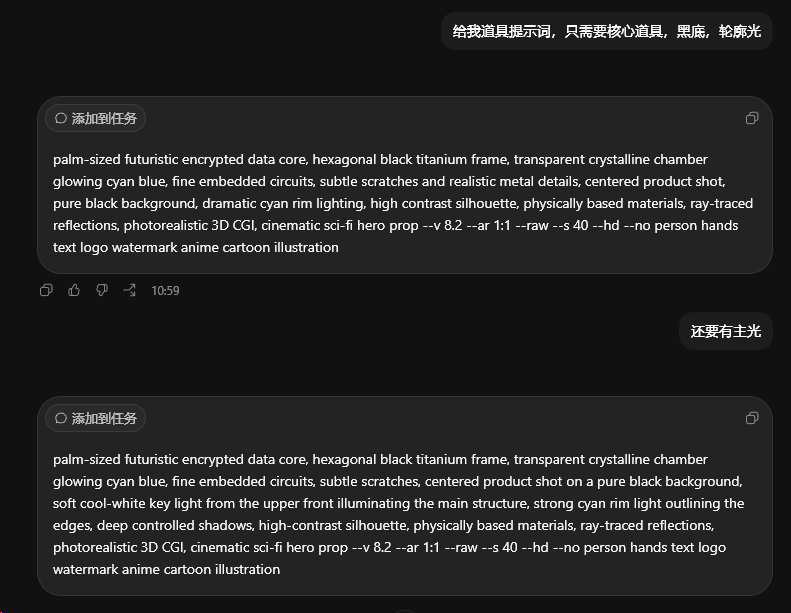
给我道具提示词,只需要核心道具,黑底,轮廓光,还要有主光
得到的提示词如下:
palm-sized futuristic encrypted data core, hexagonal black titanium frame, transparent crystalline chamber glowing cyan blue, fine embedded circuits, subtle scratches, centered product shot on a pure black background, soft cool-white key light from the upper front illuminating the main structure, strong cyan rim light outlining the edges, deep controlled shadows, high-contrast silhouette, physically based materials, ray-traced reflections, photorealistic 3D CGI, cinematic sci-fi hero prop --no person hands text logo watermark anime cartoon illustration --ar 1:1 --raw --stylize 40 --hd
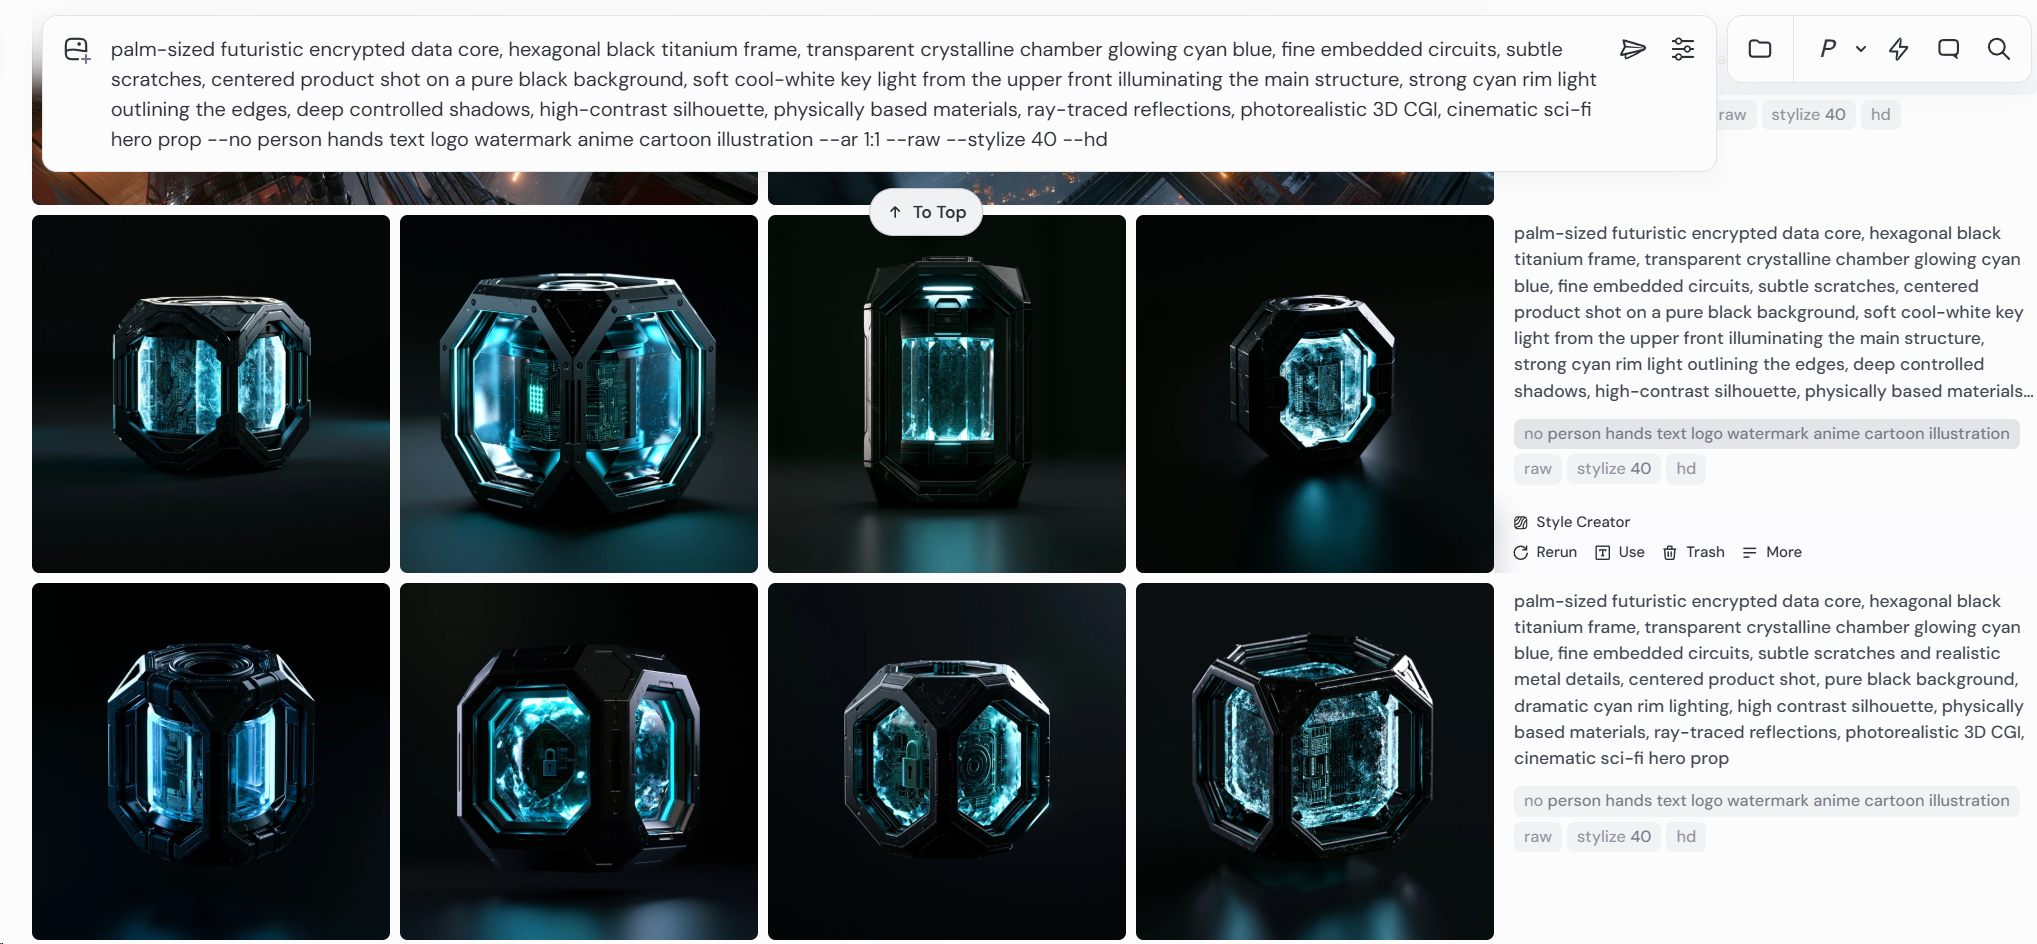
生成界面
第四步:使用Image 2.0生成九宫格分镜
直接接着对话,去生成九宫格提示词:
在我有场景图,人物图,道具图的情况下,给我9宫格分镜提示词,符合故事分镜,中文提示词,符合image2.0的提示词规范
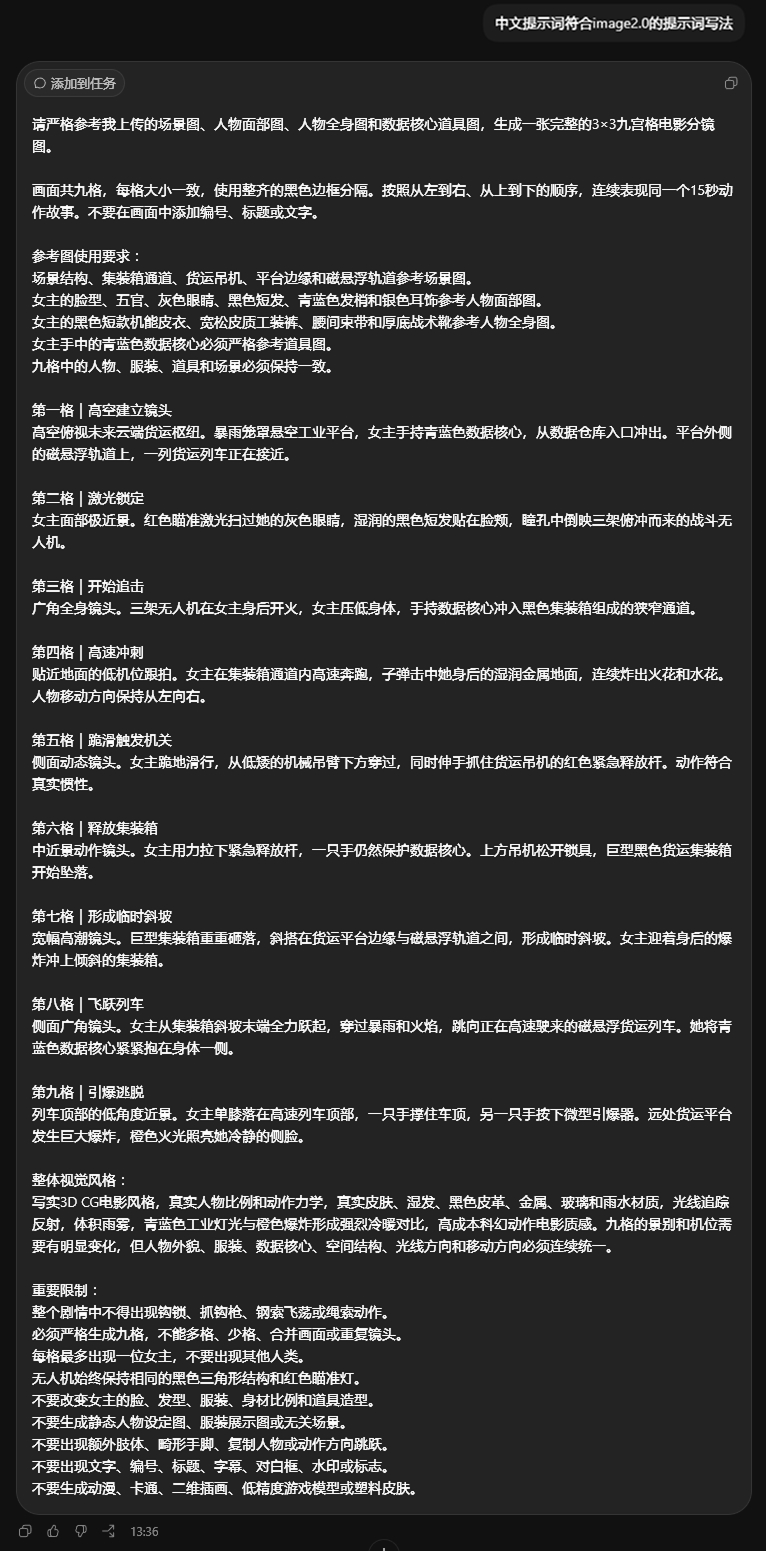
九宫格提示词:
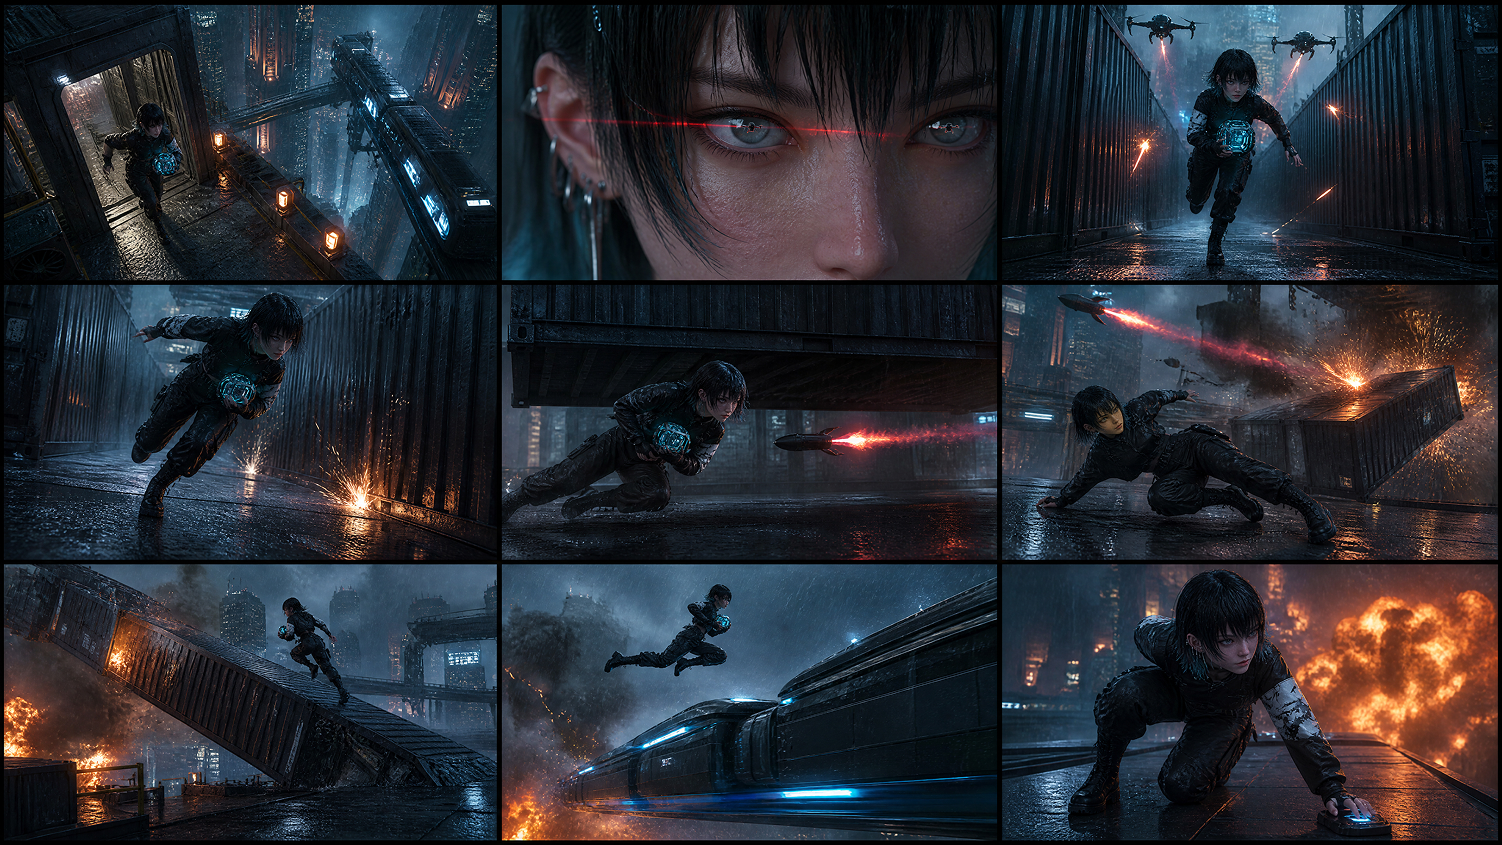
请严格参考我上传的场景图、人物面部图、人物全身图和数据核心道具图,生成一张完整的3×3九宫格电影分镜图。
画面共九格,每格大小一致,使用整齐的黑色边框分隔。按照从左到右、从上到下的顺序,连续表现同一个15秒动作故事。不要在画面中添加编号、标题或文字。
参考图使用要求:
场景结构、集装箱通道、货运吊机、平台边缘和磁悬浮轨道参考场景图。 女主的脸型、五官、灰色眼睛、黑色短发、青蓝色发梢和银色耳饰参考人物面部图。 女主的黑色短款机能皮衣、宽松皮质工装裤、腰间束带和厚底战术靴参考人物全身图。 女主手中的青蓝色数据核心必须严格参考道具图。 九格中的人物、服装、道具和场景必须保持一致。
第一格|高空建立镜头
高空俯视未来云端货运枢纽。暴雨笼罩悬空工业平台,女主手持青蓝色数据核心,从数据仓库入口冲出。平台外侧的磁悬浮轨道上,一列货运列车正在接近。
第二格|激光锁定
女主面部极近景。红色瞄准激光扫过她的灰色眼睛,湿润的黑色短发贴在脸颊,瞳孔中倒映三架俯冲而来的战斗无人机。
第三格|开始追击
广角全身镜头。三架无人机在女主身后开火,女主压低身体,手持数据核心冲入黑色集装箱组成的狭窄通道。
第四格|高速冲刺
贴近地面的低机位跟拍。女主在集装箱通道内高速奔跑,子弹击中她身后的湿润金属地面,连续炸出火花和水花。人物移动方向保持从左向右。
第五格|跪滑触发机关
侧面动态镜头。女主跪地滑行,从低矮的机械吊臂下方穿过,同时伸手抓住货运吊机的红色紧急释放杆。动作符合真实惯性。
第六格|释放集装箱
中近景动作镜头。女主用力拉下紧急释放杆,一只手仍然保护数据核心。上方吊机松开锁具,巨型黑色货运集装箱开始坠落。
第七格|形成临时斜坡
宽幅高潮镜头。巨型集装箱重重砸落,斜搭在货运平台边缘与磁悬浮轨道之间,形成临时斜坡。女主迎着身后的爆炸冲上倾斜的集装箱。
第八格|飞跃列车
侧面广角镜头。女主从集装箱斜坡末端全力跃起,穿过暴雨和火焰,跳向正在高速驶来的磁悬浮货运列车。她将青蓝色数据核心紧紧抱在身体一侧。
第九格|引爆逃脱
列车顶部的低角度近景。女主单膝落在高速列车顶部,一只手撑住车顶,另一只手按下微型引爆器。远处货运平台发生巨大爆炸,橙色火光照亮她冷静的侧脸。
整体视觉风格:
写实3D CG电影风格,真实人物比例和动作力学,真实皮肤、湿发、黑色皮革、金属、玻璃和雨水材质,光线追踪反射,体积雨雾,青蓝色工业灯光与橙色爆炸形成强烈冷暖对比,高成本科幻动作电影质感。九格的景别和机位需要有明显变化,但人物外貌、服装、数据核心、空间结构、光线方向和移动方向必须连续统一。
重要限制: 整个剧情中不得出现钩锁、抓钩枪、钢索飞荡或绳索动作。 必须严格生成九格,不能多格、少格、合并画面或重复镜头。 每格最多出现一位女主,不要出现其他人类。 无人机始终保持相同的黑色三角形结构和红色瞄准灯。 不要改变女主的脸、发型、服装、身材比例和道具造型。 不要生成静态人物设定图、服装展示图或无关场景。 不要出现额外肢体、畸形手脚、复制人物或动作方向跳跃。 不要出现文字、编号、标题、字幕、对白框、水印或标志。 不要生成动漫、卡通、二维插画、低精度游戏模型或塑料皮肤。
准备好人物、场景和道具后,将以下图片一起上传给Image 2.0:
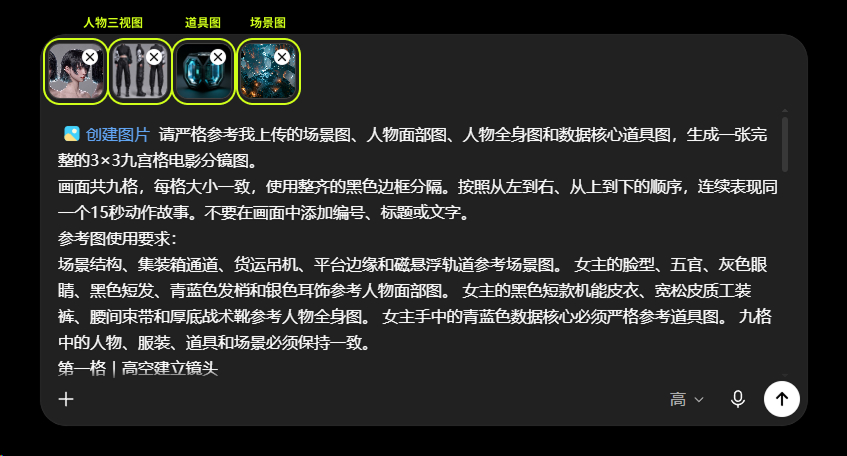
image2.0界面
第五步:将九宫格转换为深度图
九宫格确认后,继续使用Image 2.0将它转换成深度图。
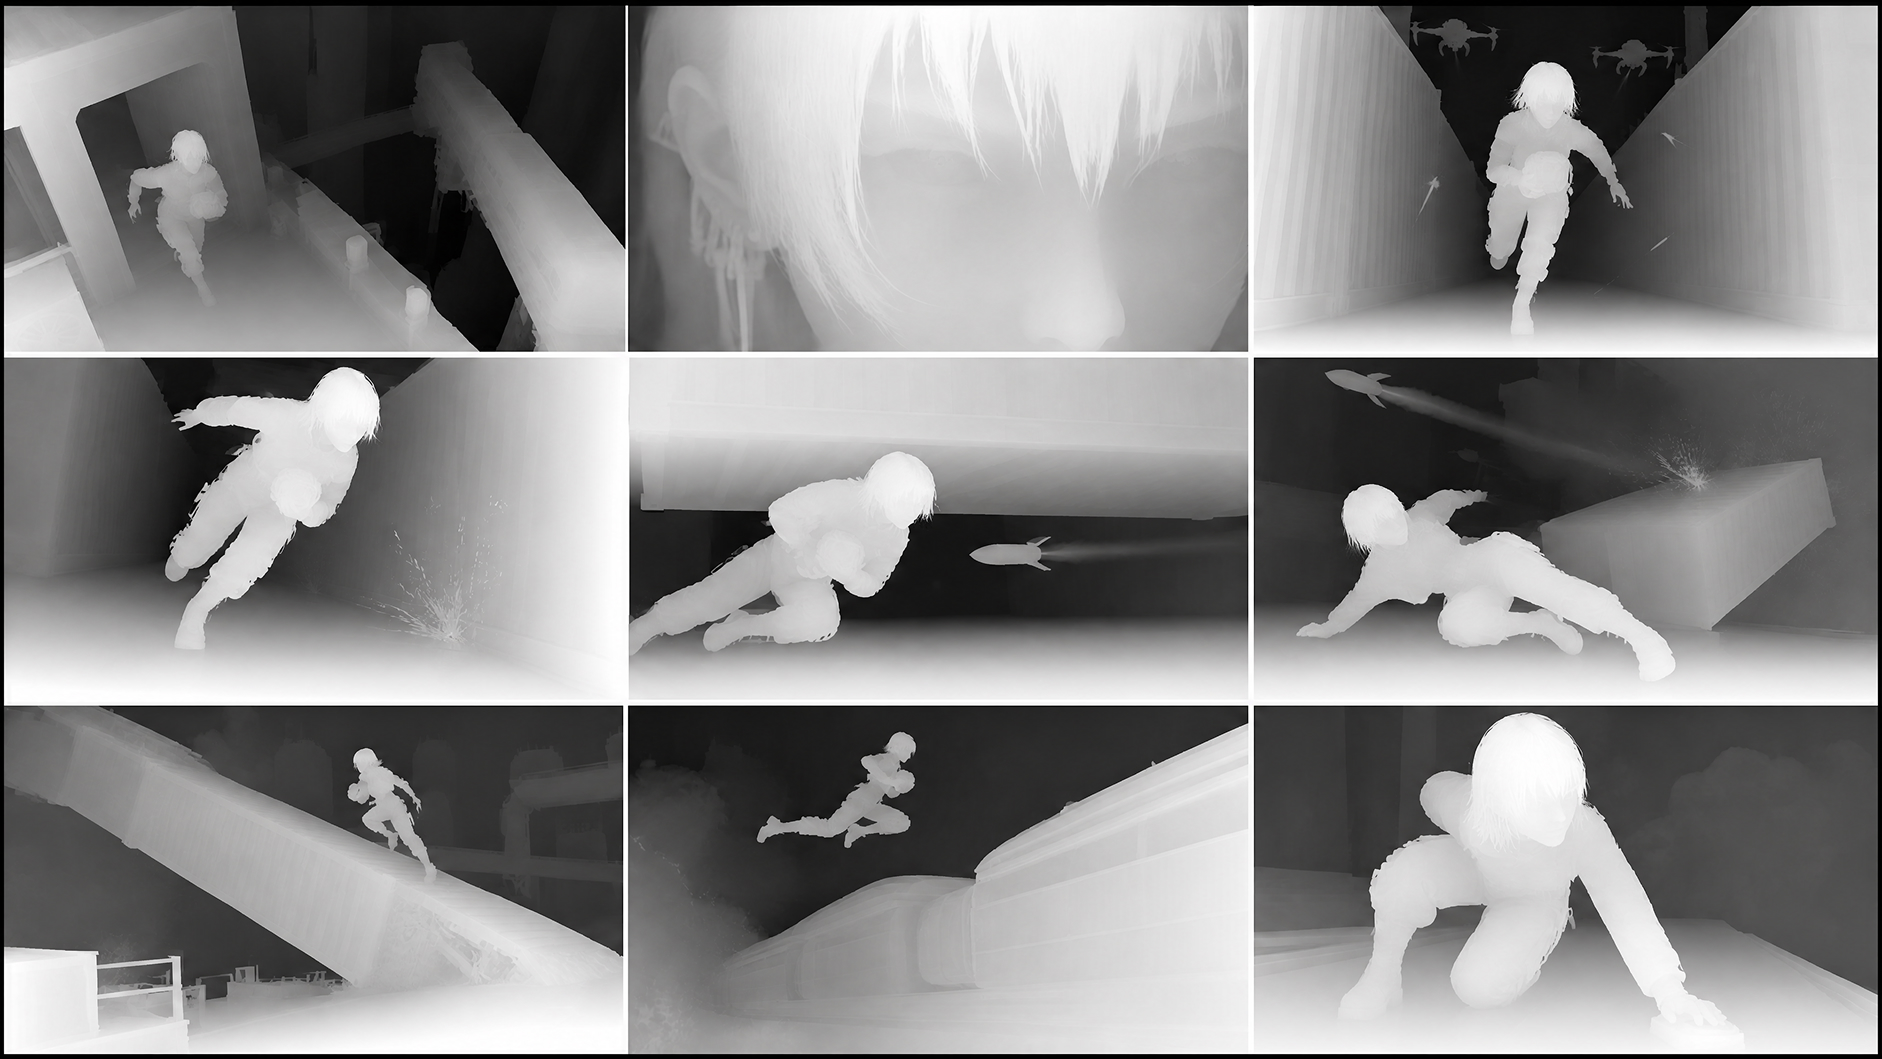
深度图不是普通黑白图片。它主要记录画面中物体与摄影机之间的相对距离,可以弱化原图中的颜色、材质、错误五官和纹理噪点。
使用下面的提示词:
把输入图片转换为单目相对深度图,用作后续图像生成的空间结构控制。必须保持:原图画幅比例、构图、镜头视角、主体位置与尺度、人物姿势、物体轮廓、前后遮挡关系和背景空间结构。深度规则:近处显示为白色,远处显示为黑色,中间距离使用连续灰阶;同一连续表面保持平滑的深度过渡,物体边界清晰。禁止:重新设计构图,移动、增加或删除人物与物体,改变姿势,补画新细节,保留原图颜色、纹理、文字、材质和光影风格。输出:只输出一张与原图尺寸一致的纯灰度深度图,不添加边框、说明文字、色彩图例或装饰。
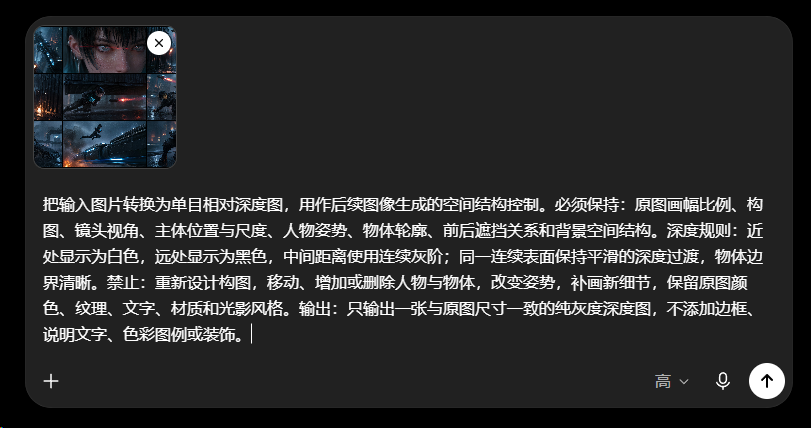
image2.0生成界面
生成的深度图
第六步:使用Seedance 2.0生成视频
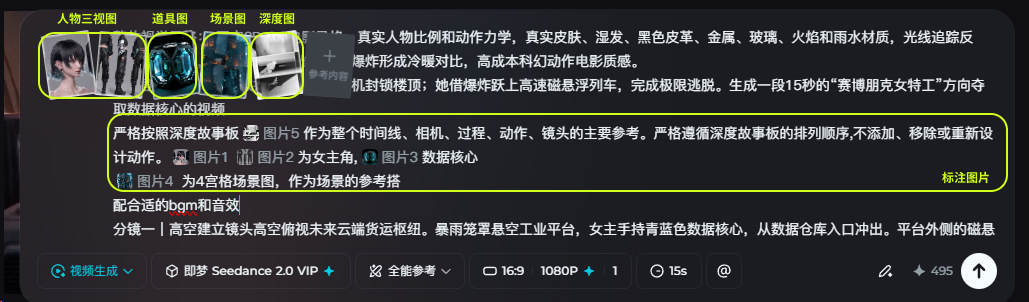
最后,将以下素材一起上传给Seedance 2.0:
1.人物面部三视图;
2.人物全身三视图;
3.数据核心道具图。
4.场景图;
5.深度九宫格故事板;
每张图只承担自己的职责,不要让一张图同时负责所有内容。
上传后输入提示词,还有注意图片的标注:
严格按照深度故事板图5作为整个时间线、相机、过程、动作、镜头的主要参考。严格遵循深度故事板的排列顺序,不添加、移除或重新设计动作。图1、图2为女主角,图3数据核心。图4为4宫格场景图,作为场景的参考搭,配合适的bgm和音效
提示词中还可以添加上生成九宫格的提示词分镜(不加也可以,加了更稳定):
分镜一|高空建立镜头 高空俯视未来云端货运枢纽。暴雨笼罩悬空工业平台,女主手持青蓝色数据核心,从数据仓库入口冲出。平台外侧的磁悬浮轨道上,一列货运列车正在接近。
分镜二|激光锁定
女主面部极近景。红色瞄准激光扫过她的灰色眼睛,湿润的黑色短发贴在脸颊,瞳孔中倒映三架俯冲而来的黑色战斗无人机。
分镜三|开始追击
广角全身镜头。三架无人机在女主身后开火,女主压低身体,单手握紧数据核心,冲入黑色集装箱组成的狭窄货运通道。
分镜四|高速冲刺
贴近地面的低机位跟拍。女主在集装箱通道内高速奔跑,子弹击中她身后的湿润金属地面,连续炸出火花和水花。人物移动方向保持从左向右。
分镜五|诱导导弹
侧面动态镜头。女主抱紧青蓝色数据核心,跪地滑过悬吊集装箱下方。一架无人机向她发射红色追踪导弹,导弹紧贴她身后的移动路线飞来。
分镜六|极限闪避
低机位动作镜头。女主在最后一刻侧身翻滚闪开。追踪导弹从她上方掠过,击中货运吊机的集装箱锁扣。锁扣爆裂,火花和金属碎片飞散,悬吊集装箱开始倾斜坠落。
分镜七|坠落成坡
宽幅高潮镜头。巨型黑色集装箱重重砸在货运平台边缘,另一端斜搭向磁悬浮轨道,形成临时跳跃斜坡。女主从爆炸烟尘中起身,沿倾斜的集装箱全速向上冲刺。
分镜八|飞跃列车
侧面广角镜头。女主从集装箱斜坡末端全力跃起,穿过暴雨、火花和爆炸烟雾,跳向正在高速驶来的磁悬浮货运列车。她将青蓝色数据核心紧紧抱在身体一侧。
分镜九|引爆逃脱
列车顶部低角度近景。女主单膝落在高速列车顶部,一只手撑住车顶,另一只手按下微型引爆器。远处货运平台发生巨大爆炸,橙色火光照亮她冷静的侧脸。
深度图在这套流程中的作用
普通九宫格同时包含人物、场景、颜色、材质和画面噪点(image2.0生成图片时的噪点),这些信息可能相互干扰。转换成深度图后,可以弱化九宫格中不准确的人物外貌、场景细节以及GPT生成图片里的噪点,只保留镜头构图、动作姿态、前后距离和分镜顺序。
这样一来,每张参考图都能拥有明确分工:深度图负责分镜和动作,人物图负责角色身份,场景图负责环境,道具图负责核心物件,文字提示词负责解释剧情与限制。
由于深度图没有锁定具体的颜色、纹理和外观,同一张九宫格还可以重复使用。你可以保留原来的动作与镜头,替换人物、场景、服装或道具,快速制作不同版本。
比如这一段视频,我换了场景,人物,依旧只用深度图
它既为视频建立了稳定的镜头骨架,又没有把所有细节完全固定,仍然给AI保留了一定的理解和发挥空间。
最后我将俩段视频拼接在一起,加了一些滤镜效果
视频生成执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课不是先追求炫技成片,而是围绕「刺猬星球super-i_AI教程免费在线教学」先把主体、动作、镜头和节奏稳住。
按原文节奏走最稳:先吃透「准备工具」,再把「这套方法能解决什么问题?」定住,接着处理「第一步:准备人物参考图」;最后用「第二步:使用GPT设计15秒剧情」收口。
- 先把「准备工具」里的主体和动作定死。
- 先把「这套方法能解决什么问题?」提到的误区排掉,别踩同一坑。
- 围绕「第一步:准备人物参考图」只取局部结构,别整张照搬。
- 先把「第二步:使用GPT设计15秒剧情」里的主体和动作定死。
- 这一段重点看镜头和节奏,别急着炫技。
- 做完「第四步:使用Image 2.0生成九宫格分镜」后,先查连贯性和穿帮。
不要一上来就生成最终片;先拆镜头、定主体和运动,再逐段生成,否则容易跳轴、穿帮、节奏混乱。
检查主体是否稳定;镜头运动是否明确;前后画面是否连贯;节奏是否服务主题;是否有明显变形或穿帮。
请围绕「刺猬星球super-i_AI教程免费在线教学」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:核心创意、分镜表、每个镜头的画面描述、视频生成提示词、剪辑顺序和成片自检清单。要求主体稳定、动作明确、镜头连贯。