一起来看一下成品:
准备工具
ChatGPT https://chatgpt.com/c/
nanobanan pro https://labs.google/fx/tools/flow/
seedance2.5 https://jimeng.jianying.com/ai-tool/home/
libtv https://www.liblib.tv/
倘若不知道模型怎么使用,可以参考这个教程(https://www.super-i.cn/info-2796.html),与本教程一起使用
https://www.flowpix.club/bj/39668.html?token=1b813c4600f0f06722e9793fad2b45dc
这次要解决什么问题?
这次我想做的不是普通的单人物视频,而是一段古代宫廷夜宴群像戏。
整个场景里一共有 11个人物:
皇帝、皇后、年轻王爷、武将、2位文臣、2位贵族小姐、2位宫女,以及1位舞姬。
人物不仅多,而且每个人都有自己的固定位置。
皇帝皇后在高台,两侧是宫女;文臣、武将、王爷和贵族小姐分别坐在左右宾席;舞姬位于大厅中央。
这其实已经属于比较极端的多人场景了。
11个人一起控制并不轻松,这次甚至有一点冒进。
因为人物越多,AI越容易出现:
人物位置交换
左右关系改变
座位距离发生变化
某个人突然消失
后续镜头把人物重新排列
角色身份互相串掉
所以这篇教程真正要解决的不是“怎么生成一个夜宴”,而是:
怎么先建立一套明确的空间规则,再让后面的镜头尽量沿用这套规则。
第一步:准备人物与场景资产
第一步还是先把基础资产做好。
这里的人物资产制作方法之前已经讲过很多次,我先让 ChatGPT 根据这次夜宴剧情帮我规划需要哪些角色,再分别生成人物造型提示词。(资产怎么做,可以参照这个教程https://www.super-i.cn/info-2909.html)
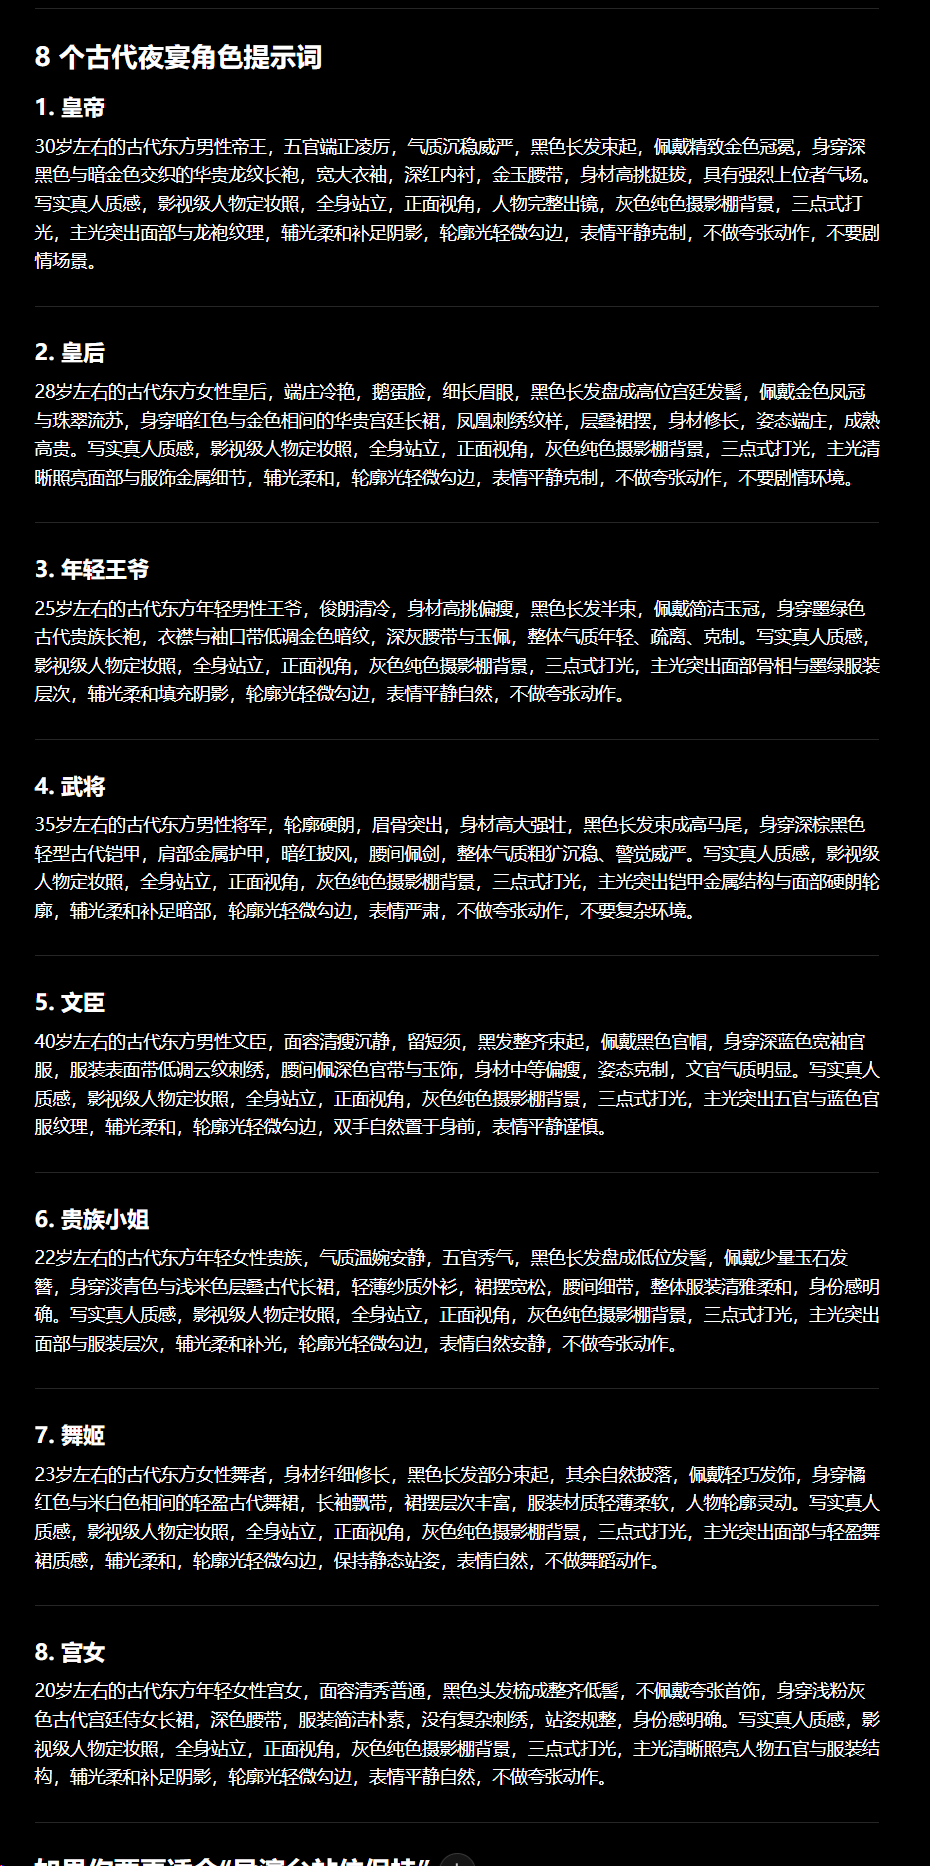
然后使用 Midjourney 生成人物定妆照。
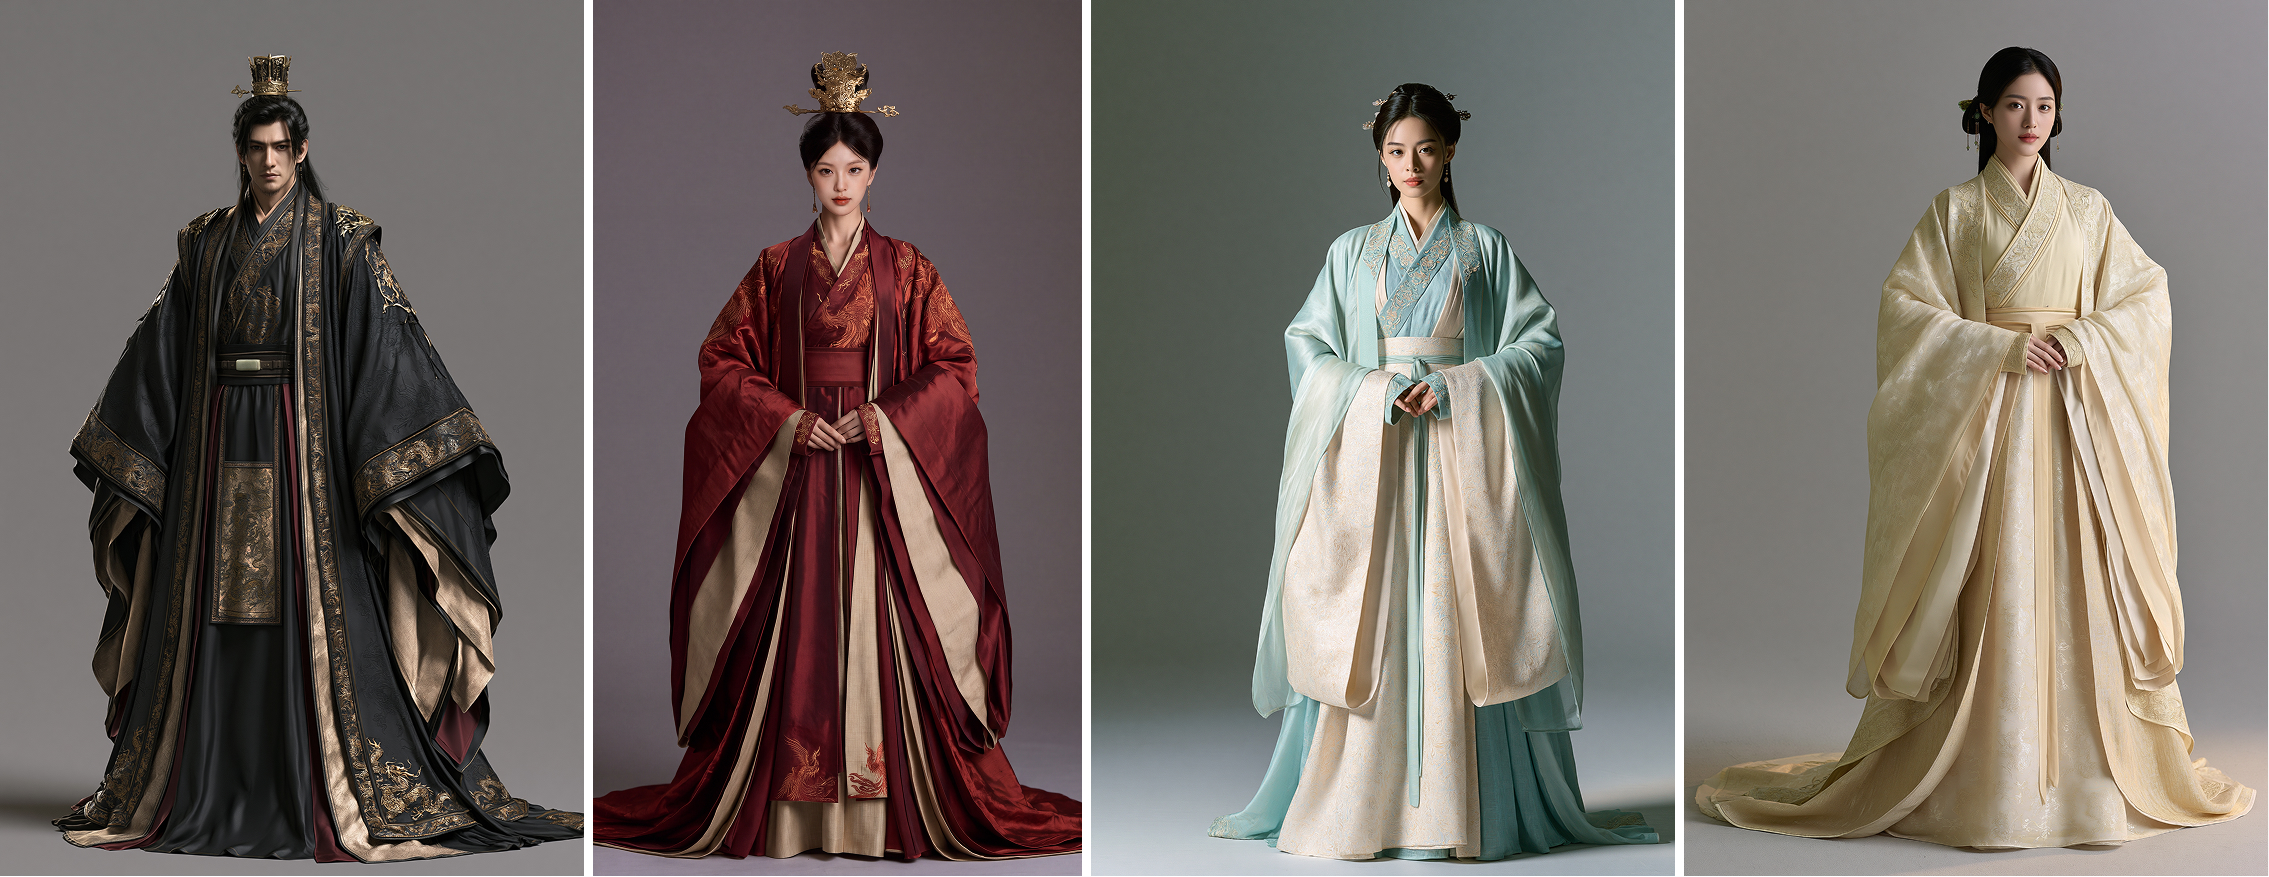
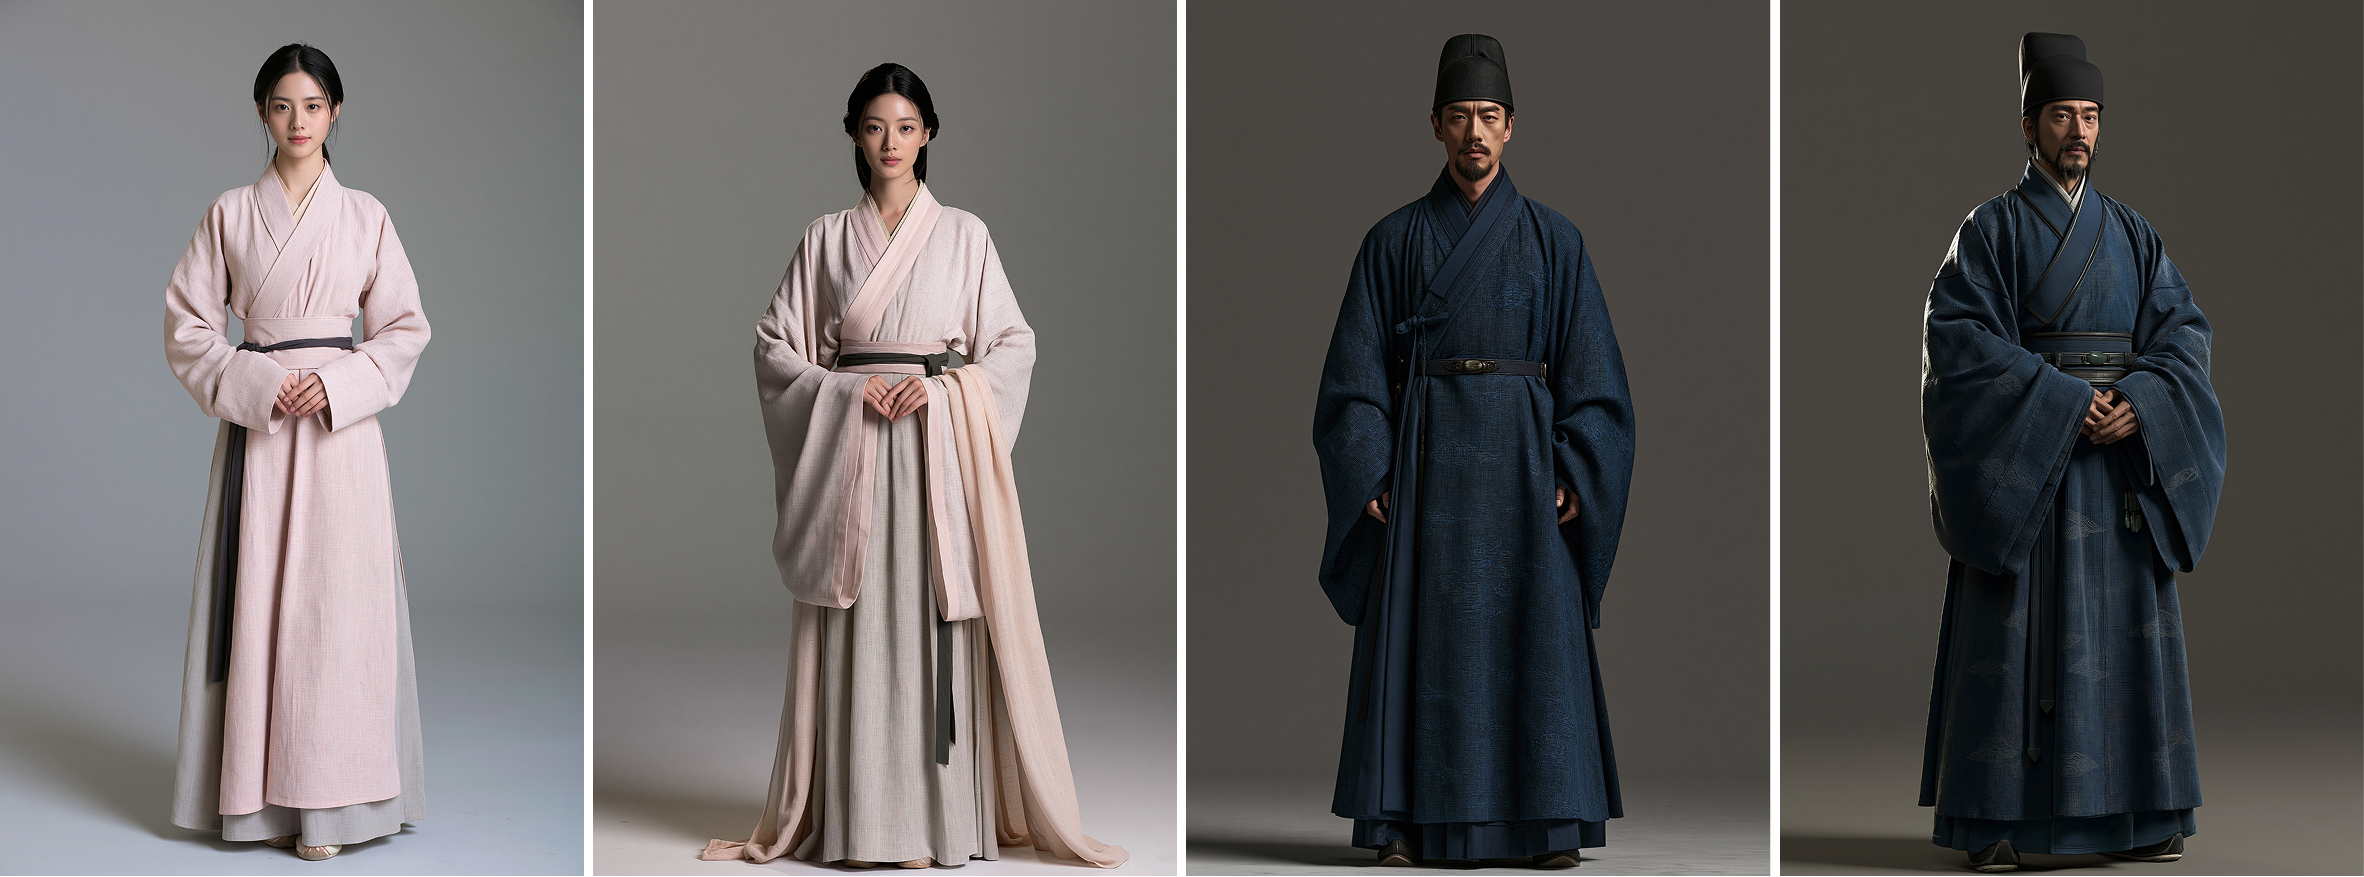
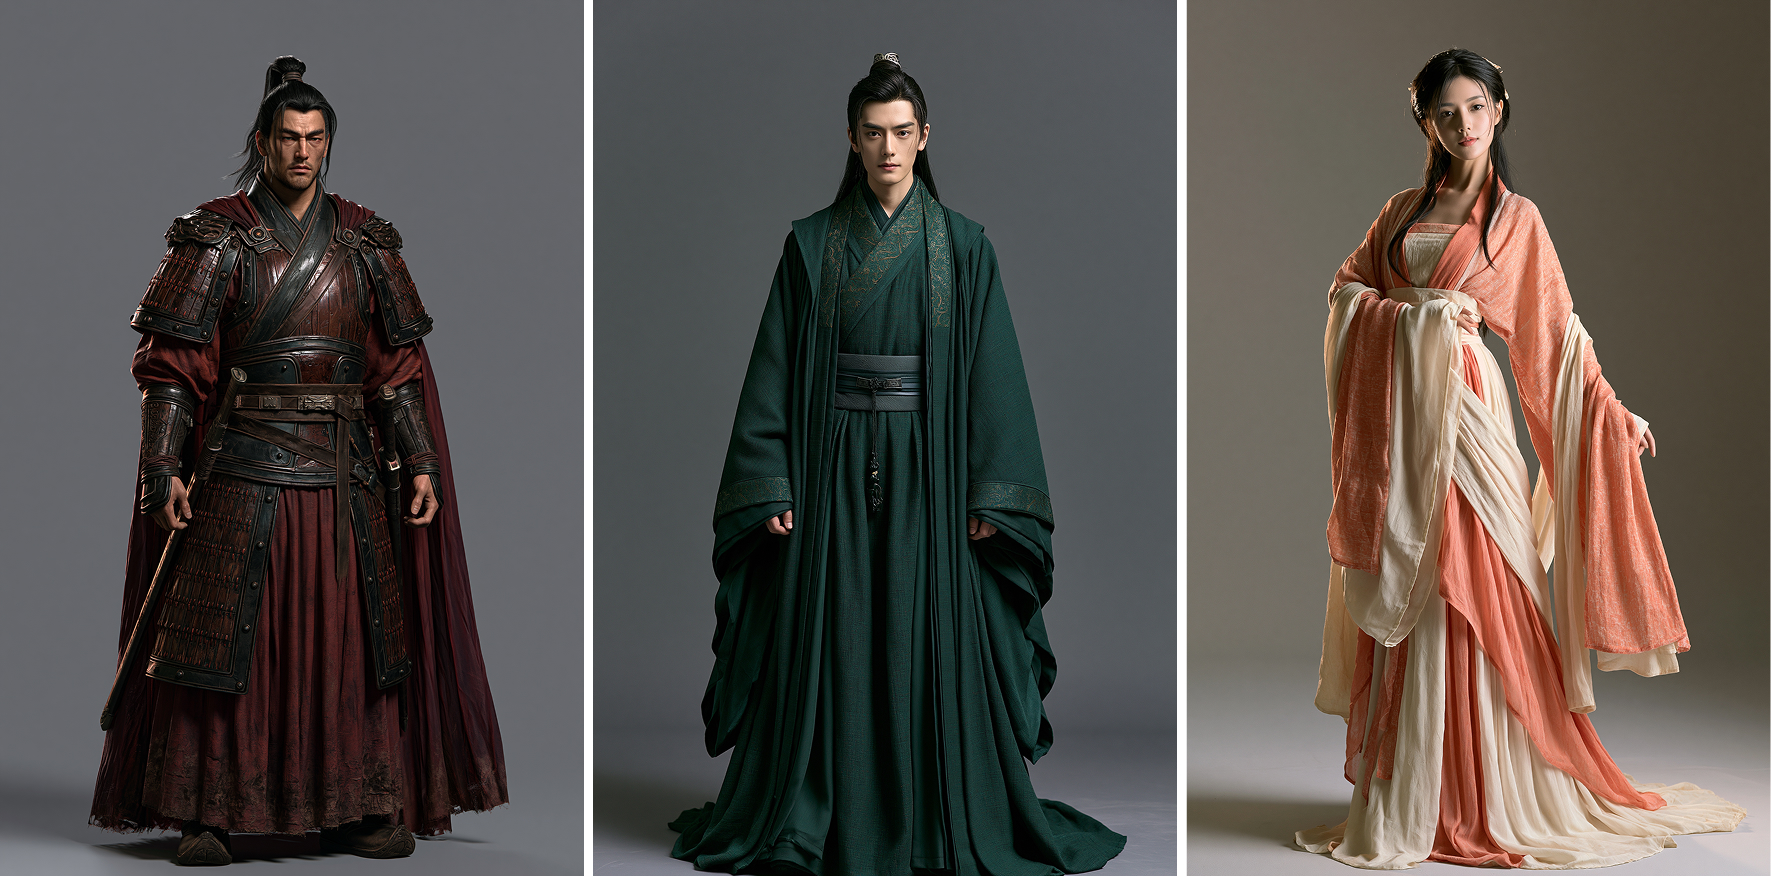
人物确定以后,再使用 Nano Banana Pro 将每个人统一生成人物四视图(这些在上面的教程链接中都有讲到)
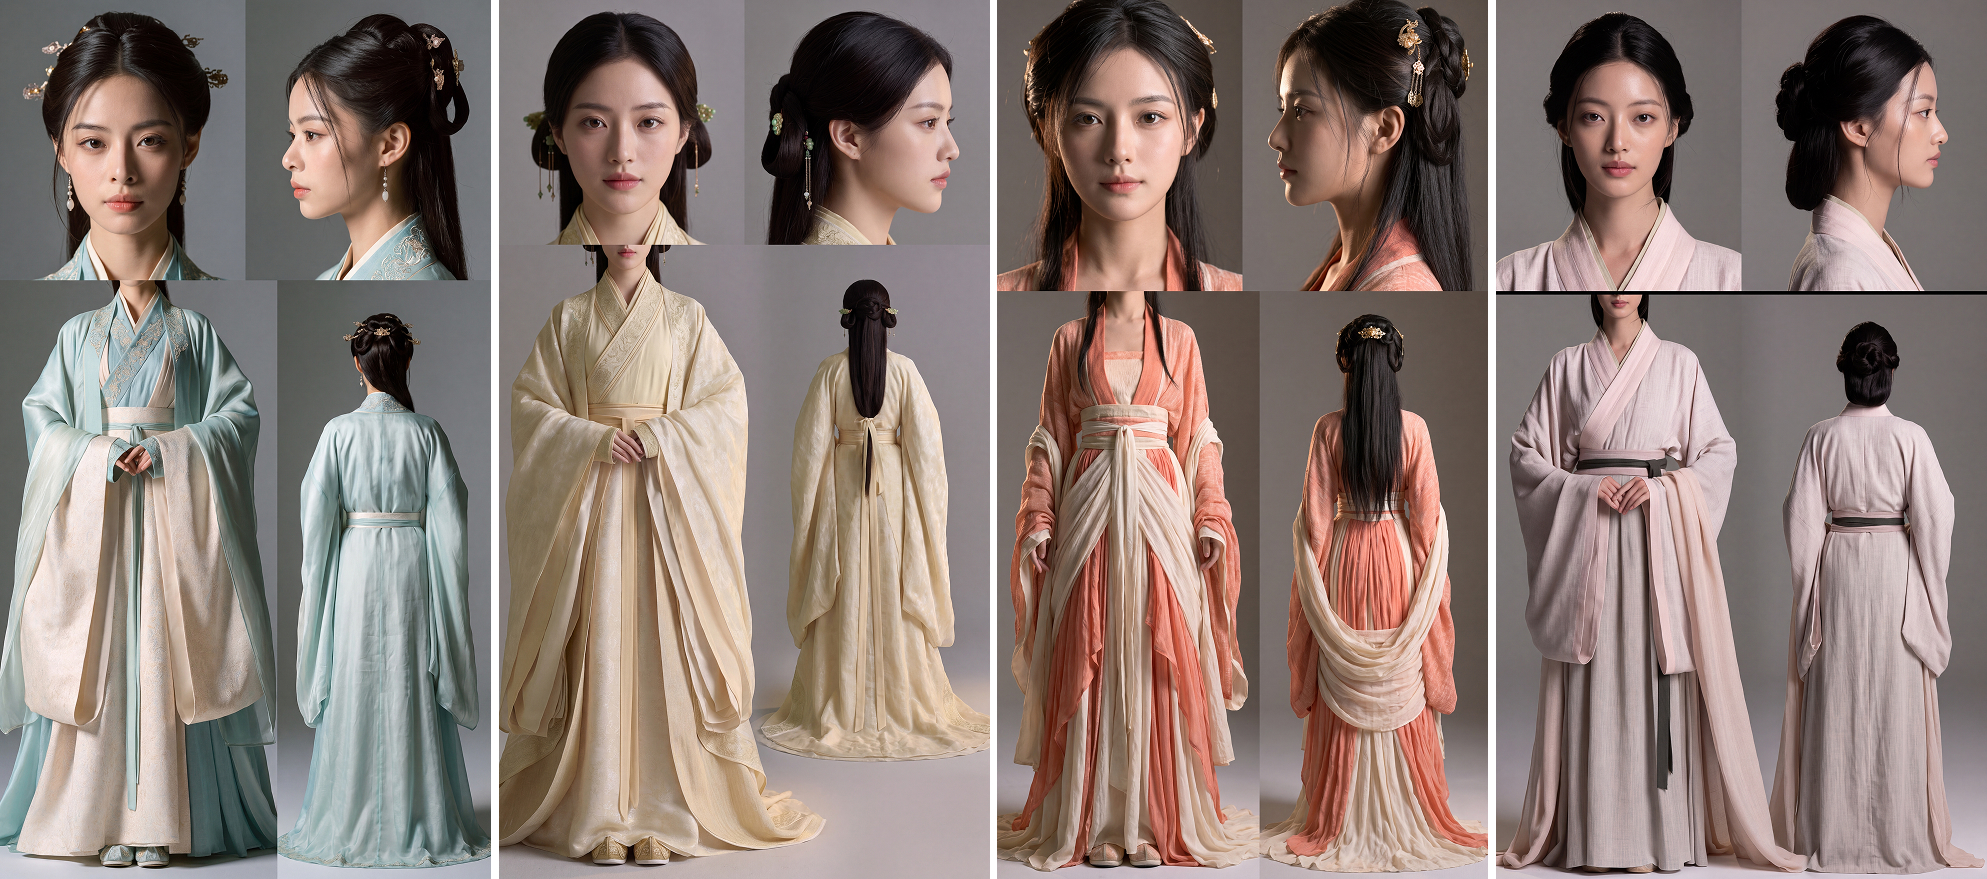
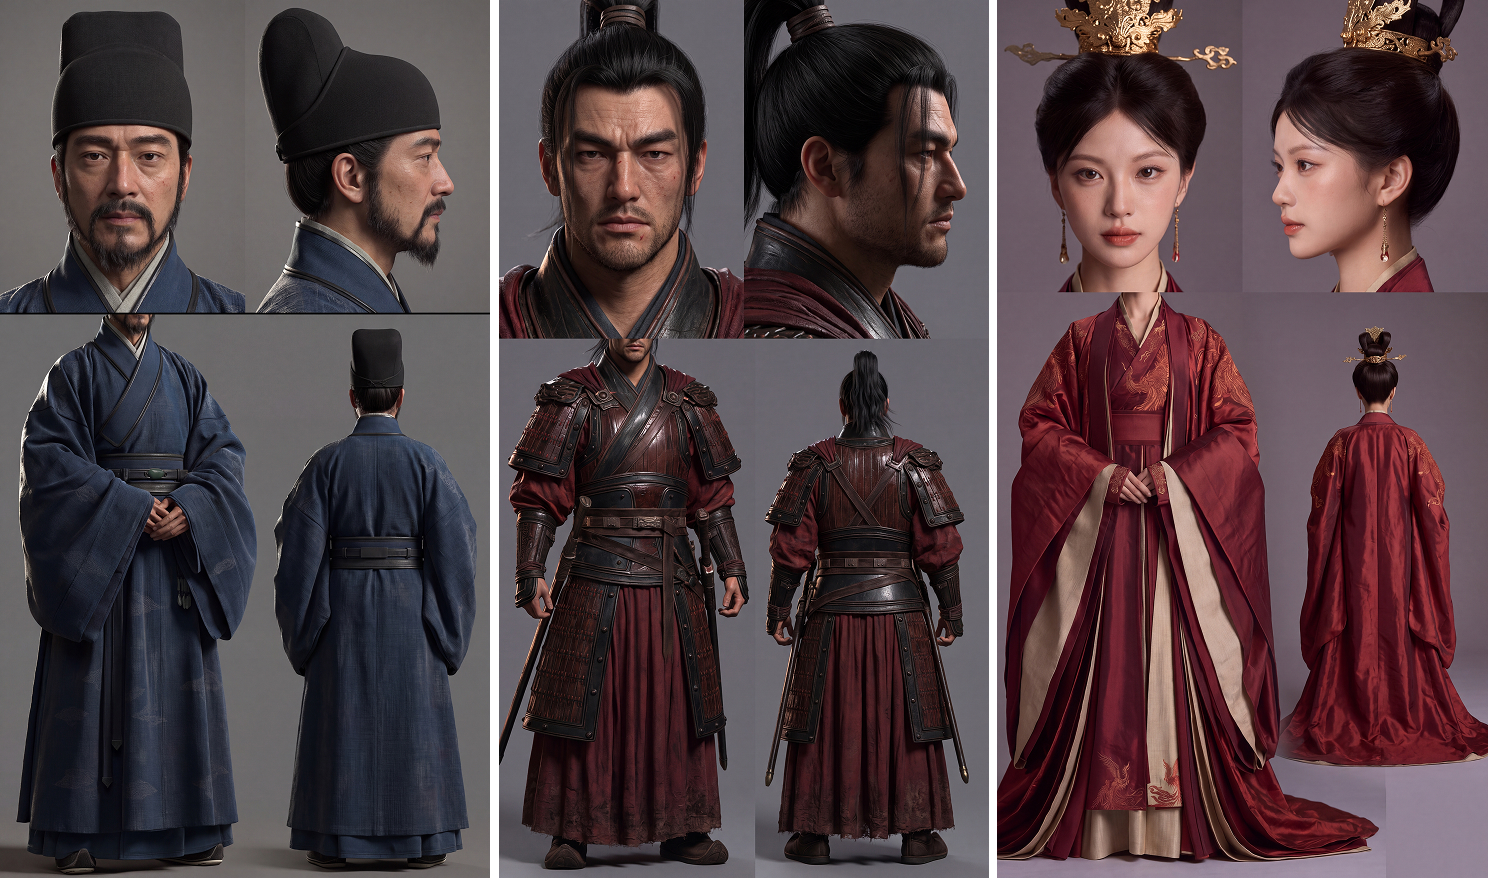
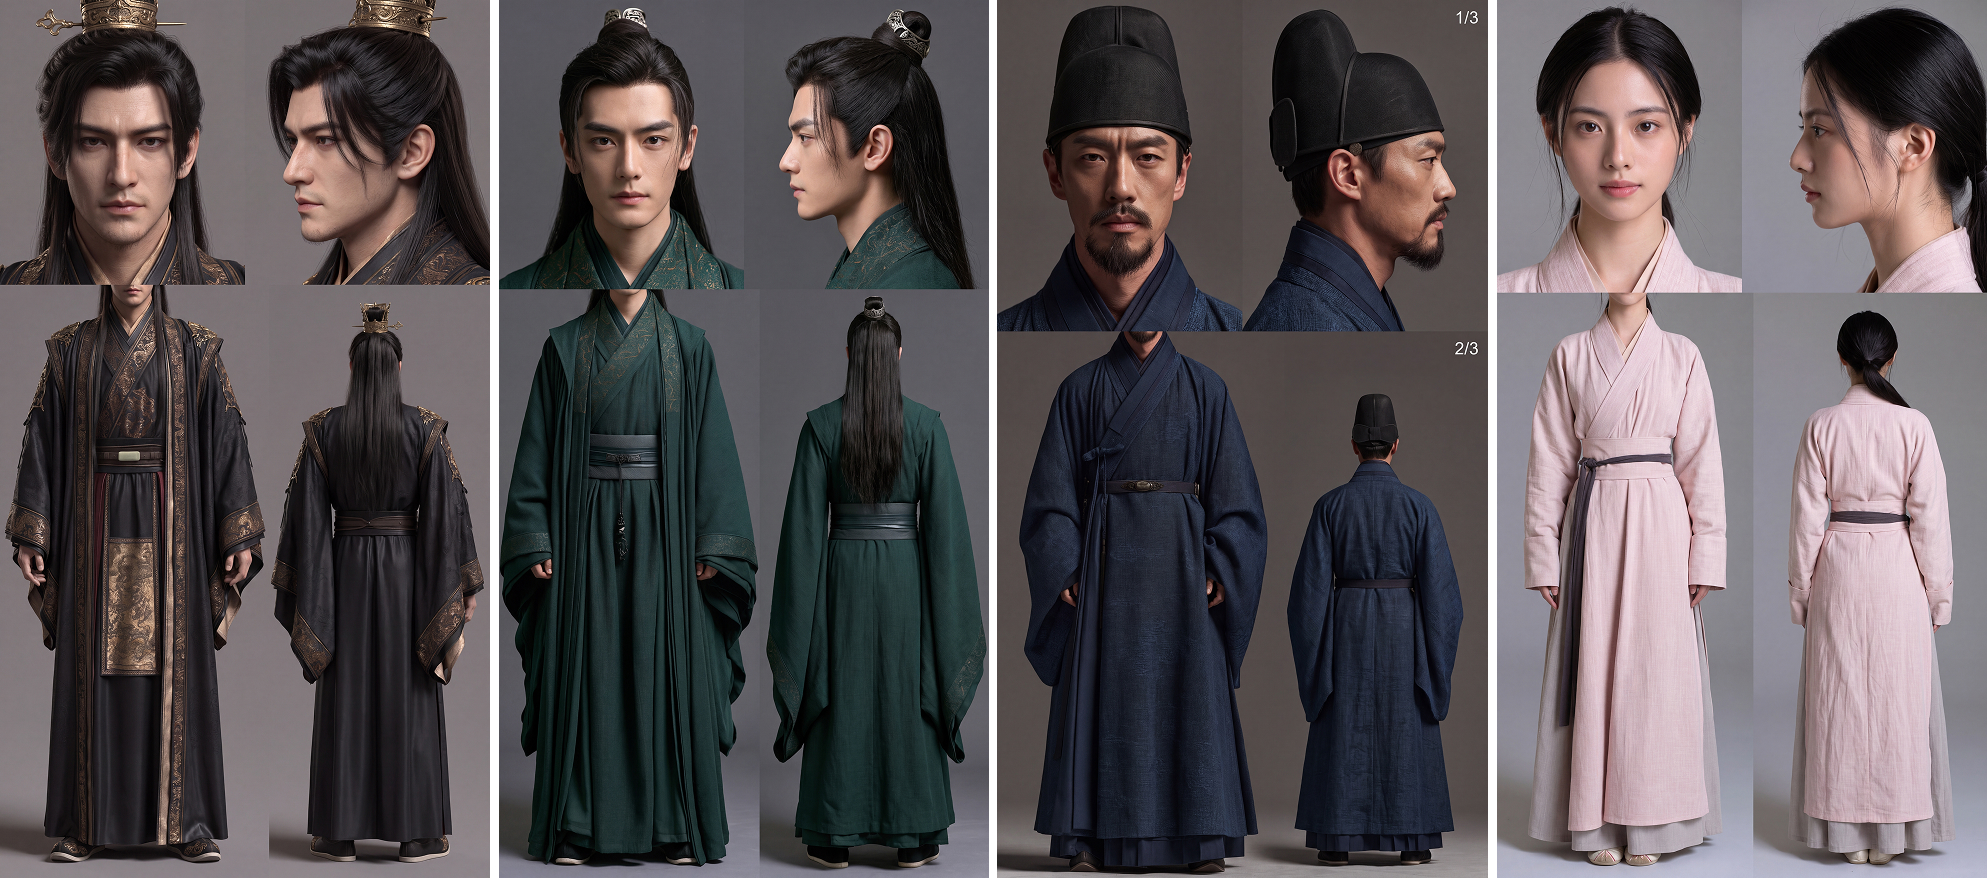
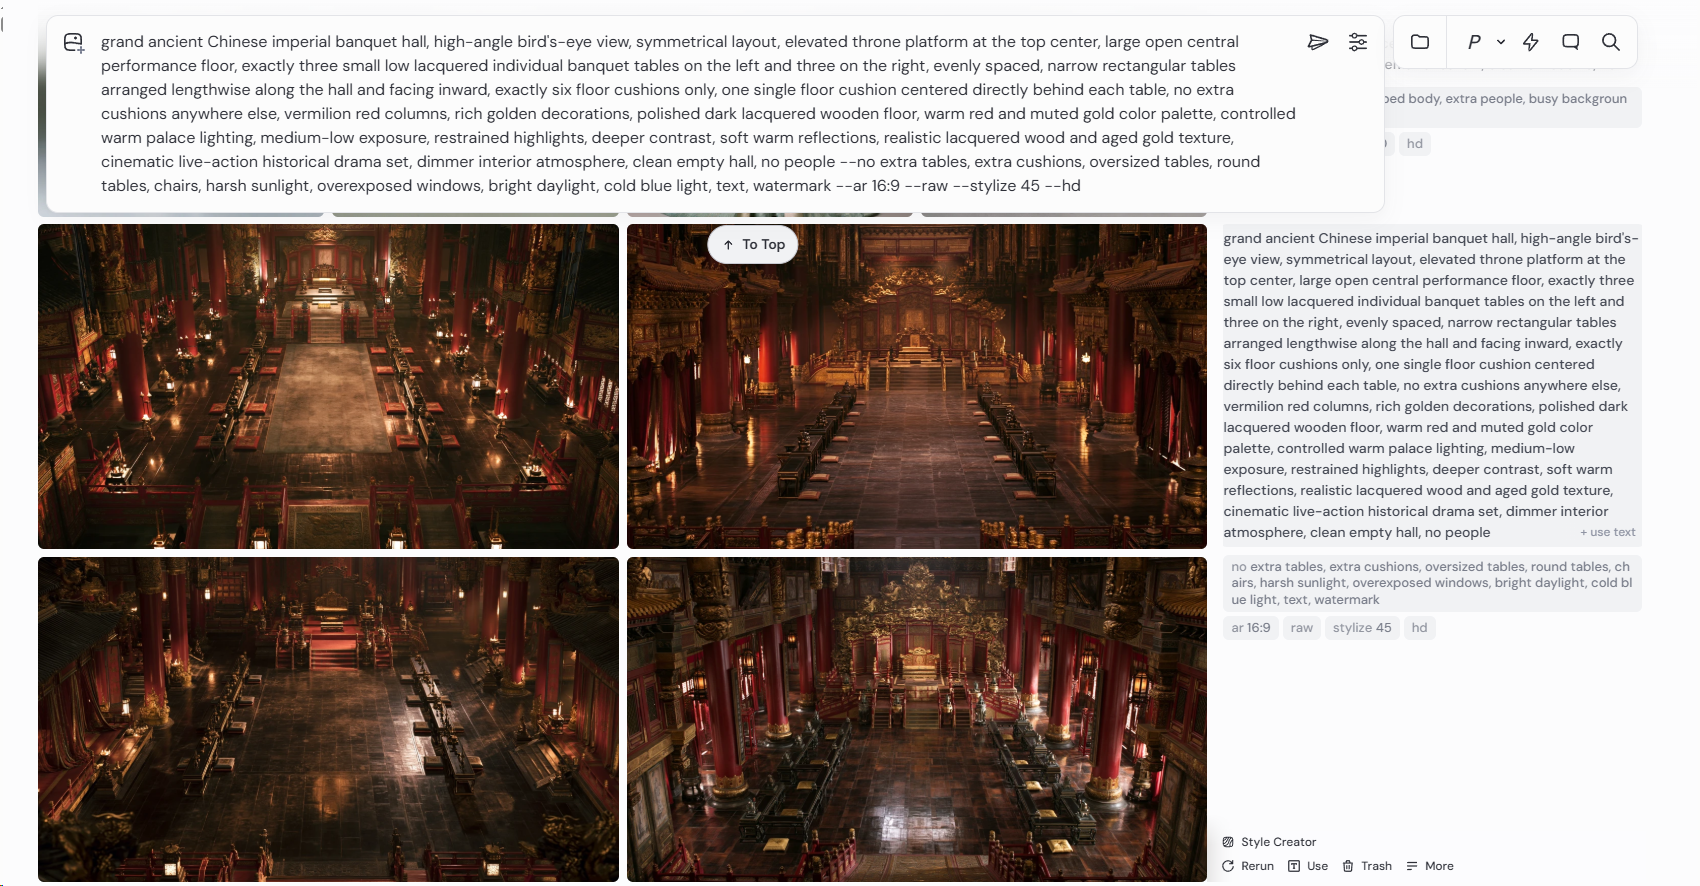
最后再制作这次使用的古代宫廷夜宴场景资产。
也是使用ChatGPT去直接反推
提示词如下:
grand ancient Chinese imperial banquet hall, high-angle bird's-eye view, symmetrical layout, elevated throne platform at the top center, large open central performance floor, exactly three small low lacquered individual banquet tables on the left and three on the right, evenly spaced, narrow rectangular tables arranged lengthwise along the hall and facing inward, exactly six floor cushions only, one single floor cushion centered directly behind each table, no extra cushions anywhere else, vermilion red columns, rich golden decorations, polished dark lacquered wooden floor, warm red and muted gold color palette, controlled warm palace lighting, medium-low exposure, restrained highlights, deeper contrast, soft warm reflections, realistic lacquered wood and aged gold texture, cinematic live-action historical drama set, dimmer interior atmosphere, clean empty hall, no people --no extra tables, extra cushions, oversized tables, round tables, chairs, harsh sunlight, overexposed windows, bright daylight, cold blue light, text, watermark --ar 16:9 --raw --stylize 45 --hd
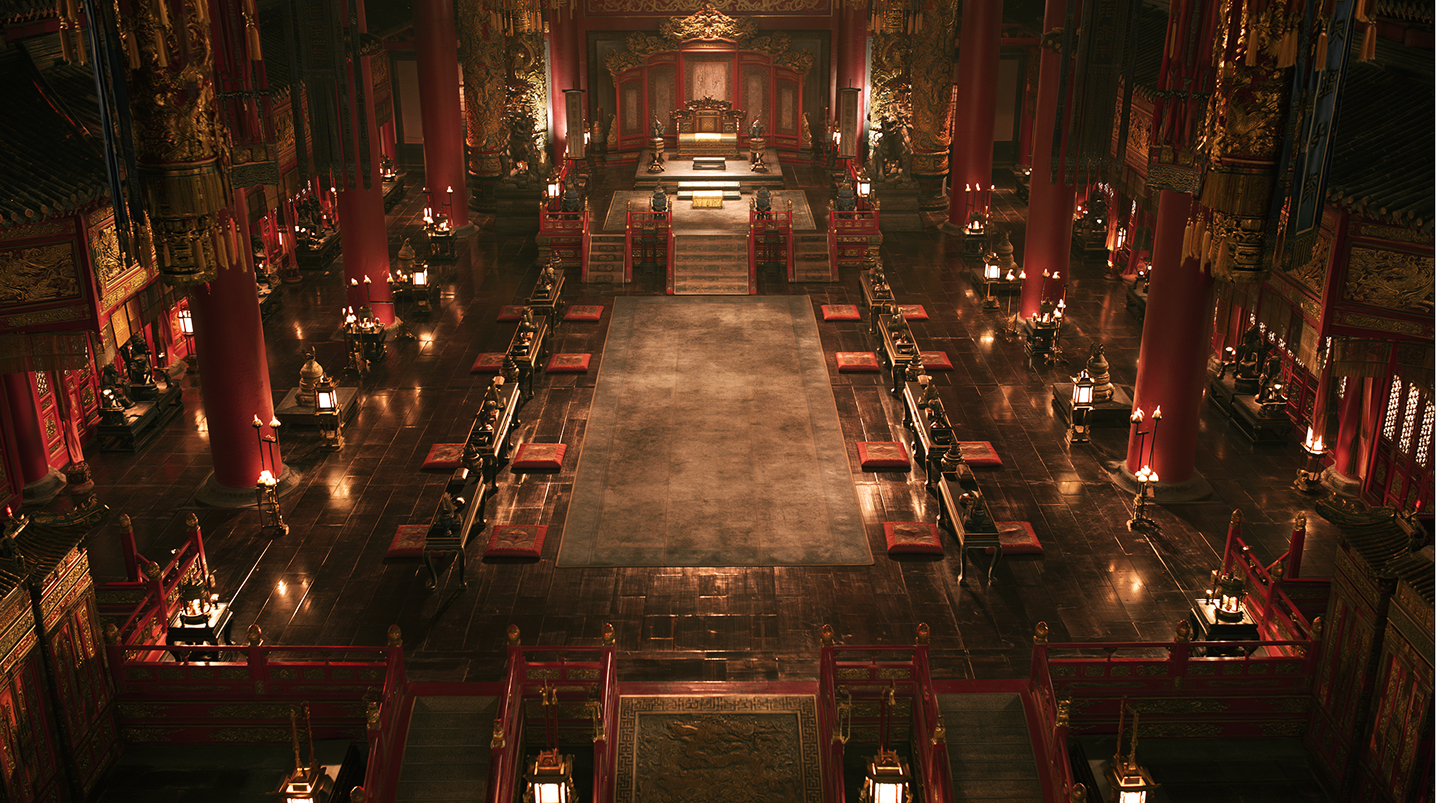
这里如果已经有自己人物和场景资产的同学,这一步就不用看了,可以直接进入后面的站位部分。
第二步:制作俯视站位图,并在 LibTV 导演台里还原人物位置
人物和场景准备完成以后,不要直接进入视频生成。
多人场景最大的难点其实已经不是:
“这个人长什么样?”
而是:
“这个人到底在哪里?”
所以在打开 LibTV 导演台之前,我会先让 ChatGPT 帮我规划一张人物场景俯视站位图。
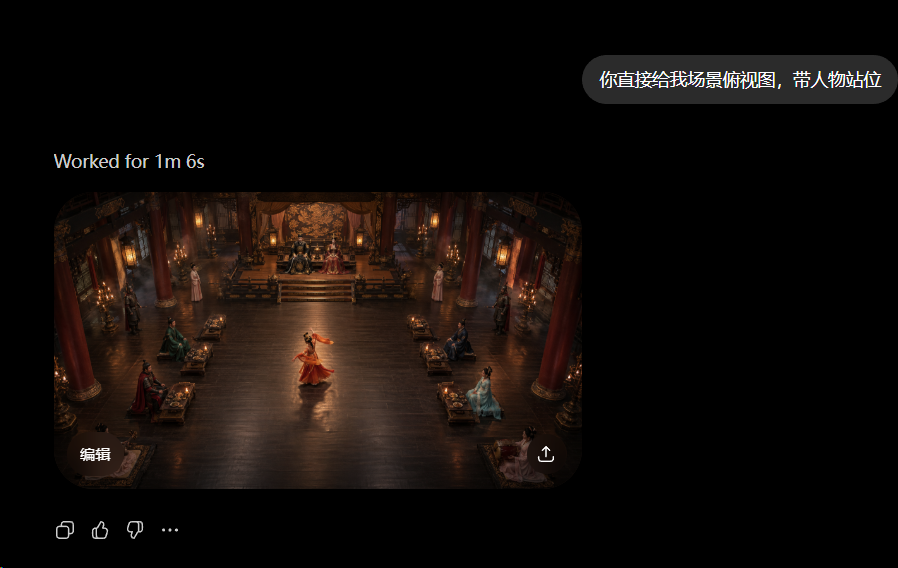
我会把这次使用的人物、人物身份以及夜宴的基本剧情告诉 AI,让它帮助我规划人物之间的空间关系。
比如这次:
皇帝与皇后位于高台主位。
两位宫女分别站在高台两侧。
左侧宾席安排两位文臣和武将。
右侧宾席安排年轻王爷和两位贵族小姐。
舞姬单独位于大厅中央表演区域。
这张图其实不需要特别漂亮,它最重要的功能就是:
把原本只能想象的人物空间关系可视化。
有了这张俯视站位图以后,我再打开 LibTV 创建导演台。
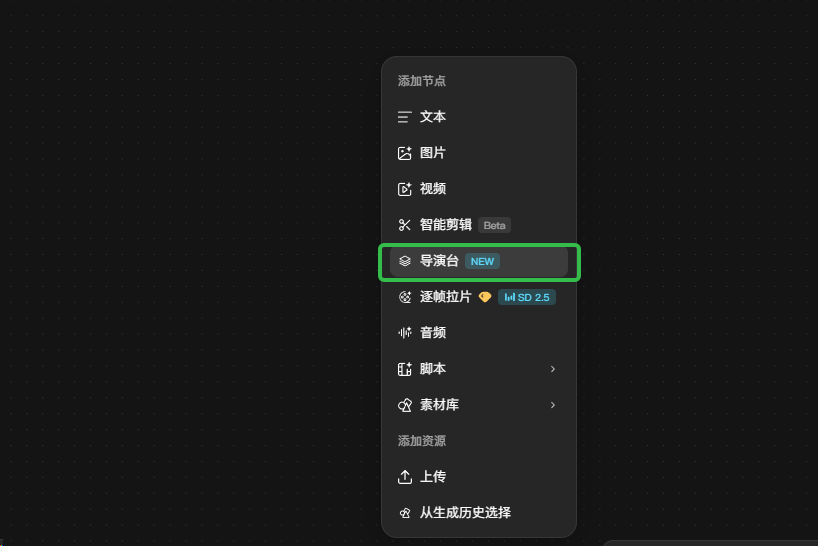
这里我一开始尝试过直接使用图片创建导演台,希望它能够自动识别我图中的人物位置。
但是实际生成出来以后会发现:
站位完全不对。
所以这部分我最后没有继续依赖自动识别,而是直接进入导演台,根据刚才的俯视站位图,一个一个手动调整人物。
主要调整几个东西:
人物的位置、人物之间的距离、人物朝向、人物坐姿,以及整体左右关系。
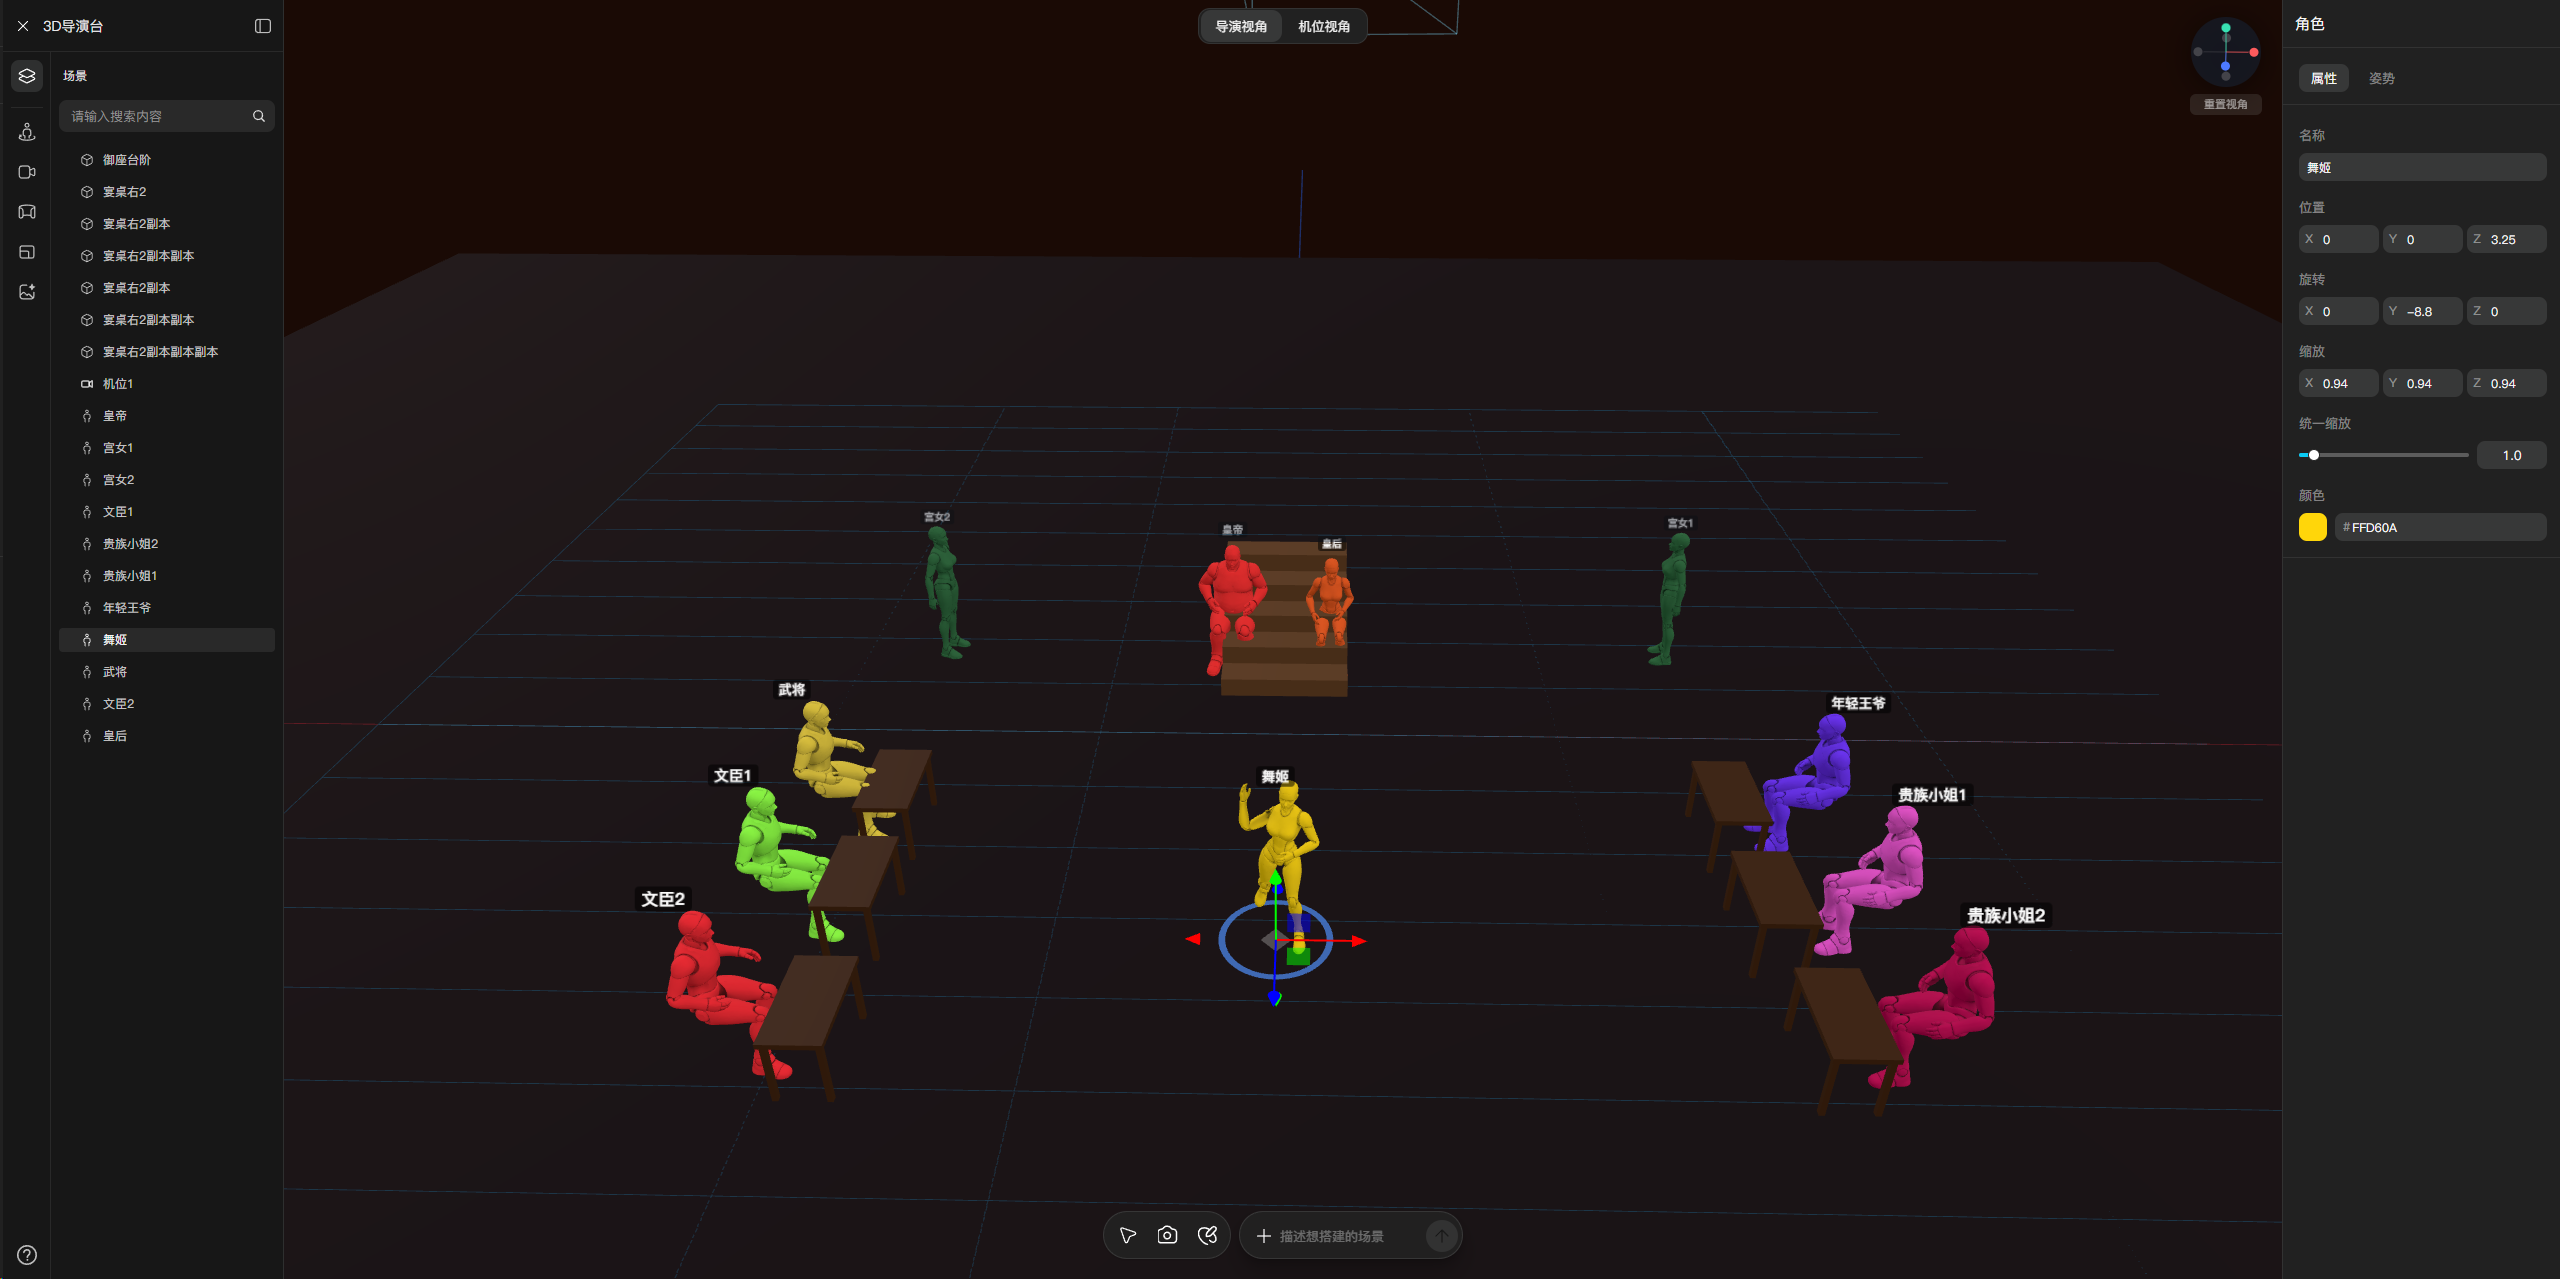
如果之前使用过 C4D、Blender、Unreal Engine 这一类3D工具的同学,这一步应该会比较容易上手。
你不需要真正制作复杂的3D动画,只需要把每个人放到正确位置。
最后你可以手动截图,也可以按按钮截图
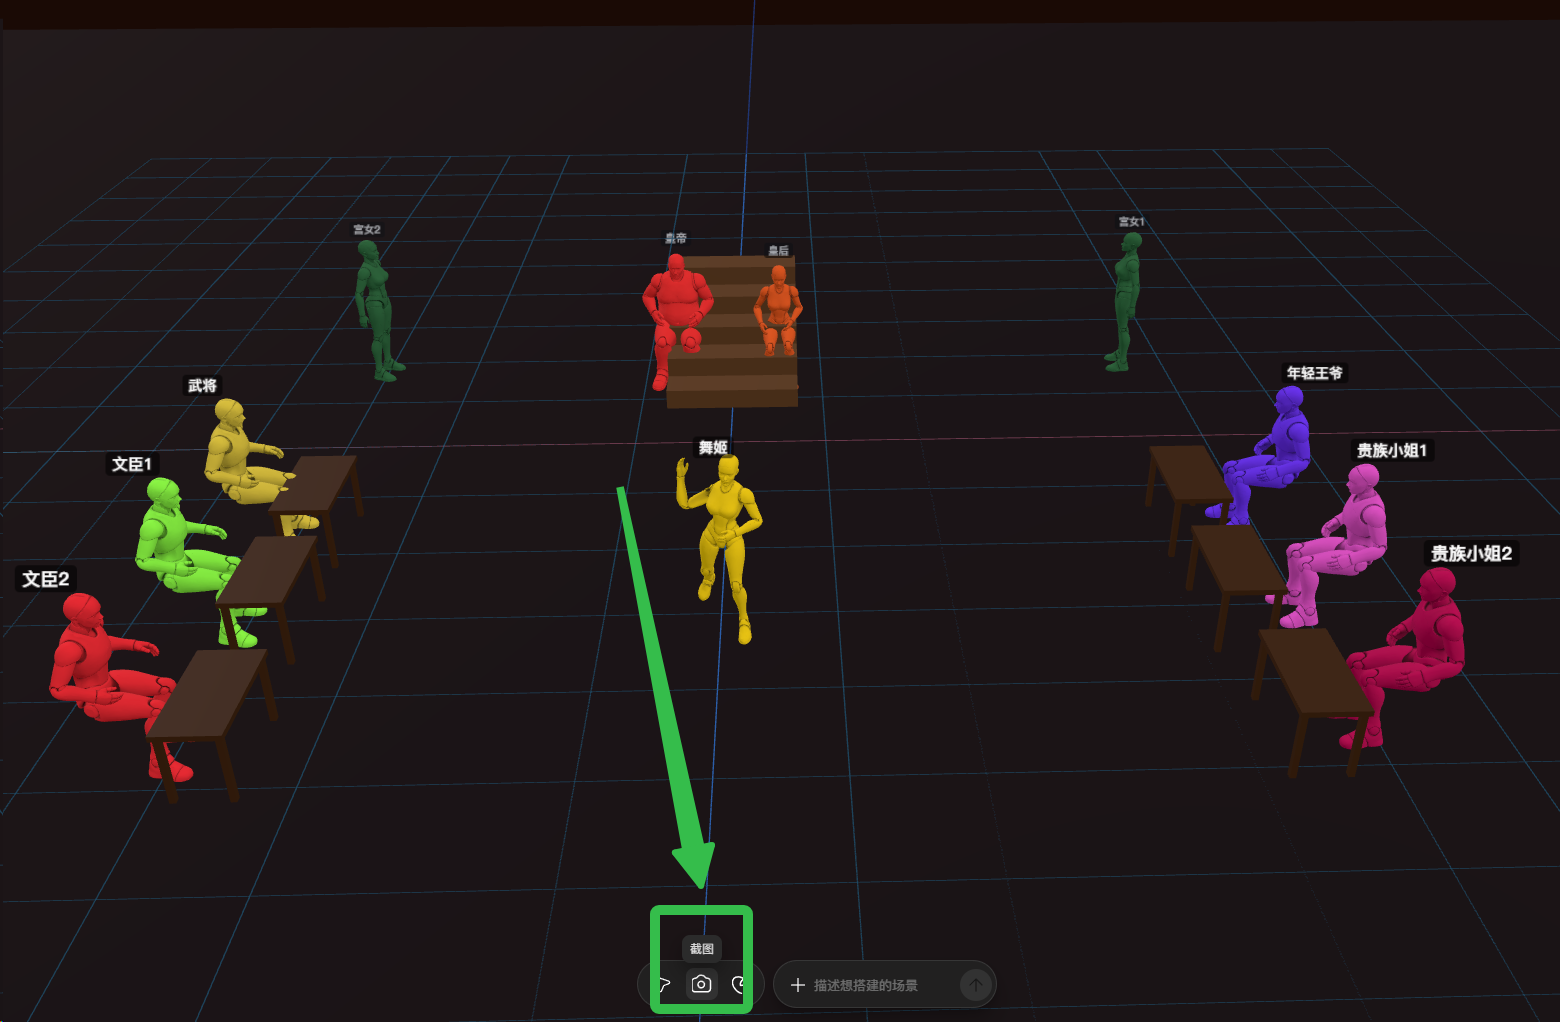
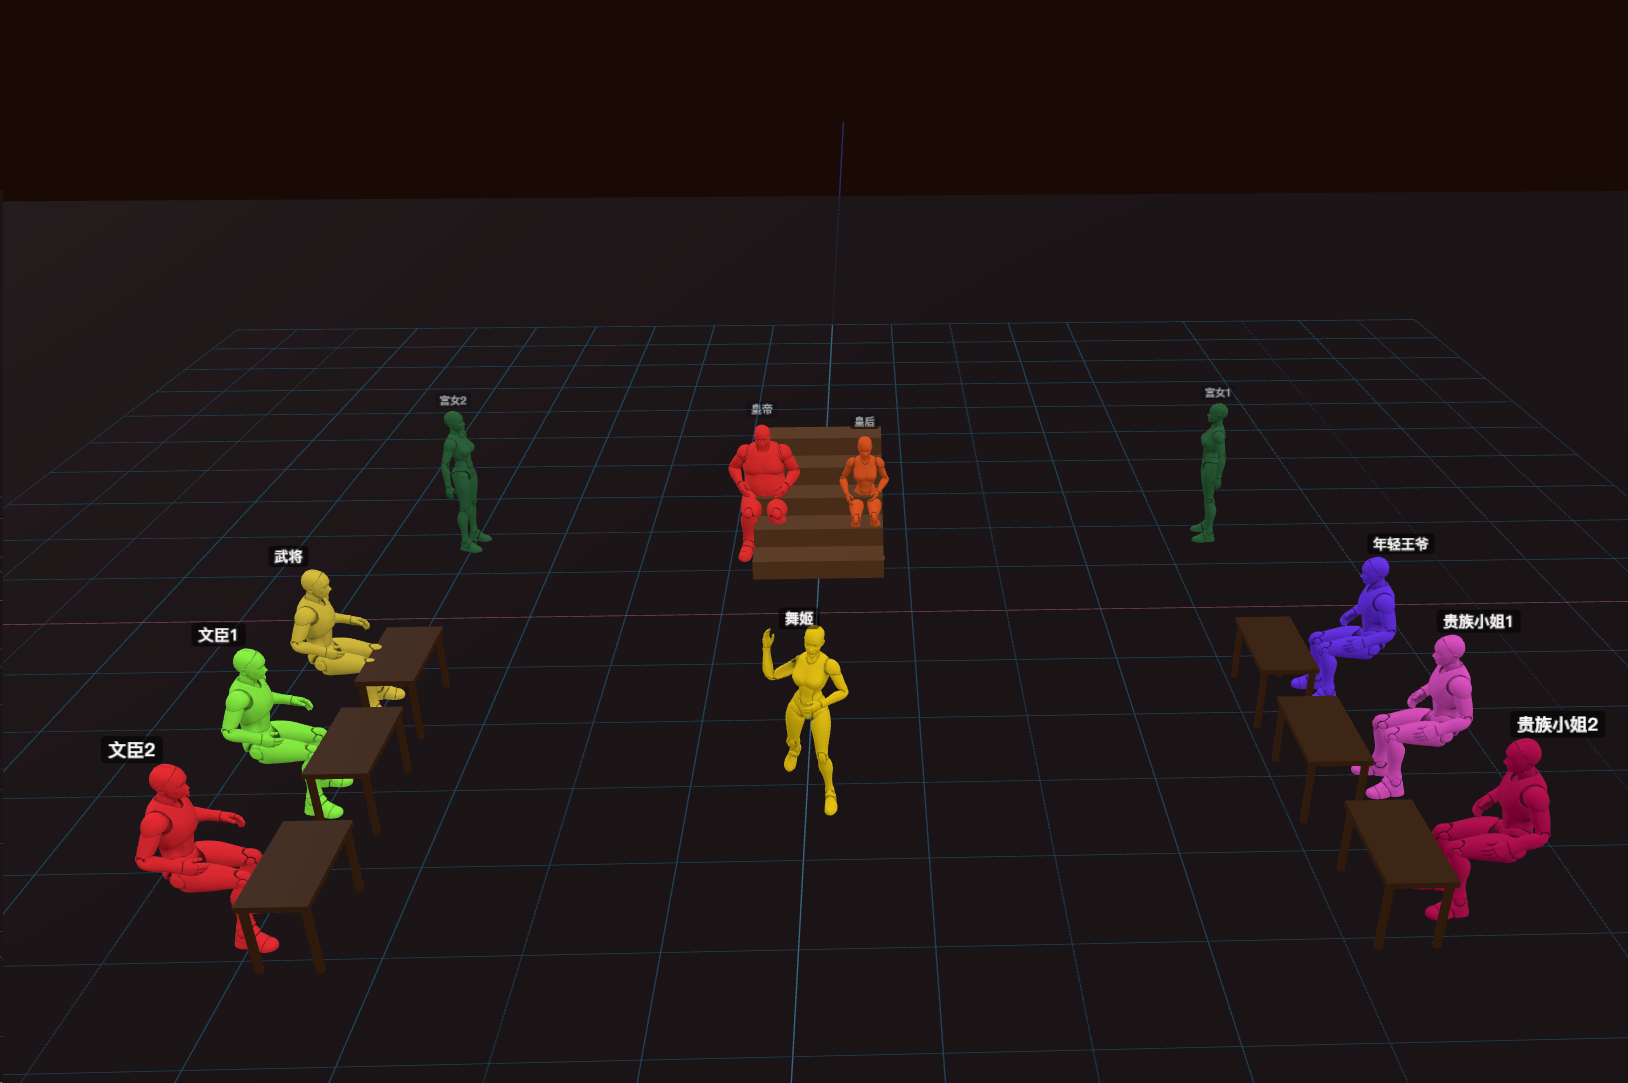
第三步:把导演台站位转换成文字空间关系
这里是这次教程里非常重要的一步。
如果场景里只有2—3个人,其实导演台导出的站位图基本已经够用了,模型通常能够比较容易地理解人物之间的位置关系。
但我这次不是2—3个人,而是整整11个人。
人物数量一多,模型需要同时记住每个人的身份、位置、朝向、坐姿以及和其他人物之间的关系,单靠一张站位图就会开始变得不稳定。
所以这次我会再增加一层文字控制:把导演台导出的图片重新交给 AI,让它分析11个人之间的空间关系,再把这些关系转换成视频提示词里的文字描述。
图片负责告诉AI“人在哪里”,文字负责进一步告诉AI“这些人之间是什么关系”。
但是我们最终生成的是一段30秒视频。
只要摄影机开始切换,模型就需要重新判断:
现在看到的是谁?这个人在什么方向?他的旁边还有谁?他和高台是什么关系?他应该看向哪里?
所以只有视觉站位图是不够的,还需要增加第二层:
文字站位控制。
我的做法是把导演台导出的图片重新丢给 ChatGPT,让 AI 去分析图中的人物空间关系。
可以用这段提示词去推导:
我会上传一张多人场景的导演台站位图,请你作为影视导演和场面调度师,准确分析图中所有人物的空间位置与关系。
这张图片只用于分析人物在整个场景中的世界空间站位,暂时不要设计镜头、不要编写剧情、不要写视频提示词。
请严格依据图片中实际可见的位置进行分析,不要自行调整人物站位,不要为了构图美观重新排列人物。
我会提前告诉你人物名称: 【人物名单:在这里填写人物名称】
请分别分析:
每个人物位于场景的哪个区域,例如中央、高台、左侧区域、右侧区域等; 每个人物是站立、坐下还是其他姿态; 如果人物坐席,说明他坐在哪一个独立桌案/座位位置; 人物身体大致朝向哪里; 人物主要面对或关注的对象是谁; 哪些人物属于同一区域,但彼此仍保持独立距离; 哪些人物相邻,哪些人物距离较远; 人物之间是否存在明显的前后、左右、高低关系; 场景中哪些区域属于人物活动区,哪些人物应该始终保持固定位置; 找出最容易在视频生成过程中发生位置混乱或人物交换的角色组合。
最后按照下面格式整理:
【全局空间结构】 简要说明整个场景的主要区域以及人物分布逻辑。
【人物站位表】 人物A:区域 + 姿态 + 位置 + 朝向 + 与其他人物的关系 人物B:区域 + 姿态 + 位置 + 朝向 + 与其他人物的关系 依次写完所有人物。
【固定关系】 列出视频生成过程中必须保持不变的人物位置关系。
【易混淆人物】 指出哪些角色最容易发生换位、身份混淆或空间漂移,并说明原因。
【视频提示词转换原则】
注意:以上分析描述的是整个场景的世界空间关系。后续真正编写某个视频镜头时,不要直接照搬“左上、左中、右下”等俯视站位描述,而必须根据该镜头的摄影机位置,重新描述人物在当前画面中的左右、远近、遮挡和同框关系,同时保证人物实际世界位置与本次分析一致。
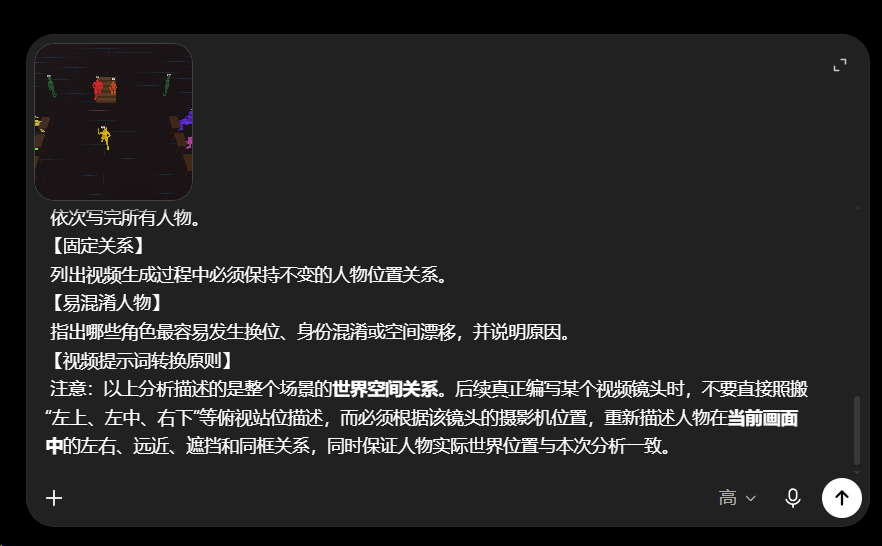
人物之间的相对距离怎么样。
每个人大概朝向什么方向。
然后让AI把这些空间关系转换成一套可以写进视频提示词里的文字描述。
这样就形成了两层控制:
导演台图片负责视觉空间参考。
提示词负责文字空间约束。
两者一起使用,要比单独依赖一张站位图稳定很多。
但这里还有一个非常容易写错的地方。
站位图中的空间描述,不能直接复制到每一个视频镜头里。
比如导演台俯视图告诉我们:
左上方是武将,左中间是文臣1,左下方是文臣2。
这是正确的。
但到了真正拍武将的时候,如果镜头已经切换成武将的中近景,你还在提示词里写:
“左上方是武将,左中间是文臣1,左下方是文臣2。”
模型就很有可能把这套俯视坐标重新理解成当前画面的构图。
这时候站位反而会被我们自己写乱。
所以这里一定要分清楚:
俯视站位图描述的是整个世界空间。
视频提示词描述的是当前摄影机看到的空间。
两者必须保持对应,但不能照搬。
比如到了武将镜头,就应该按照当前镜头去描述:
“武将坐在画面中央偏右的位置,低矮食案位于身前,同侧其他宾席在远处隐约可见。”
这才是当前摄影机真正看到的画面。
第四步:结合 Skill 生成 Seedance 2.5 的30秒视频提示词
人物、场景、导演台和文字空间关系全部准备完成以后,就可以开始真正设计视频了。
这里我会使用两个 Skill。
另外一个是 CINEDANCE Skill(点击下载)
都来源于huggsfueld
对于这次11个人的大场景,它对人物位置和第一帧空间关系的控制非常重要。
然后我会直接让 AI:
根据当前的人物站位、剧情和角色资产,生成符合 Seedance 2.5 的30秒多镜头视频提示词
这里有二个非常重要的控制点。
第一个:
第一幕一定要先把全场人物站位交代清楚。
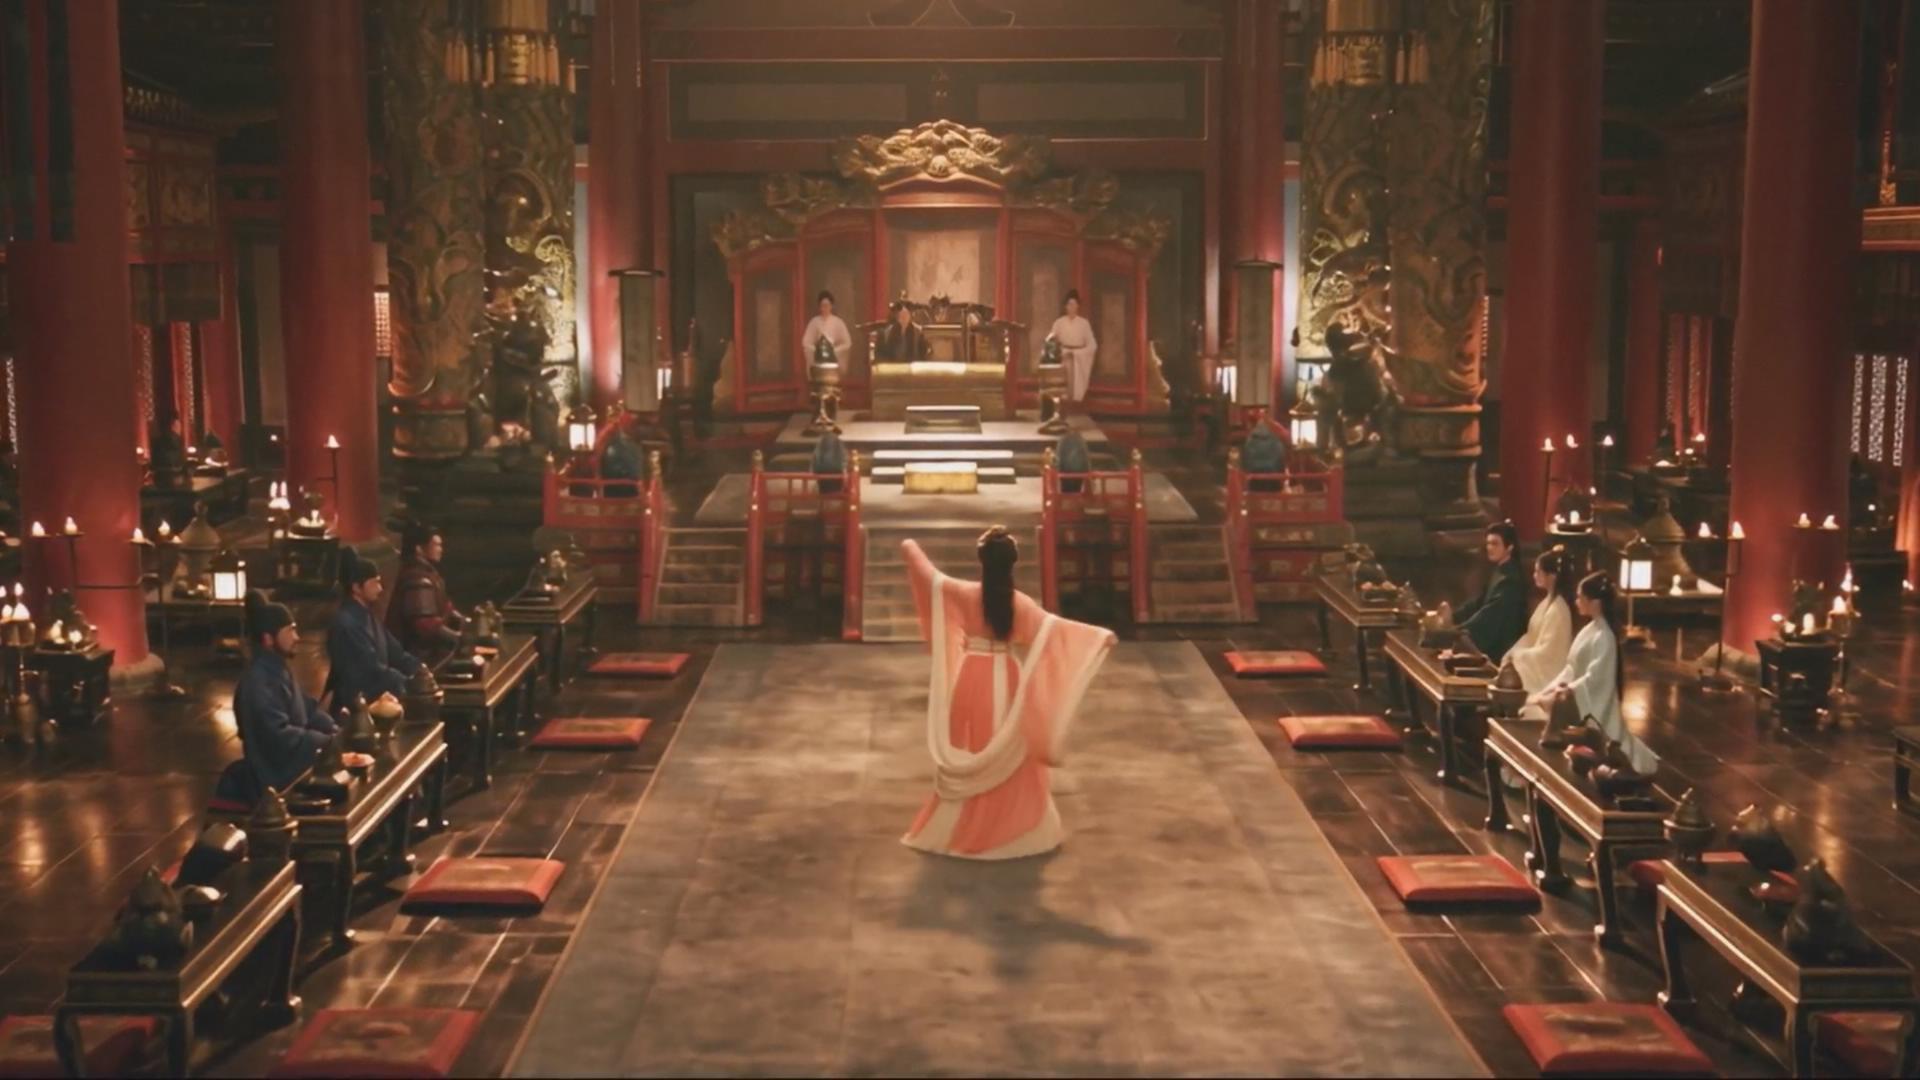
因为AI在连续生成的时候,本身具有一定的上下文延续能力。
如果第一幕人物的位置关系就已经建立准确了,后面只要视频提示词没有出现明显扰乱空间关系的描述,后面的分镜人物准确性通常会提升很多。
比如这一段,
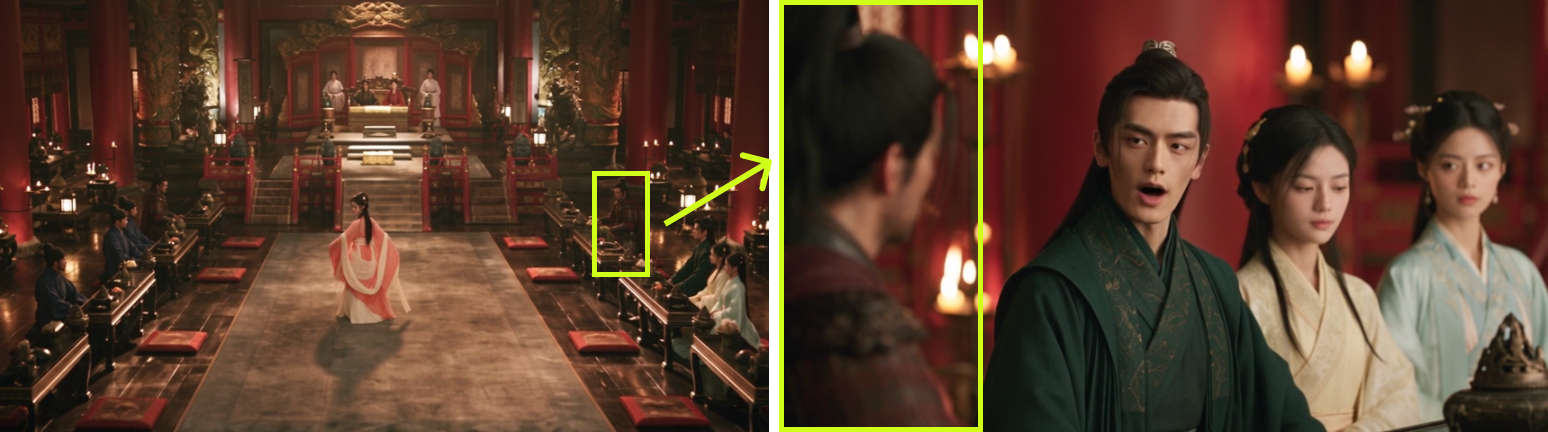
这个人物的出现就是因为第一幕也出现了
第二个:
前面提到的这句话,我会直接写进给AI的要求里:
提示词中的人物站位不要按照俯视站位图视角直接书写,而要根据当前每一个镜头的摄影机位置,重新描述人物在当前画面中的空间位置与关系,同时保证这些位置和导演台站位一致。
第五步:做好人物标注,进入 Seedance 2.5 生成
最后一步就是正式生成视频。
但是在进入生成之前,我还会再检查一次人物标注。
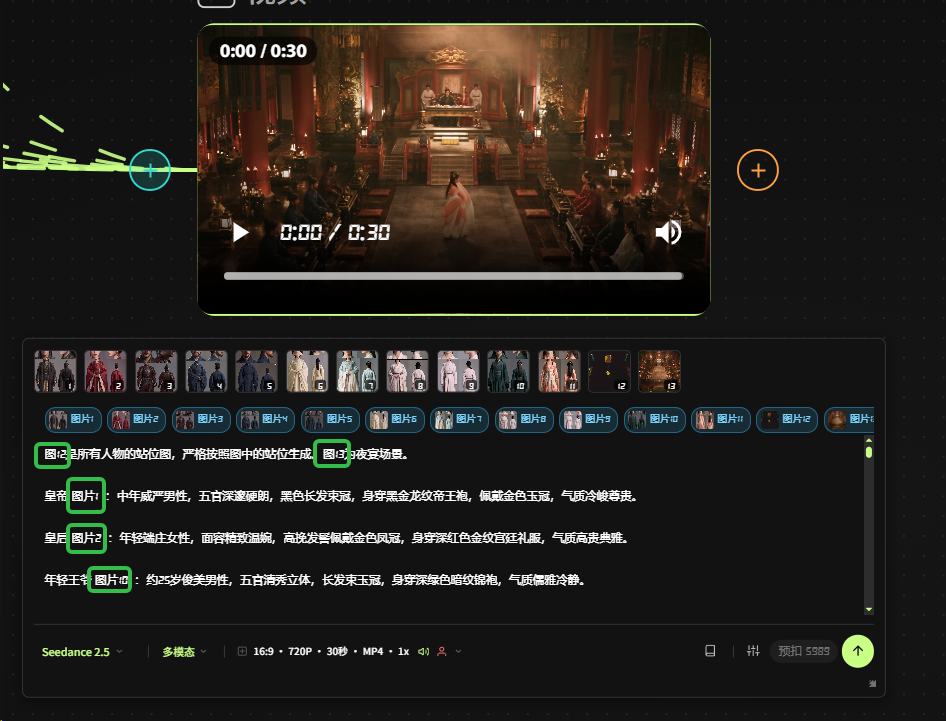
因为这次场景里有很多身份非常接近的人物:
文臣1、文臣2。
贵族小姐1、贵族小姐2。
宫女1、宫女2。
如果这些人物没有清楚的独立标注,模型很容易把两个类似身份的角色交换。
全部确认以后,再将人物资产、场景资产、导演台站位以及最终视频提示词一起用于 Seedance 2.5 生成。
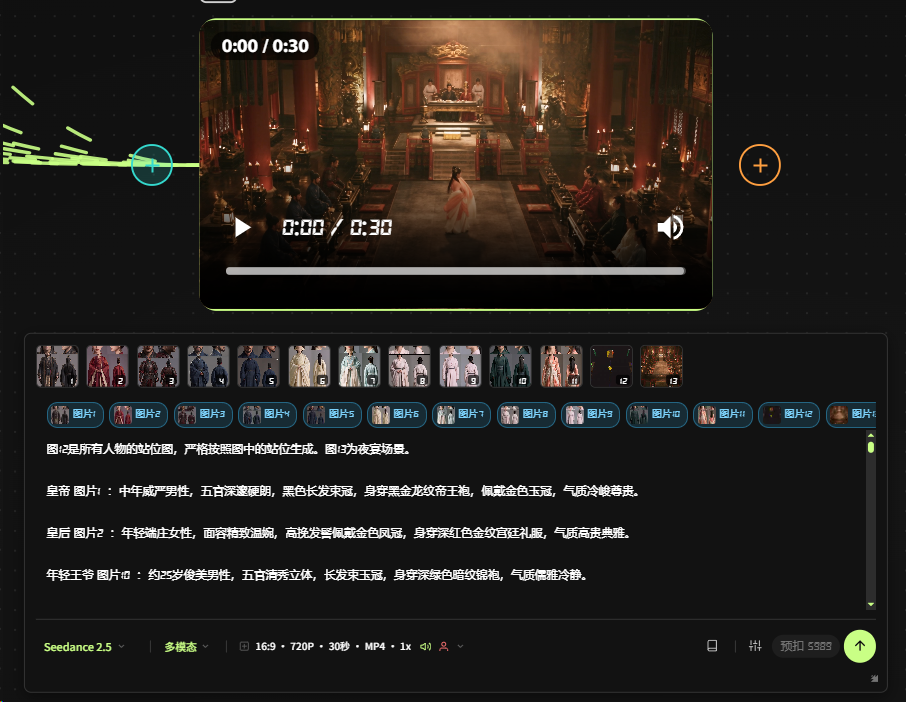
我的提示词如下:
图12是所有人物的站位图,严格按照图中的站位生成。图13为夜宴场景。
皇帝 图片1 : 中年威严男性,五官深邃硬朗,黑色长发束冠,身穿黑金龙纹帝王袍,佩戴金色玉冠,气质冷峻尊贵。
皇后 图片2 : 年轻端庄女性,面容精致温婉,高挽发髻佩戴金色凤冠,身穿深红色金纹宫廷礼服,气质高贵典雅。
年轻王爷 图片10 : 约25岁俊美男性,五官清秀立体,长发束玉冠,身穿深绿色暗纹锦袍,气质儒雅冷静。
武将 图片3 : 身材魁梧男性,轮廓硬朗带有战场痕迹,黑发束起,身穿暗红色重甲战袍,气质刚毅威武。
文臣1 图片4 : 中年儒雅男性,留短须,眼神沉稳睿智,头戴黑色官帽,身穿深蓝色官服,气质老练内敛。
文臣2 图片5 : 年轻文雅男性,面容清秀,头戴黑色官帽,身穿深蓝色宽袖官袍,气质沉静聪慧。
贵族小姐1 图片6 : 年轻贵气女性,面容精致端庄,佩戴精美金色发饰,身穿淡黄色丝绸礼服,气质温婉典雅。
贵族小姐2 图片7 : 年轻清丽女性,五官柔美精致,佩戴玉石发饰,身穿浅青色刺绣华贵汉服,气质清雅高贵。
宫女1 图片8 : 年轻秀丽女性,发髻简洁,无华丽装饰,身穿浅粉色宫女服,气质安静恭敬。
宫女2 图片9 : 年轻清秀女性,低挽发髻,身穿浅粉色素雅宫装,气质温顺谨慎。
舞姬 图片11 : 年轻柔美女性,面容清丽,长发搭配精致发饰,身穿粉白渐变飘逸舞裙,气质灵动优雅。
【氛围与质感】: 盛大古代宫廷夜宴,庄重华贵,暖烛光与轻微烟雾,朱红、暖金、深棕色调,琥珀色暖光,压制高光,ARRI Alexa Mini LF,Cooke Panchro/i 32mm,T2.8,柔和电影曝光,真人古装电影质感,真实漆木、旧金属与丝绸织锦纹理,轻微胶片颗粒,Black Pro-Mist 1/8。
【画面内容】 古代中国宫廷夜宴场景,多人物群像对话戏。 镜头1夜宴群像建立镜头。镜头从大厅中央偏后位置开始,略高于人物视线,广角群像构图。严格还原图片12 的人物站位,注意图中的人物名称与参考人物对应。 画面中央是正在缓慢起舞的舞姬;皇帝 图片1坐在高台左侧主位。皇后图片2 坐在高台右侧主位。 两名宫女图片8 图片9分别站立在高台皇帝与皇后的左右两侧,保持侍立姿态。 大厅左侧为宾席区域: 左最前方是武将文臣1图片3、左中方文臣1图片4 、左下方文臣2图片5(只有三个人)。 三人分别坐在独立低矮食案后,三张食案之间保持明显间隔,不形成连续席位。
大厅右侧为宾席区域: 右侧最后方年轻王爷图片10、右中方贵族小姐1图片6 、右下方贵族小姐2图片7(只有三个人)。
镜头缓慢向前推进,舞姬图片11在大厅中央,舞姬位于中央区域表演。轻轻旋身,衣袖展开,皇帝皇后端坐不动,两侧宾客保持坐姿,目光落向中央。 重点表现整个宴厅的空间秩序、中央表演区与高台主位、左右宾席之间的关系。 镜头2
皇帝发问镜头。 镜头切到高台中景。 皇帝位于画面左侧主体位置,皇后坐在画面右侧,与皇帝保持并列关系;两侧宫女分别站在画面左右边缘稍后位置。 皇帝保持坐姿,缓慢转头看向画面外左前方的武将方向,停顿后开口: “听说……你没等军令,就出兵了?” 皇后不说话,只安静观察皇帝的反应。 镜头以皇帝为主要视觉中心,但保留皇后和宫女,确保主位关系清楚。 镜头3
武将回应镜头。 镜头切到左侧宾席中近景。 武将坐在画面中央偏右位置,低矮食案位于他身前;画面左上或左侧远处可以隐约看到同侧其他席位的一部分,但不作为主体;背景保持宫殿空间连续。 武将先低头停顿,随后抬起目光,身体微微前倾,双手抱拳说道: “再晚一夜,那座城便守不住了。” 他的动作克制而坚定。 镜头核心是武将本人, 镜头4
王爷回应镜头(此时不要出现武将)。 镜头切到右侧宾席中近景。 年轻王爷位于画面中央偏左位置,坐在自己的食案后;画面右侧可以带到同侧贵族小姐席位的一部分轮廓,但不抢主体。 年轻王爷先看向前方,随后看向左侧画面外,短暂停顿后说道: “城若丢了,要花的可就不止这些粮。” 两位贵族小姐保持坐姿,只作为安静的陪衬存在,通过轻微视线变化参与气氛。
镜头5 皇后缓和气氛镜头。 镜头回到高台双人关系镜头。 皇后位于画面右侧更清晰的位置,皇帝位于画面左侧。两位宫女仍然在更外侧边缘侍立。 皇后先看向皇帝,然后平静地说: “城守住了,人也回来了。” 停顿一拍。 “陛下还要罚他吗?” 皇帝不立即回答,只微微转动视线,从左侧宾席方向移向右侧宾席方向,保持沉默。 这个镜头重点是皇后与皇帝之间的气氛变化。 镜头6
皇帝举杯反转镜头。 镜头继续保持在高台区域,不切远景。 皇帝位于画面左侧主体位置,皇后位于右侧;宫女仍然站在更外侧边缘。 皇帝沉默片刻,缓缓拿起酒杯,低声说: “罚。” 停顿两秒。 皇帝露出极淡的笑意,接着说: “罚他陪朕,再饮三杯。” 随后轻轻举杯。 画面不切换,通过同一镜头中的人物表情和动作完成反转;远处宴厅其余人物不需要明确展示,只需通过气氛让观众感到全场都在等待这个结果。 这个镜头重点是皇帝的控制感、停顿和反转。
表演要求 所有人物表演自然克制,不做夸张情绪。 角色要先听、再判断、再反应、最后说话。 皇帝始终是控制全场的人,动作最少;武将在压力下保持坚定;王爷的发言带有年轻权贵的果断;皇后以平静方式改变气氛;贵族小姐、宫女和舞姬都不抢戏,只辅助建立夜宴氛围。 ---
## 摄影
电影级古装历史剧质感。
ARRI Alexa Mini LF, Cooke Panchro/i 40mm。
稳定电影运镜: 缓慢推进, 轻微横移, 中景与近景切换。
不要快速切换。 不要改变人物空间关系。
音频 人物对白清晰自然。 保留宫殿空间回响、轻微衣料摩擦声、酒杯轻响、舞袖带动空气的声音、极轻的宫廷乐声。 不要旁白,不要字幕,不要强背景音乐。
这次最终做出来的是一段大约30秒的宫廷夜宴群像戏。
在视频里,第一幕首先建立完整的多人空间,随后才逐渐进入皇帝、武将、年轻王爷和皇后的对话。
而人物在不同镜头之间,基本还能够保持最初建立的空间关系。
当然,11个人确实已经是一个比较夸张的数量。
这次做完最大的感受就是:
两三个人的时候,我们控制的是人物。
十几个人的时候,我们真正控制的是空间。
而 LibTV 导演台其中一个非常适合的使用方法,就是把以前只能依靠提示词想象的人物位置,提前变成一个可以看到、可以调整、可以验证的空间布局。
视频生成执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课不是先追求炫技成片,而是围绕「刺猬星球super-i_AI教程免费在线教学」先把主体、动作、镜头和节奏稳住。
按原文节奏走最稳:先吃透「准备工具」,再把「这次要解决什么问题?」定住,接着处理「第一步:准备人物与场景资产」;最后用「第二步:制作俯视站位图,并在 LibTV 导演台里还原人物位置」收口。
- 先把「准备工具」里的主体和动作定死。
- 先把「这次要解决什么问题?」提到的误区排掉,别踩同一坑。
- 做完「第一步:准备人物与场景资产」后,先查连贯性和穿帮。
- 先把「第二步:制作俯视站位图,并在 LibTV 导演台里还原人物位置」里的主体和动作定死。
- 这一段重点看镜头和节奏,别急着炫技。
- 把「第四步:结合 Skill 生成 Seedance 2.5 的30秒视频提示词」整理成可复制版本,后面直接复用。
不要一上来就生成最终片;先拆镜头、定主体和运动,再逐段生成,否则容易跳轴、穿帮、节奏混乱。
检查主体是否稳定;镜头运动是否明确;前后画面是否连贯;节奏是否服务主题;是否有明显变形或穿帮。
请围绕「刺猬星球super-i_AI教程免费在线教学」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:核心创意、分镜表、每个镜头的画面描述、视频生成提示词、剪辑顺序和成片自检清单。要求主体稳定、动作明确、镜头连贯。